2.3 逻辑计划与优化规则
2.3 逻辑计划与优化规则
本节摘要:逻辑计划是一棵由 TableScan、Filter、Select、Join、GroupBy 等算子组成的树,优化器的职责是在不改变查询含义的前提下改写这棵树,让同样的语义以更小的代价执行。本节逐条拆解谓词下推、列裁剪、分区裁剪、Map 端聚合四条核心规则,每条都配 EXPLAIN 前后对比作为证据。
算子树:优化的画布
语义分析交付的查询块被转换成一棵算子树。这棵树的节点是标准化的计算单元:
- TableScan:从表(实际是 HDFS 目录里的文件)读出行;
- Filter:按谓词丢弃行;
- Select:投影,削减列;
- Join:按连接键拼接两棵子树的输出;
- GroupBy:按键分组聚合;
- ReduceSink:给下游 Reduce 阶段准备数据——打分区键、排序键,是"要过网络"的标志。
未经优化的树忠实地按你书写的顺序执行,而这顺序往往很贵:先 JOIN 再过滤,意味着本来会被丢弃的行也要参与网络传输。优化器的工作就是把"贵但等价"的顺序改成"便宜且等价"的顺序。
举一个贯穿本节例子。订单表 orders 与客户表 customers 做连接,只要北方区域、只要两列输出:
SELECT o.order_id, c.customer_name FROM orders o JOIN customers c ON o.customer_id = c.customer_id WHERE o.region = 'north' AND o.dt = '2026-01-15';
谓词下推:把过滤推到离数据最近的地方
字面书写顺序是"先连接、后过滤"。优化器的改写是:region 是 orders 表的列,过滤条件不依赖连接结果,那就可以先过滤 orders 再连接。执行顺序变成"先过滤、再连接",参与 Shuffle 与 Join 的行数骤减。
谓词下推前后的算子树对比
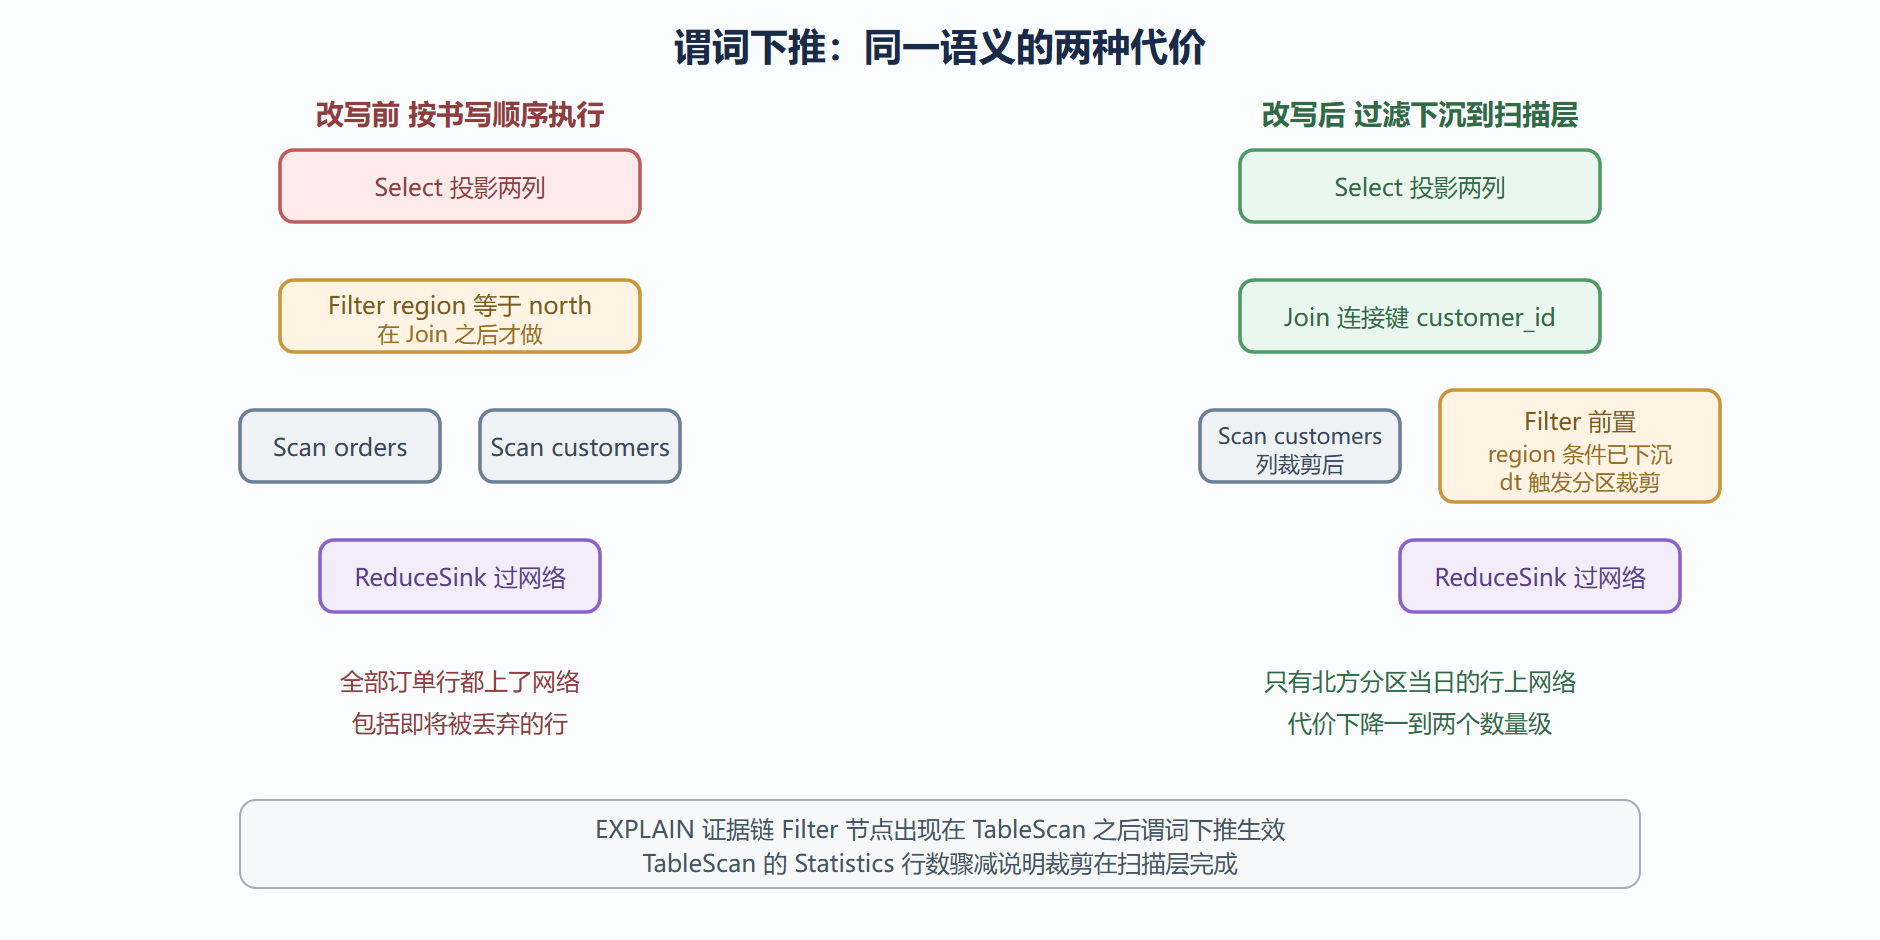
EXPLAIN 的证据这样读(节选):
Map Operator Tree: TableScan alias: o Statistics: Num rows: 1200 Data size: 96000 Filter Operator predicate: (region = 'north') (type: boolean)
Filter 紧贴 TableScan 出现,谓词在 Map 端扫描时执行——下推成功的标志。反过来,如果你看到 Filter 出现在 Join 算子之后、或者出现在 Reduce 端算子树里,说明这个谓词没有被推下去,就要查原因了(常见原因:谓词引用了 JOIN 之后才产生的计算列,或写在了 JOIN 条件无法关联的一侧)。
谓词下推有一条重要边界:只引用单侧输入列的谓词才推得动。o.region = 'north' 只依赖 orders,可以推;o.amount > c.vip_threshold 依赖两侧,只能留在 Join 之后。理解这条边界,写 SQL 时就会自觉把能单侧过滤的条件写成单侧。
列裁剪:不读用不到的列
列裁剪规则回答的问题是:查询最终只输出两列,中间算子真的需要携带八十列吗?优化器从树的顶端(输出列)向下推导每个算子真正需要的列集合,把不需要的列在下推路径上尽早裁掉。
对行式存储(TextFile),列裁剪省的是序列化与网络;对列式存储(ORC、Parquet),它直接省磁盘读取——没被引用的列根本不从磁盘读。同一规则,存储格式不同,收益天差地别,这是第 7 章"列存红利"的伏笔。
EXPLAIN 里的证据是 Select Operator 的 expressions 列表只含被引用的列。顺带一个纪律:查询加速的第一 habit 不是加参数,而是把 SELECT 星号改成显式列清单——星号让裁剪器无刀可下。
分区裁剪:最便宜的优化
dt 条件没有变成 Filter 算子,而是变成了扫描清单的收缩。语义分析阶段,Driver 就拿着 dt 等值条件去 Metastore 查分区清单,把"扫全表"换成"扫一个子目录"。EXPLAIN 证据:
TableScan alias: o Statistics: Num rows: 1200 ... partitions: partition values: dt = 2026-01-15
分区裁剪的代价近乎为零——目录没被打开,谈何读取。但要触它有个前提:谓词必须写在分区列上,且形式要能被静态或动态推断。等值与范围条件都能裁剪;对分区列套函数(比如 substr(dt, 1, 7) 等于某值)会让裁剪失效,全表扫描照旧——这是数仓 SQL 审计的高频红牌。第 4 章讲分区设计时会给出完整的反模式清单。
Map 端聚合:GroupBy 一分为二
第四条规则针对聚合。朴素的 GroupBy 翻译是:Map 端打标签,全部原始行过网络,Reduce 端按键分组聚合。优化器把它拆成两段:Map 端先做本地预聚合(hash 模式),把同键的行压成"部分聚合值",再过网络;Reduce 端做最终合并(mergepartial 模式)。
假设一亿行数据、一万种分组键。不拆段,网络传输一亿行;拆段后,每个 Map 任务本地先压缩,网络上跑的大约是"任务数乘键数"量级的部分结果,通常缩小百倍以上。第 1 章 EXPLAIN 里那对 mode hash 与 mergepartial 标记,就是这条规则留下的指纹。
触发它有个开关族(hive.map.aggr 系列,默认开启),极端高基数分组(键数接近行数)下预聚合本身成了负担,此时反而要关掉——这个例外场景第 6 章结合倾斜治理细讲。
规则的边界与 CBO 的引入
四条规则都是"if 条件 then 改写"的确定性规则,优点是可预测、可解释,缺点是没有代价意识。规则知道谓词能推,但不知道推了之后是否真的更便宜;知道 Join 能转 MapJoin,但不知道小表到底多小才算小——传统上靠 hive.auto.convert.join.noconditionaltask.size 一个字节数阈值拍脑袋。
当查询复杂到多表连接的连接顺序选择(三表 JOIN 有多种顺序,代价差几十倍不稀奇),规则优化器只能按书写顺序硬编。这就轮到基于成本的优化器 CBO 出场:它借助 Metastore 里的统计信息(行数、唯一值数、数据大小)给每种候选计划估算代价,挑便宜的。第 7 章会把 CBO、向量化一起讲。在那之前,第 3 章先看逻辑计划如何被切成物理任务、在引擎上跑起来。
本节要点回顾
- 算子树是画布:逻辑计划由 TableScan、Filter、Select、Join、GroupBy、ReduceSink 组成,优化即改写;
- 谓词下推:单侧谓词推向扫描层,EXPLAIN 看 Filter 与 TableScan 的相对位置;
- 列裁剪:从输出列反推所需列集合,列存格式下直接省磁盘 IO;
- 分区裁剪:谓词换算成目录清单收缩,零代价,但对分区列套函数会失效;
- Map 端聚合:GroupBy 拆成 hash 与 mergepartial 两段,网络量降百倍,高基数分组例外;
- 规则无代价意识:连接顺序等复杂决策交给第 7 章的 CBO。