1.4 AI七十年:三次浪潮与两次寒冬
1.4 AI 七十年:三次浪潮与两次寒冬
本节摘要:人工智能自 1956 年达特茅斯会议得名至今经历了三次浪潮与两次寒冬:符号主义时代因常识推理瓶颈陷入第一次寒冬,专家系统时代因知识获取与维护成本陷入第二次寒冬,统计学习与深度学习则借大数据与 GPU 算力开启当前繁荣。本节按时间轴复盘每个阶段的代表成果、失败原因与转折条件,帮助读者建立对技术成熟周期的历史感——判断一项技术的当下位置,比追逐它的热度更有价值。
阅读收获
阅读完本节,你应当能够:
- 按时间顺序说出 AI 发展的六个主要阶段及其代表成果;
- 解释两次 AI 寒冬各自的触发原因;
- 说明联结主义(神经网络路线)为何两度沉寂又两度复兴;
- 分析当前深度学习浪潮的三大支柱及其可持续性;
- 用历史视角评估一项新 AI 技术的成熟度。
一、为什么值得一节历史课
不夸张地说,AI 史就是一部"承诺与兑现的落差史"。1958 年《纽约客》就报道过感知机,媒体宣称"不久的将来机器能走、能说、能看、能写、能自我复制并意识到自身的存在"——六十年后这些仍未全部兑现。理解这段历史的价值在于校准预期:当今天再有媒体说"通用人工智能五年内到来"时,你知道该打几折。
同时,历史解释了技术路线的选择逻辑。为什么神经网络在 1970 年代与 1990 年代两度被打入冷宫,却在 2012 年后一统江湖?不是理论突变,而是资源条件变了。这种"算法等待基础设施"的模式,在你评估任何新技术时都适用。
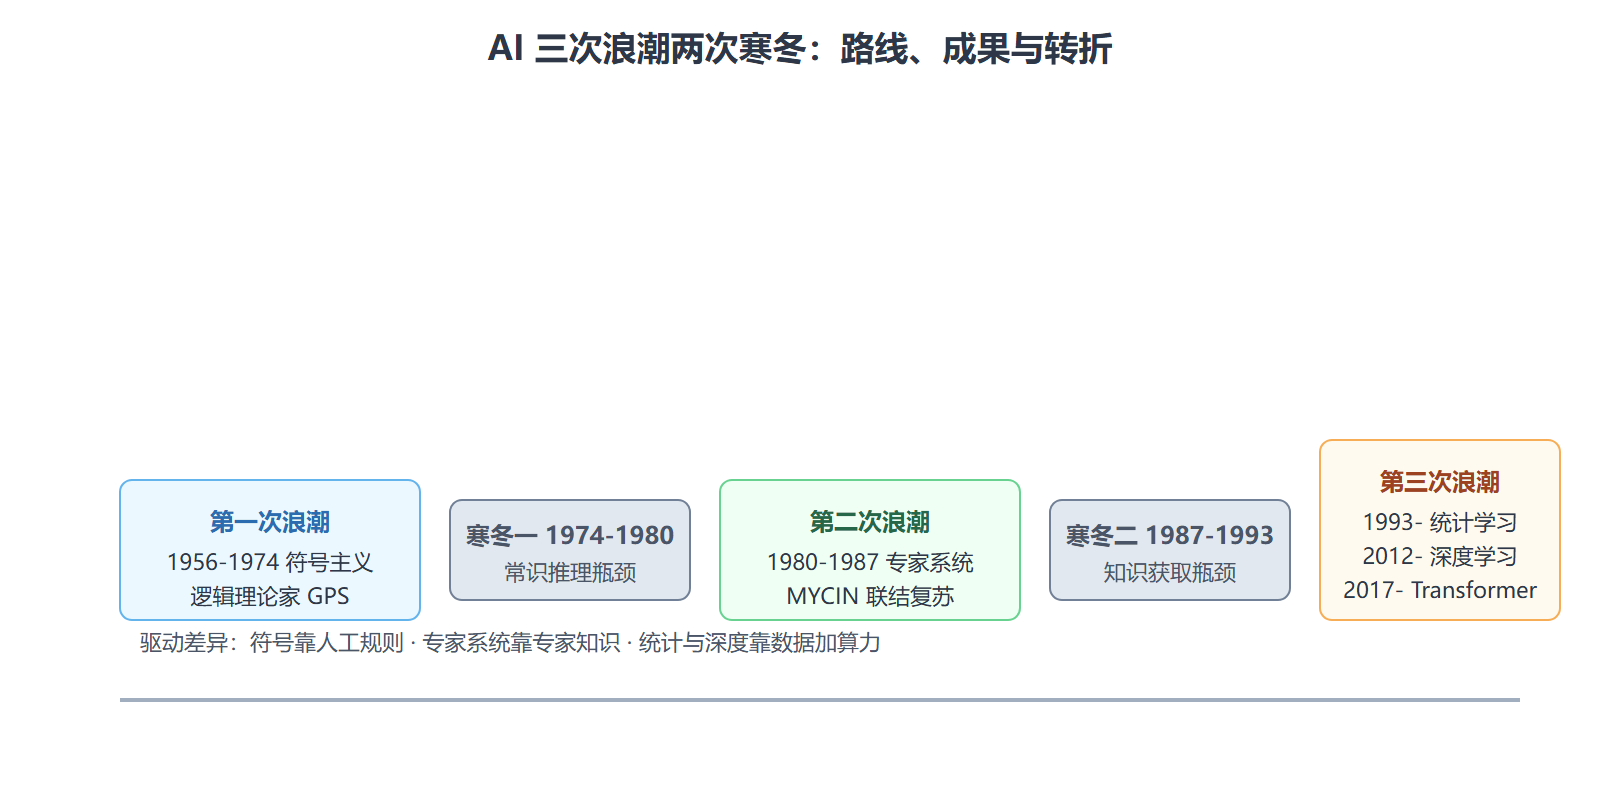
图:三次浪潮与两次寒冬对比矩阵
二、第一次浪潮与第一次寒冬(1956-1980)
1956 年夏天的达特茅斯会议上,麦卡锡、明斯基等人首次使用"人工智能"这个词,学科正式诞生。随后的近二十年是符号主义的天下:研究者相信智能可以被形式化为符号的逻辑操作。"逻辑理论家"程序能证明数学定理,"通用问题求解器"(GPS)试图给出万能的问题求解框架,感知机也在 1957 年由 Rosenblatt 提出,神经网络的前身第一次登场。
但瓶颈很快显现:组合爆炸让搜索空间失控,机器翻译的质量令人失望,最致命的是常识知识难以形式化——"人移动身体所以椅子也会被推开"这类三岁小孩都懂的事,写成规则就是一个无底洞。1973 年英国著名的报告严厉批评 AI 研究未能兑现承诺,各国经费大幅削减,第一次寒冬到来。感知机也在此期间被指出无法解决异或问题这类线性不可分情形,联结主义随之沉寂。
三、第二次浪潮与第二次寒冬(1980-1993)
1980 年代专家系统带来了第一次商业化:MYCIN 用于血液感染诊断,其知识库由数百条"如果-那么"规则构成,在专业领域表现出实用价值,各企业纷纷投入。同一时期,1986 年反向传播算法被系统推广,多层神经网络重新可训练,联结主义复苏。
好景不长的原因依旧是成本结构:专家系统的规则要靠知识工程师逐一访谈领域专家来获取——知识获取瓶颈让系统扩张的成本线性甚至超线性增长;规则之间还会互相冲突,维护费用高企。当专用硬件市场崩塌、维护成本压垮预算,第二次寒冬降临。
四、统计学习的静默革命(1990-2012)
寒冬期里,另一条路线在安静生长:统计机器学习。支持向量机、决策树、贝叶斯网络、集成方法在 1990 年代成熟,它们不再依赖人工规则,而是依赖数据与统计理论。1997 年深蓝击败国际象棋世界冠军卡斯帕罗夫,靠的主要是搜索与评估而非学习,但让公众重新看到了机器智能的可能性。这一时期的哲学转变可以用一句话概括:从"告诉机器怎么想"变成"给机器例子让它自己归纳"。
五、深度学习浪潮(2012 至今)
三个条件在 2012 年前后凑齐,引爆了当前浪潮:
2012 年 AlexNet 在 ImageNet 图像识别竞赛中以显著优势夺冠,是深度学习时代的标志性事件;2016 年 AlphaGo 击败围棋世界冠军李世石,向公众宣告强化学习与深度网络结合的威力;2017 年 Transformer 架构提出后,注意力机制从机器翻译扩散到几乎全部领域,最终催生了今天的大语言模型与生成式 AI 应用。
六、历史给工程者的三条启示
| 历史规律 | 内容 | 对当下的应用 |
|---|---|---|
| 承诺周期 | 每次浪潮都伴随过度承诺,兑现滞后十年计 | 对"即将取代人类"的说法保持折扣 |
| 资源依赖 | 算法突破常等待基础设施成熟 | 评估新技术先问数据与算力从哪来 |
| 路线轮回 | 符号与神经两条路线交替主导 | 神经符号结合是当前研究热点,不奇怪 |
用 ASCII 收束这条时间线:
1956 达特茅斯 ──符号主义──> 1974 寒冬一 ──专家系统──> 1987 寒冬二 │ 1990s 统计学习静默积累 <────────────────────────────────┘ │ 2012 AlexNet ──> 2016 AlphaGo ──> 2017 Transformer ──> 生成式AI
💡 关键直觉:两次寒冬的直接死因都是"维护成本压垮价值"。今天评估大模型落地项目时,同样要算长期运维账——推理成本、数据更新、漂移监控,而不只是首轮训练的费用。
⚠️ 常见坑:以为深度学习"取代"了传统机器学习。事实上梯度提升树至今统治表格数据任务,两代技术在工程中并存互补,第二章会详细讲这条分界线。
七、被历史验证过的三个判断框架
框架一:问"瓶颈在哪个资源"。 每次浪潮停滞都是某个关键资源见顶:第一次寒冬卡在知识获取的人力,第二次卡在算力与维护成本,今天的潜在约束则是高质量数据与能源。看到一项新技术宣传"突破"时,先定位它松开了哪个瓶颈、还压着哪个瓶颈,成熟度判断就完成了一半。
框架二:区分能力演示与生产可用。 深蓝赢棋到搜索技术进生产隔了近十年,AlphaGo 到强化学习规模化落地也远慢于公众想象。演示环境是受控的、可无限试错的;生产环境是开放的、错误的代价是真金白银。历史上每次从"惊艳演示"到"可靠产品"的距离,都值得在规划里预留数年。
框架三:留意曲线的形状而非位置。 一项技术处在 hype 顶点还是低谷,不如它的"斜率"重要——底层能力是否在稳定复利积累。统计学习在寒冬期默默积累,最终接住了互联网数据红利;同理,今天看似降温的方向里也可能埋着下一个周期的主力。
常见问题
为什么神经网络被"发明"这么早却这么晚才成功? 1943 年就有神经元数学模型,1957 年就有感知机,但训练多层网络需要的三样东西——可扩展的反向传播实现、大规模标注数据、并行算力——直到 2010 年代才凑齐。技术idea可以领先基础设施五十年,这是"算法等待基础设施"最典型的案例。
两次寒冬对今天的从业者有什么具体提醒? 最直接的一条:别把项目价值押在"下一个突破必然出现"上。用今天已验证的能力交付价值,把前沿当期权而非本金,是穿越周期的稳妥姿势。
当前这波浪潮会再次进入寒冬吗? 无法预言,但可以观察先行指标:核心能力是否还在快速提升、单位智能的成本曲线是否在下降、杀手级应用是否在扩散。三问都为肯定时,谈论寒冬为时尚早;任何一问转否,就该收紧预算了。
本节速览
- 学科诞生:1956 年达特茅斯会议,麦卡锡命名"人工智能";
- 第一次寒冬:符号主义困于组合爆炸与常识形式化,1970 年代经费削减;
- 第二次浪潮:1980 年代专家系统商业化,反向传播同期让神经网络复苏;
- 第二次寒冬:知识获取与维护成本失控;
- 静默革命:1990 年代统计学习以数据取代规则,完成哲学转变;
- 当前浪潮三支柱:大数据、GPU 算力、算法改进,2012 年 AlexNet 为引爆点;
- 历史启示:承诺周期、资源依赖、路线轮回,是评估任何 AI 新技术的三把尺子。
概念与历史都齐了,第二章开始进入具体算法:先看有标准答案的监督学习。