2.4 传统算法选型对比与常见坑
2.4 传统算法选型对比与常见坑
本节摘要:本节把第二章三大范式的算法压缩成可执行的选型工具:一张按"数据量 × 特征类型 × 任务类型 × 解释需求"组织的决策矩阵、一条从基线到集成的实操顺序,以及七个高频踩坑点的症状与解法。核心结论有三条——表格数据默认从梯度提升树起步、线性模型永远先做基线、深度学习不是万金油而是一种在原始高维数据上才有压倒性优势的特定工具。
本节导读
阅读完本节,你应当能够:
- 给定一个具体业务场景,三分钟内说出候选算法顺序;
- 用"数据量、特征类型、解释需求、延迟预算"四个维度组织选型讨论;
- 识别数据泄漏、目标泄漏、类别不均衡、评估泄漏等七类常见错误;
- 说清传统机器学习与深度学习的分界线及各自的主场。
一、选型决策矩阵
选型不是玄学,是把四个问题依次问一遍:任务是什么?数据长什么样?要多可解释?多快要结果?
图:传统算法选型决策矩阵
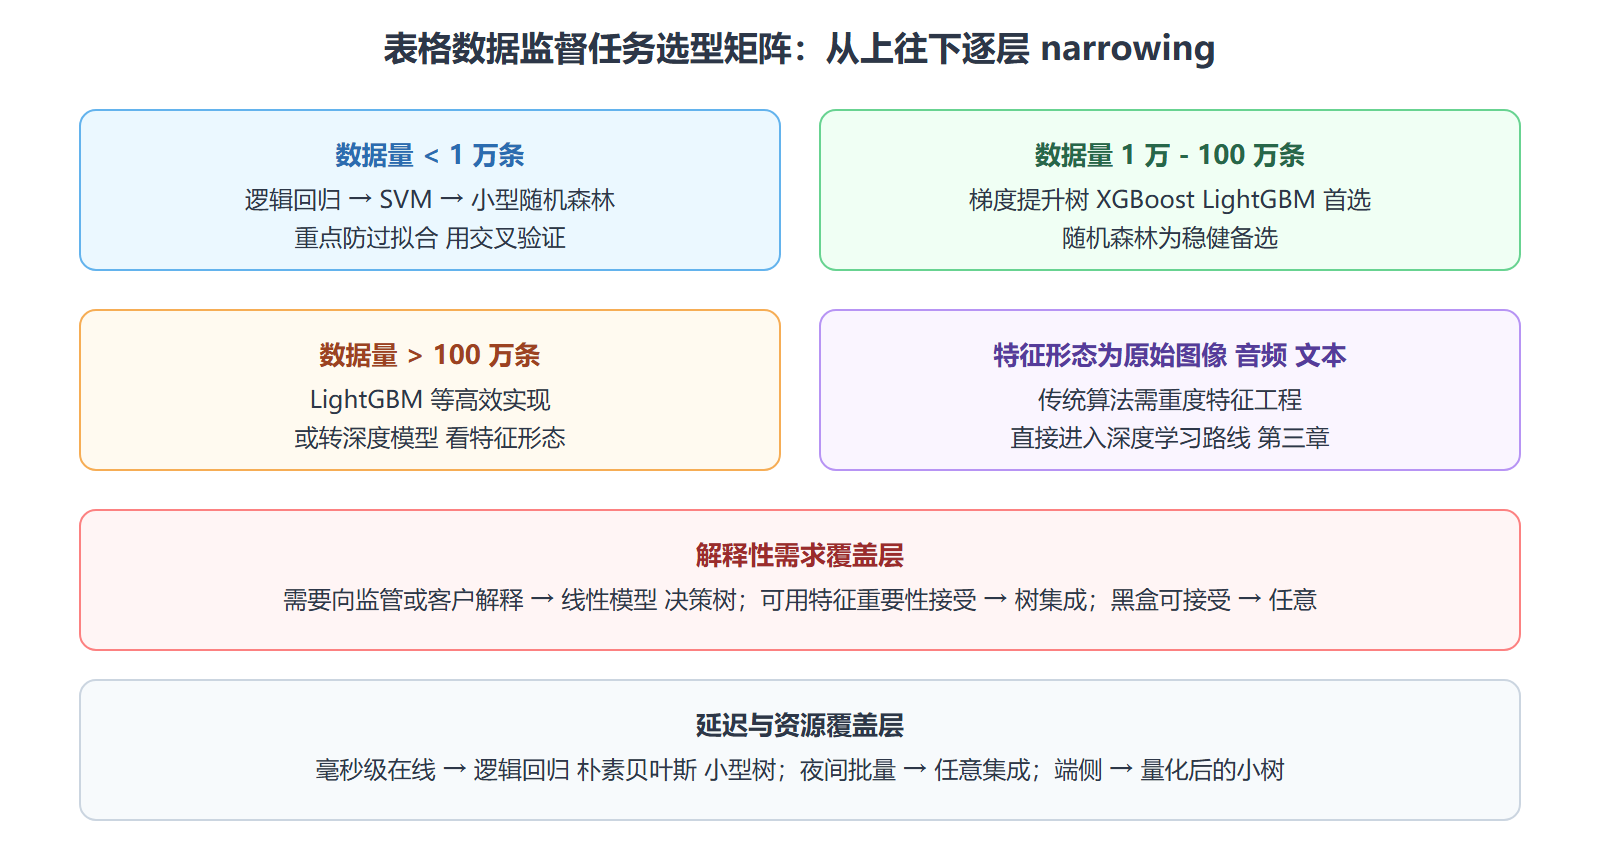
配套的对比总表:
| 算法家族 | 训练速度 | 预测速度 | 可解释性 | 调参难度 | 主场 |
|---|---|---|---|---|---|
| 线性/逻辑回归 | 极快 | 极快 | 强 | 低 | 基线、强解释场景 |
| 朴素贝叶斯 | 极快 | 极快 | 中 | 极低 | 文本分类、流式 |
| KNN | 无训练 | 慢 | 中 | 极低 | 小数据、原型 |
| SVM | 慢(大数据) | 中 | 弱 | 中 | 小样本高维 |
| 决策树 | 快 | 快 | 强 | 低 | 规则提取 |
| 随机森林 | 中 | 中 | 中 | 低 | 稳健通用 |
| 梯度提升树 | 中 | 快 | 中 | 中高 | 表格数据性能王 |
二、一条实操顺序
把矩阵落成操作序列(概念流程,不涉及任何具体文件):
第1步 逻辑回归基线,记录指标与训练耗时 第2步 随机森林开箱即用,看提升幅度 第3步 梯度提升树加简单调参(树深、学习率、轮数配合早停) 第4步 若 2、3 步提升显著 -> 特征工程继续榨油 -> 回到第3步 第5步 若全部停滞 -> 检查数据与标签质量 -> 必要时才考虑换深度模型
这个顺序背后的逻辑是性价比递减:从逻辑回归到梯度提升树,通常用两成 effort 拿八成收益;后面的每一步都更贵。跳过基线直接上复杂模型,最大的损失不是算力,而是失去判断"复杂度买到了什么"的参照系。
三、七个高频坑
坑一:数据泄漏。 训练时不小心混入了"未来才知道的信息"。典型如用含"是否退单"字段的数据预测"是否会下单"。症状是线下指标极高、上线即崩。解法:逐字段问一句"预测发生的那一刻,这个值存在吗"。
坑二:先缩放后划分。 在全量数据上做标准化,把测试集的分布信息泄漏进了均值方差。正确顺序是先划分、只用训练集拟合缩放参数、再套用到测试集。凡"从数据里学出来再应用"的操作(缩放、编码、填充、特征选择)都只许碰训练集。
坑三:类别不均衡只看准确率。 欺诈检测里全预测正常就有 99% 准确率。换用精确率、召回率、F1、AUC,并配合过采样/欠采样或类别权重。
坑四:用测试集调参。 每看一眼测试集再改模型就是泄漏一次。调参只在验证集/交叉验证上做。
坑五:K-Means 忘缩放。 特征量纲悬殊时(收入以万计、年龄以十计),距离被大数值特征垄断,聚类实际只按收入分。先标准化。
坑六:把相关当因果。 模型学到"买保险的人医疗支出高"不代表保险导致支出。预测可以用相关,决策必须辨因果。
坑七:树模型目标泄漏型特征。 某个特征重要度高得反常(单特征 AUC 接近 1),几乎一定是标签的直接或间接化身。重要度异常是泄漏的最好探测器。
💡 关键直觉:传统机器学习与深度学习的分界线是"特征由谁造"。输入是结构化表格(人已定义好字段)→ 树模型;输入是原始信号(像素、波形、字符序列,人不知道该提什么特征)→ 深度学习。记住这条线,一半的选型纠结会直接消失。
⚠️ 常见坑:因为"深度学习更先进"而在一万条表格数据上强行套神经网络。样本不足时深度网络几乎必然过拟合,而梯度提升树大概率同时赢得精度、速度与维护成本三项——先进是相对场景而言的。
四、选型的完整决策流
把前面四步判断落成一张可执行的流程图:
这张图的执行要点在于"尽早分流":第一个分叉(输出形态)决定指标与算法族,第二个分叉(数据形态)决定传统与深度的路线之争,第三个分叉(解释需求)做最后的收缩。三个问题答完,候选通常只剩两三个,再动手做实验比较——选型是缩小范围的漏斗,不是替代实验的判决书。
常见问题
业务方指定要用某个流行算法,怎么应对? 先按其要求跑通并记录指标,同时准备好你的基线对比。用数据说话比自己判断更省争论——多数情况下指定算法与推荐算法的差距会一目了然;即便差距不大,按业务方的偏好交付也降低了采纳阻力。原则问题(如违反合规)除外。
不同算法结果差异很大,信哪个? 先查一致性:交叉验证方差是否过大、特征是否泄漏、划分是否合理。都排除后,结果差异大往往说明问题本身不稳定或特征信息不足——此时任何单一模型都不可全信,可以比较错误样本的分布,选错误类型业务上更能接受的那个。工程决策不只优化平均指标,也优化错误的"形状"。
没有足够数据做验证怎么办? 用留一法或重复 K 折尽量榨取评估信息,同时接受结论的不确定性——报告区间而不是点值。更重要的对策是缩小承诺:先做小流量上线灰度验证,用真实反馈代替离线评估的不足。
要点速记
- 四维选型:任务类型、数据量与特征形态、解释需求、延迟预算,依次 narrowing;
- 表格数据默认路径:逻辑回归基线 → 随机森林 → 梯度提升树,性价比递减;
- 原始高维数据(图像音频文本)是深度学习的专属主场,传统算法在此需要重度特征工程;
- 泄漏是头号杀手:未来信息、先缩放后划分、测试集调参、异常高重要度特征,四个高危点逐一排查;
- 不均衡换指标:准确率会骗人,精确率/召回率/AUC 不会;
- 基线不可跳过:没有简单基线,就无法为复杂度定价。
传统算法的能力边界已经清楚——它们要人把特征备好。下一章进入神经网络的世界,看模型如何自己学会提特征。