3.4 注意力机制与Transformer入门
3.4 注意力机制与 Transformer 入门
本节摘要:注意力机制让模型在处理每个位置时动态地对输入的其他位置分配权重,Transformer 则完全抛弃循环结构、仅用自注意力与全连接构建序列模型,2017 年提出后迅速统一了自然语言处理并扩散到计算机视觉,是当前大语言模型与生成式 AI 的架构基石。本节从 RNN 的长序列瓶颈讲起,拆解自注意力"查询-键-值"的计算直觉、多头机制与位置编码的必要性,最后走一遍 Transformer 编码器层的结构。
你能学到什么
阅读完本节,你应当能够:
- 说出 RNN 在长序列上的两大瓶颈及注意力的解法;
- 用"检索"类比描述查询、键、值三者的角色;
- 解释多头注意力为什么比单头表达力更强;
- 说明自注意力为什么需要位置编码;
- 按顺序列出 Transformer 编码器层的组件;
- 概述从 Transformer 到预训练大模型的路线。
一、循环网络的瓶颈:串行与遗忘
循环网络按时间步逐词处理序列,有两个结构性缺陷:
- 串行计算:第 t 步必须等第 t-1 步算完,无法并行,序列一长训练时间线性膨胀;
- 长程依赖衰减:即便有 LSTM 门控,信息跨越几十步传递时仍会稀释——句首的"它"指代什么,读到句尾可能已经模糊。
注意力机制的思路是不再"接力传话",而是让每个位置直接看到全句:处理"银行"这个词时,模型自动给"河边"高权重、给"办理业务"低权重(或反之,视语境),按权重加权汇总上下文信息。距离在注意力里只是一次权重计算的事,不存在逐步衰减。
二、自注意力:一次加权检索
自注意力的计算可以类比图书检索:你有一个查询(Query,我想找什么),库里每本书有一个键(Key,这本书讲什么标签),以及值(Value,书的内容)。用查询和每个键算相似度,按相似度对所有值加权求和,得到"最相关内容的混合体"。
在序列里,每个词的位置会各自生成查询、键、值三个向量(由三个可学习的变换矩阵从词向量投影得到)。某个位置的输出,就是用它的查询与所有位置的键计算相关性权重,再对全部值加权求和。权重经过 Softmax 归一化,和为一。
多头机制是把这套计算并行做若干遍(比如八头):每头有自己的投影矩阵,专注一种关系模式——某头盯句法依存、某头盯指代消解、某头盯相邻词——最后拼接各头结果再投影。单头只有一种"看法",多头给了模型多重视角。
位置编码是补丁也是必需品:自注意力对所有位置一视同仁,天然不知道词序——"猫追狗"和"狗追猫"会得到同样的表示。解决办法是把位置信息(用不同频率的正弦余弦函数或可学习的向量)加到词向量里,让模型区分顺序。
图:Transformer 编码器层结构透视
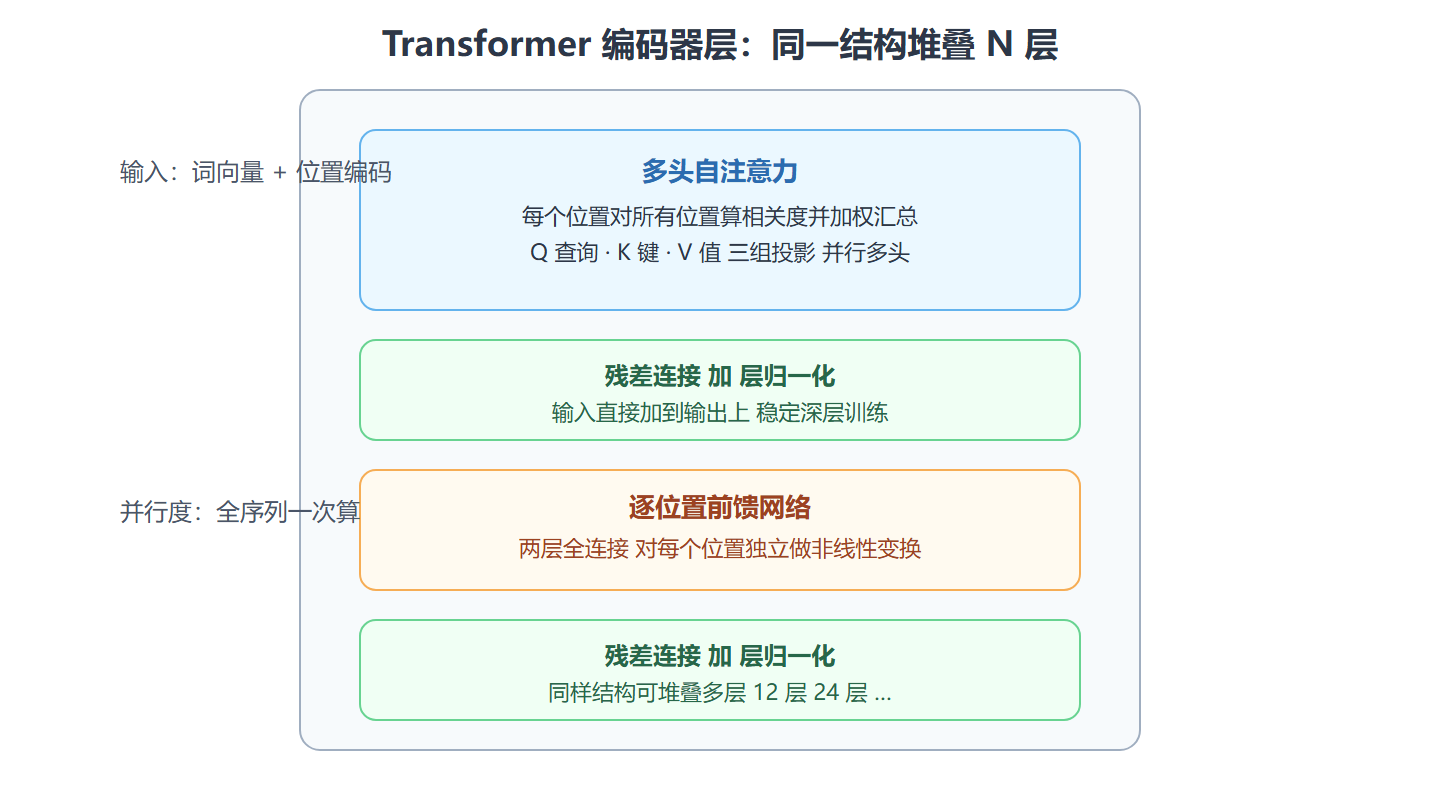
编码器一层就是两块:多头自注意力(跨位置混合信息)加逐位置前馈网络(深度加工每个位置),各配一次残差连接与归一化。解码器多一层带掩码的自注意力和一层交叉注意力,用于生成任务。
| 组件 | 作用 | 若去掉会怎样 |
|---|---|---|
| 多头自注意力 | 跨位置按相关性交换信息 | 退化为逐词独立处理 |
| 多头 | 多视角关系建模 | 只能学一种关联模式 |
| 位置编码 | 注入词序信息 | 分不清词序、指代混乱 |
| 前馈网络 | 逐位置非线性加工 | 表达力大幅下降 |
| 残差加归一化 | 深层可训练 | 堆多层即训练崩溃 |
三、从 Transformer 到大模型
Transformer 的并行性让"在海量文本上预训练"在工程上第一次可行,直接催生了两大预训练范式:BERT 用掩码语言任务训编码器,擅长理解类任务(分类、问答抽取);GPT 用预测下一词训解码器,擅长生成。预训练加大规模数据、微调加下游任务的两段式,成为自然语言处理的标准流程,并随参数与数据扩张演化出今天的大语言模型。视觉领域的 ViT 把图像切成小块当序列输入 Transformer,同样取得与卷积网络比肩乃至更优的表现,多模态模型则用同一架构统一图文。
💡 关键直觉:Transformer 的胜利一半是算法、一半是工程。自注意力的计算量随序列长度平方增长——序列翻倍、算力翻四倍。这就是为什么长上下文至今仍是最活跃的研究战场之一,各种稀疏与线性注意力方案都在攻这一点。
⚠️ 常见坑:以为注意力权重可以直接当"模型解释"呈给业务方。权重只是信息混合的比例,不构成因果说明;对解释的严肃需求应使用第五章 5.4 节的专门解释方法。
四、复杂度账本与工程要点
注意力的平方代价。 序列长度为 n 时,自注意力要计算每一对位置的相关度,共 n 平方次——序列从一千涨到一万,计算量涨一百倍。这是长文档、高分辨率图像处理的直接瓶颈。三类应对思路:稀疏注意力(只算一部分位置对)、线性注意力近似(用核技巧改写计算顺序)、以及滑动窗口加少量全局位置的混合方案。读任何"支持超长上下文"的宣传时,先看它用的是哪一类。
残差思想在 Transformer 里的再利用。 每个子层(注意力、前馈)都套"残差加归一化"的外壳,第三章 3.2 节的残差思想原封不动地搬了过来:堆叠几十层编码器仍能稳定训练,靠的正是这条梯度高速公路。架构思想的复用与迁移,比记住某个具体网络更重要。
编码器与解码器的分工。 编码器每层带标准自注意力,所有位置互相可见,适合"理解整段输入"的任务;解码器的自注意力加了掩码(每个位置只看得见它之前的位置,防止生成时偷看答案),另加一层交叉注意力把编码器的输出作为键值引入——这是翻译类"输入一段、输出一段"任务的标准配置。BERT 只用编码器(理解任务),GPT 只用解码器(生成任务),两条产品路线由此分岔。
常见问题
自注意力比卷积好在哪、差在哪? 好在任意两个位置的直连(无距离衰减)与天然的并行性;差在没有空间先验(卷积的局部性与参数共享白送的归纳偏置,注意力要靠数据和位置编码自己学)。因此注意力通常需要更多数据才能超过卷积——小数据视觉任务上卷积仍是稳妥选择。
位置编码用正弦的好还是可学习的好? 两者效果相近,正弦版本的好处是能外推到训练时没见过的更长序列,可学习版本实现简单。这不是值得纠结的决策,工程上跟随所选框架的默认即可。
为什么生成是一步一步的? 自回归生成每次只产出一个词,把它拼回输入再预测下一个——这是解码器掩码结构决定的必然流程。逐词生成的代价是推理速度与序列长度成正比,各种缓存技巧(缓存已算过的键值)就是为减少重复计算而生。
本章回顾
- 两大瓶颈:循环网络串行慢、长程信息衰减,注意力以"全位置直连加权"同时解决两者;
- QKV 直觉:查询找键算相关、按权重混值,一次检索式加权汇总;
- 多头:多组投影并行,每头学一种关系模式;
- 位置编码必需:自注意力本身对顺序无感,必须外挂位置信号;
- 层结构:多头自注意力加前馈网络,各配残差与归一化,同构堆叠;
- 预训练路线:BERT 编码器理解路线、GPT 解码器生成路线,皆立于 Transformer 并行性之上。
至此从神经元到 Transformer 的原理链条已经完整。下一章去看三个前沿方向:会决策的强化学习、会创造的生成模型、以及两大应用领域。