第3章 · Pandas 数据处理
第 3 章 · Pandas 数据处理
章节摘要:Pandas 是 Python 处理表格数据的绝对主力,核心是 Series 与 DataFrame 两个数据结构。本章从数据结构讲起,带你学会加载 CSV、Excel 等常见格式,掌握索引筛选、缺失值处理、分组聚合与多表合并。学完本章,你已经能独立完成一次"读表 → 清洗 → 分析 → 出结果"的完整数据任务。
你能学到什么
阅读完本章,你应当能够:
- 区分 Series 与 DataFrame,理解索引(index)的作用
- 用 read_csv、read_excel 加载数据,用 info、head、describe 快速探查
- 用 loc、iloc、布尔索引筛选数据,增删改列与行
- 检测并处理缺失值,进行常用数据变换
- 用 groupby 做分组聚合,用 merge、concat 合并多张表
核心概念速览
一句话记住本章:DataFrame 就是一张能编程的电子表格——凡是 Excel 里点得出来的操作,Pandas 都有一行代码的对应物,而且能自动化、能上规模。
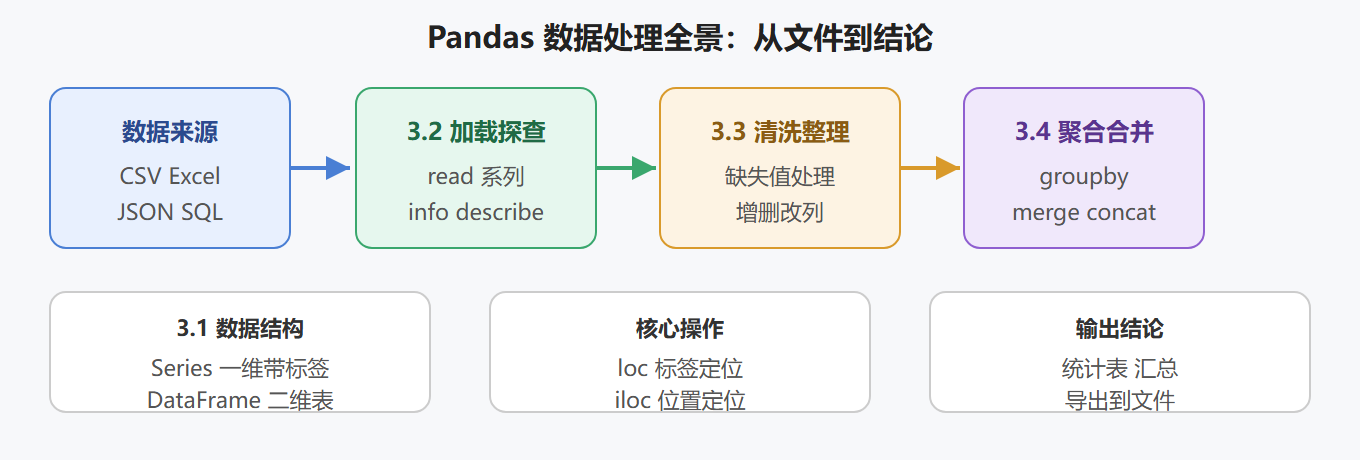
Pandas 数据处理全景图
子章节导航
3.1 Series 与 DataFrame 数据结构
两个核心数据结构的内部组织、索引的作用、常用属性与创建方式,为后续所有操作打底。
3.2 数据加载与索引筛选
read_csv、read_excel 加载,info、head、describe 探查,loc、iloc、布尔索引三种筛选姿势。
3.3 缺失值处理与常用数据操作
isnull 检测、dropna 删除、fillna 填充,以及列的新增、修改、删除、排序等日常操作。
3.4 分组聚合与合并连接
groupby 分组统计、apply 变换、merge 与 concat 合并多表,完成跨表分析。
子章节之间的逻辑关系
认识结构(3.1) → 读入数据(3.2) → 清洗整理(3.3) → 聚合合并(3.4) 数据长啥样 数据进来了 数据变干净 数据能出结论
前三节是"把数据放进表格并用好它",最后一节是"让表格自己说话"——分组聚合是 Pandas 分析能力的高潮。
前置知识与后续延伸
- 前置:第 2 章 NumPy 基础——DataFrame 的单元格本质上就是 NumPy 数组,向量化思维在这里继续生效
- 为后续铺垫:第 4 章的数据清洗是本章 3.3 的系统化展开;第 5 章的可视化直接从 DataFrame 取数绘图
实战建议与常见坑
Pandas 是全书信息密度最高的一章,也是"读表、查表、改表"最频繁用到的工具。练习路线建议:
- 3.1 打底:先造几个小 DataFrame,用 head、info、describe 摸清"表长什么样"
- 3.2 练手:拿一份真实 CSV(比如自己导出的账单)反复练习 loc、iloc 和布尔筛选
- 3.3 过关:重点吃透 fillna 的三类填充,这是清洗章节的地基
- 3.4 登顶:groupby 一定要亲手跑通"按门店聚合 → reset_index → 排序"的完整链条
四个高频坑提前标记:loc 含头含尾、iloc 含头不含尾、布尔组合条件用与或并加括号、fillna 默认返回新对象要重新赋值、merge 前先查重复键。这些坑在第 4、6 章还会以变体出现。
本章验收标准:拿到任意一张表,能在十分钟内完成"读入 → 探查 → 筛选 → 分组汇总 → 输出结果"的完整操作。
评论区
(0)
U