第4章 · 数据清洗与预处理
第 4 章 · 数据清洗与预处理
章节摘要:数据科学圈有句老话——"80% 的时间花在清洗数据上"。本章把清洗拆成四件套:先做数据质量体检,再系统处理缺失值与重复值,接着做类型转换、编码与标准化,最后用 IQR、Z-score 等办法揪出异常值,并把整套流程固化成可复用的清洗管道。学完本章,脏数据不再是你分析路上的拦路虎。
上手前先明确
阅读完本章,你应当能够:
- 用 info、describe 与自定义函数完成数据质量体检
- 按缺失原因与比例选择删除、填充策略
- 完成类型转换、类别编码与数值标准化
- 用 IQR 与 Z-score 检测并处理异常值
- 把清洗步骤组织成可复用、可复现的清洗管道
核心概念速览
一句话记住本章:清洗不是"删删补补"的苦力活,而是把数据从"可用"变成"可信"的工程——每一步处理都要能说出理由。
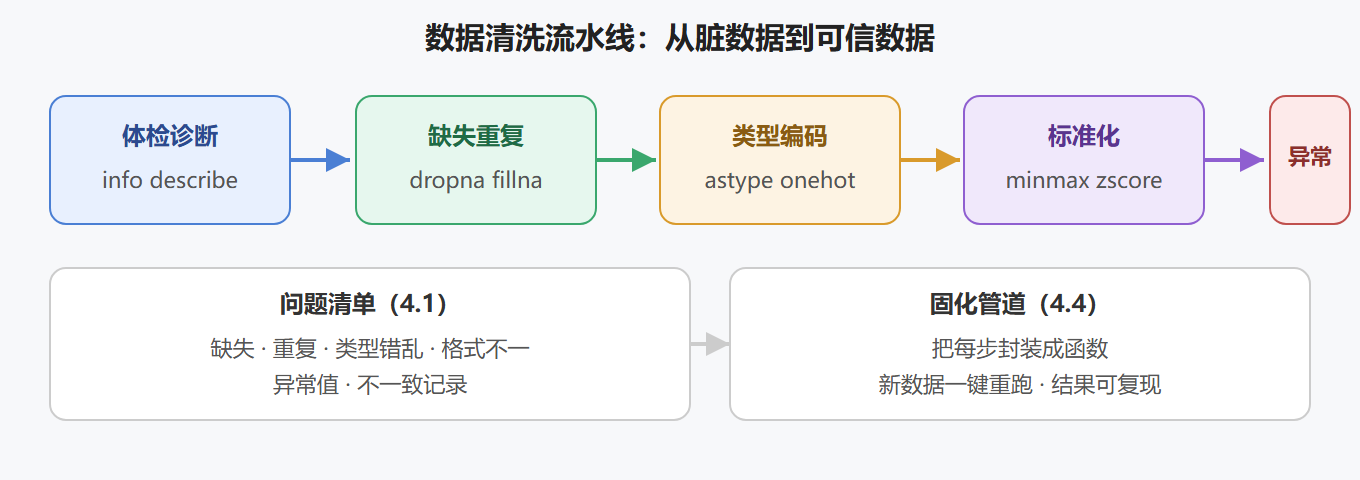
数据清洗流程总览
子章节导航
4.1 数据质量检查与初步探查
先诊断再开药:识别缺失、重复、异常、类型错乱四类问题,建立问题清单。
4.2 缺失值与重复值深度处理
缺失值的删除、填充与插值;重复值的识别口径与删除策略。
4.3 类型转换编码与标准化
astype 类型修正、one-hot 与标签编码、Min-Max 与 Z-score 标准化。
4.4 异常值检测与清洗管道
IQR、Z-score、箱线图检测异常值,并用管道把清洗步骤串成一条流水线。
子章节之间的逻辑关系
体检(4.1) → 缺失重复(4.2) → 类型编码(4.3) → 异常值(4.4) → 管道(4.4后半) 发现问题 清理隐患 统一口径 揪出离群 固化流程
四节遵循"诊断 → 清理 → 规范化 → 验证 → 固化"的清洗主线,前三节解决"数据对不对",最后一节解决"流程能否重跑"。
前置知识与后续延伸
- 前置:第 3 章 Pandas 的缺失值处理与数据操作(3.3 是本节的速览版,本章展开细节)
- 为后续铺垫:清洗后的干净数据直接进入第 5 章的探索分析;标准化与编码是第 6 章机器学习入门的必要前处理
实战建议与常见坑
清洗是"看起来简单、做起来啰嗦"的活,最怕的不是不会,而是漏处理。按下面的顺序练最有效:
- 4.1 先体检:每次拿到新数据,先跑 quality_report 函数,把问题清单打出来——动手前心里有数
- 4.2 定策略:每个问题都问一句"为什么缺",再决定删还是填;把决定写成注释
- 4.3 管类型:to_numeric 加 coerce 是排查类型问题最快的路,新出现的 NaN 就是问题值
- 4.4 建管道:清洗步骤多时,别在 Notebook 里写十段散装代码——封装成 clean_orders 函数,一次跑通
三个高频坑提前标记:清洗顺序别乱(类型 → 去重 → 缺失 → 异常)、异常值可能是业务事实(VIP 大单不是错误)、管道要幂等(同一输入跑两遍结果一致)。这三个坑直接决定清洗结果可不可信。
本章验收标准:能对一份带缺失、重复、类型错乱、异常值的脏数据,完成体检到管道化的全流程,并说清每一步的理由。
评论区
(0)
U