3.2 数据加载与索引筛选
3.2 数据加载与索引筛选
本节摘要:真实数据的加载往往第一步就卡壳——编码、分隔符、表头一个不对,整张表就废了。本节从 read_csv 讲起,覆盖 Excel、JSON 等格式的加载与常见坑,再用 loc、iloc、布尔索引三种方式完成数据筛选,最后学会把探查结果转化为下一步行动的判断。
读前必看
阅读完本节,你应当能够:
- 用 read_csv 加载数据并处理编码、分隔符、表头问题
- 用 read_excel、read_json 加载其他格式
- 用 info、head、describe、value_counts 完成初步探查
- 区分 loc(按标签)与 iloc(按位置),熟练使用
- 用布尔索引组合条件筛选数据
一、问题与直觉
"读取数据"听起来是小事,实际上一半的数据分析时间都耗在这里。最常见的三个现场:Excel 导出的 CSV 是 GBK 编码,直接读出来全是乱码;文件用分号分隔,默认逗号解析后只有一列;第一行是说明文字,被当成了表头。这些问题都能在 read 函数的一两个参数里解决,但不知道的人会卡上半天。
二、核心原理
2.1 read_csv:最常用的加载入口
筛选的本质是"按什么坐标取数据",两套坐标系先分清:
import pandas as pd df = pd.read_csv("orders.csv")
一行的默认行为:第一行当表头、逗号分隔、UTF-8 编码。现实数据往往不符合默认,需要按需调整参数:
df = pd.read_csv( "orders.csv", sep=",", # 分隔符,文件用分号就改成 ";" encoding="utf-8", # 乱码时试 "gbk" header=0, # 第 0 行为表头,无表头设 None index_col=0, # 用第 0 列作行索引 dtype={"订单号": str}, # 强制指定列类型 parse_dates=["日期"], # 把日期列解析为时间类型 )
⚠️ 常见坑:GBK 编码的 CSV 用默认 utf-8 读出来全是乱码,改
encoding="gbk"即好。拿不准就用encoding="utf-8-sig",它兼容带 BOM 的文件。
2.2 其他格式
df_xlsx = pd.read_excel("orders.xlsx", sheet_name="订单") # 指定工作表 df_json = pd.read_json("orders.json") # JSON 数组或字典
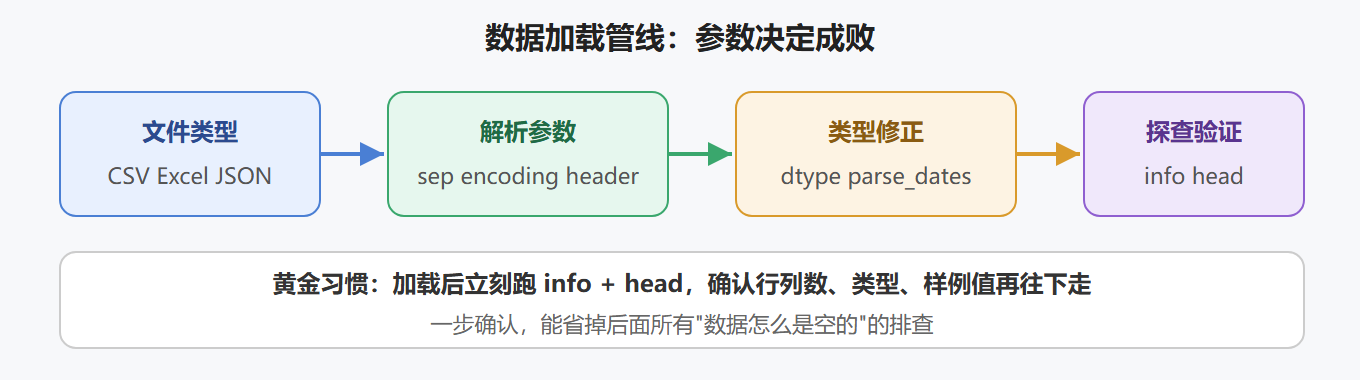
2.3 数据加载管线
三、工程实践要点
3.1 初步探查四件套
df.info() # 每列类型 + 非空数量,一眼看出缺了什么 df.head(10) # 前 10 行样例 df.describe() # 数值列的均值、分位、极值 df["门店"].value_counts() # 分类列频次
info() 里的非空计数是体检报告:如果某列本该全有值却缺了一大半,先别急着分析,回到数据源头搞清楚为什么。
3.2 loc 与 iloc:两套坐标系统
# loc:按标签(行索引名、列名)定位,含头含尾 df.loc["A001"] # 取行索引为 A001 的行 df.loc[0:2, "金额"] # 行 0 到 2(含 2),列 金额 # iloc:按位置(整数下标)定位,含头不含尾 df.iloc[0] # 第一行 df.iloc[0:3, 1:3] # 前 3 行、第 1 到第 2 列 df.iloc[-1] # 最后一行
💡 关键直觉:
loc是"点名",iloc是"数位置"。行索引被洗乱、重排之后,位置不变但标签变了——所以业务上定位数据用 loc,纯切片用 iloc。
3.3 列选择与布尔筛选
df["金额"] # 单列,返回 Series df[["门店", "金额"]] # 多列,返回 DataFrame df[df["金额"] > 300] # 金额超过 300 的订单 df[(df["门店"] == "北京") & (df["金额"] > 100)] # 组合条件 # 用 isin 匹配多个值 df[df["门店"].isin(["北京", "上海"])]
⚠️ 常见坑:组合条件必须用
&、|而不是and、or,且每个条件单独加括号。df[df["金额"] > 300 and df["金额"] < 500]会直接报错。
3.4 选型对照
| 需求 | 用哪个 | 示例 |
|---|---|---|
| 按行名取 | loc | df.loc["A001"] |
| 按位置取 | iloc | df.iloc[3] |
| 按列名取 | 方括号 | df["金额"] |
| 按条件取行 | 布尔索引 | df[df["金额"] > 300] |
| 组合条件 | & 或 | | df[(a) & (b)] |
3.5 贯穿案例:加载并筛选订单
import pandas as pd # 模拟一份订单 CSV(实际场景用 read_csv 读真实文件) df = pd.DataFrame({ "订单号": ["A001", "A002", "A003", "A004", "A005"], "门店": ["北京", "上海", "北京", "广州", "北京"], "金额": [199, 355, 89, 1299, 450], }) df.info() # 只看北京门店、金额超过 150 的订单 bj_high = df[(df["门店"] == "北京") & (df["金额"] > 150)] print(bj_high)
拿到的是"北京门店大额订单"清单——这就是数据筛选的典型用途:把大表切小,把注意力集中到要分析的那部分。
3.6 常见筛选报错排查
| 报错 | 原因 | 解法 |
|---|---|---|
| KeyError 列名 | 列名拼错/空格/大小写 | 先 print(df.columns.tolist()) |
| 布尔条件 and 报错 | 用了 and/or | 改用 &、| 并加括号 |
| 返回空 DataFrame | 条件不成立或列类型不对 | 检查列类型与取值(unique()) |
| 索引越界 | iloc 超范围 | 先看 df.shape 确认行数 |
| 链式赋值告警 | 视图上赋值 | 用 .loc 或先 .copy() |
3.7 链式取数与编程习惯
df[df["金额"] > 300]["门店"] 这类"连续筛选再取列"的写法能跑,但在修改场景会触发"链式赋值"告警——因为中间结果是视图,Pandas 无法保证修改生效。稳妥的写法是分步或优先用 .loc:
# 推荐:一条 .loc 完成"条件选行 + 取列" result = df.loc[df["金额"] > 300, "门店"] # 或分步:先筛后存 filtered = df[df["金额"] > 300].copy() stores = filtered["门店"]
⚠️ 常见坑:看到 "SettingWithCopyWarning" 别无视。它的本质是"你可能在改一份临时副本,改动不会生效"。习惯用
.loc[条件, 列]写法,能彻底避开这个坑。
3.8 加载真实数据的黄金流程
把本节内容串成一套可复用的加载流程:
# 1. 先试默认参数 df = pd.read_csv("orders.csv") # 2. 乱码 → 换编码 # df = pd.read_csv("orders.csv", encoding="gbk") # 3. 列数不对 → 查分隔符 # df = pd.read_csv("orders.csv", sep=";") # 4. 每次都验证 print(df.shape) df.info() df.head()
"加载 → 验证 → 再调整"的循环通常两三轮内就能把文件读对,比盲猜参数快得多。
核心回顾
- 要点一:read_csv 四个高频参数——sep 分隔符、encoding 编码、header 表头、dtype 类型
- 要点二:乱码优先试
encoding="gbk",拿不准用utf-8-sig - 要点三:加载后立刻 info + head,把问题消灭在源头
- 要点四:loc 按标签点名(含头含尾),iloc 按位置数(含头不含尾)
- 要点五:布尔筛选组合条件用
&、|并加括号,不能用 and/or - 要点六:
isin匹配多个值,value_counts看分类分布
数据进来了,筛选也会了。下一节处理最恼人的问题——缺失值,以及各种日常数据操作。