4.4 异常值检测与清洗管道
4.4 异常值检测与清洗管道
本节摘要:异常值(离群点)会让均值失真、模型失衡。本节讲透三种检测方法——IQR 法、Z-score 法与可视化法——的适用场景与代码实现,再介绍删除、截尾、变换三种处理策略,最后把前面所有清洗步骤封装成可复用的清洗管道。
本节地图
阅读完本节,你应当能够:
- 用 IQR 法、Z-score 法编写异常值检测代码
- 用箱线图、散点图辅助识别异常值
- 根据业务场景选择删除、截尾或变换策略
- 把清洗步骤封装成管道函数,一键处理新数据
一、问题与直觉
订单金额里躺着一个 12999 的大单,其他都是几十到几百。算客单价时它把均值从 210 拉到 650——这个"平均"完全不能代表典型订单。异常值不是"要删掉的错误",而是**"显著偏离大多数"的观测**:它可能是录入错误,可能是 VIP 大单,也可能是某种新趋势。检测是技术活,处理是业务判断。
二、核心原理
2.1 三种检测方法的原理对比
检测到异常值后,处理方式由业务判断决定:
异常值检测方法对比图
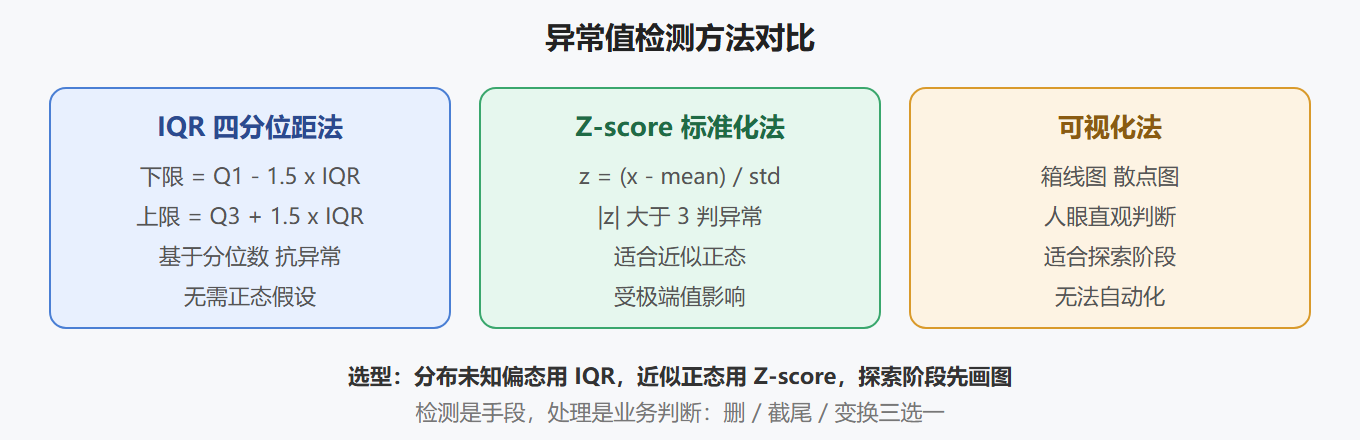
IQR 法:把数据按大小四等分,取 25% 分位 Q1 和 75% 分位 Q3,IQR = Q3 - Q1。超出 [Q1 - 1.5×IQR, Q3 + 1.5×IQR] 的判为异常。因为基于分位数,天然抗异常值污染。
Z-score 法:算每个值与均值的距离是几个标准差。|z| > 3 判为异常。前提是分布近似正态,且均值本身会被极端值带偏——一个巨大的离群点会拉高 std,让其他异常"藏"起来。
2.2 处理的三种策略
- 删除:确认是录入错误且数量少,直接删行
- 截尾(winsorize):把异常值压缩到边界值(如 99% 分位),保留信息不放大影响
- 变换:取对数等压缩长尾,让右偏分布更接近正态
三、工程实践要点
3.1 IQR 法实现
import pandas as pd import numpy as np def detect_outliers_iqr(series): q1 = series.quantile(0.25) q3 = series.quantile(0.75) iqr = q3 - q1 lower, upper = q1 - 1.5 * iqr, q3 + 1.5 * iqr return series[(series < lower) | (series > upper)].index amounts = pd.Series([199, 89, 399, 59, 1299, 45, 12999]) idx = detect_outliers_iqr(amounts) print("IQR 判定异常的下标:", idx.tolist())
3.2 Z-score 法实现
def detect_outliers_zscore(series, threshold=3): z = (series - series.mean()) / series.std() return series[z.abs() > threshold].index idx = detect_outliers_zscore(amounts) print("Z-score 判定异常的下标:", idx.tolist())
⚠️ 常见坑:Z-score 在数据量小时(几十个样本)极不稳定,一个离群点就足以扭曲均值和标准差,导致漏检。小样本优先 IQR 法。
3.3 截尾与变换
# 截尾:把超过 99% 分位的值压到边界 cap = amounts.quantile(0.99) amounts_clipped = amounts.clip(upper=cap) # 对数变换:压缩右偏长尾 amounts_log = np.log1p(amounts)
3.4 清洗管道:把流程固化成函数
def clean_orders(df): """订单数据清洗管道:类型 → 去重 → 缺失 → 异常,返回干净表""" # 1. 类型修正 df["金额"] = pd.to_numeric(df["金额"], errors="coerce") df["日期"] = pd.to_datetime(df["日期"], errors="coerce") # 2. 按订单号去重 df = df.drop_duplicates(subset=["订单号"], keep="first") # 3. 缺失金额用中位数填充 df["金额"] = df["金额"].fillna(df["金额"].median()) # 4. IQR 检测异常,业务确认后截尾 q1, q3 = df["金额"].quantile([0.25, 0.75]) iqr = q3 - q1 cap = q3 + 1.5 * iqr df["金额"] = df["金额"].clip(upper=cap) # 5. 验证 assert df["金额"].isnull().sum() == 0, "仍有缺失" return df clean = clean_orders(df)
管道函数把 4.1 到 4.4 的全部步骤串成一条流水线:新数据进来,一个函数调用就得到干净表。assert 是最后一道闸门——任何一步漏处理都会在这里报错。
💡 关键直觉:清洗管道的关键不是"写得优雅",而是幂等可重跑——同一份数据跑两遍结果一致。这样数据更新时重跑一遍即可,结论可复现。
3.5 管道设计要点
| 步骤 | 顺序理由 | 常见错误 |
|---|---|---|
| 类型先于缺失 | 类型错了填不准 | 先 fillna 后 astype |
| 去重在缺失前 | 重复行留着影响缺失统计 | 顺序颠倒 |
| 异常在填充后 | 用中位数填完再看边界 | 顺序颠倒 |
| assert 收尾 | 保证下游不会拿到脏数据 | 漏掉验证 |
3.6 异常值处理的业务判断
技术检测出"异常"后,处理方式取决于业务解释:
| 业务解释 | 建议处理 |
|---|---|
| 录入错误(金额 12999 实为 129.99) | 修正或删除 |
| 真实大单(VIP 客户采购) | 保留或单独建模 |
| 测量噪音 | 删除或截尾 |
| 新趋势的信号(新品类爆单) | 保留并重点分析 |
💡 关键直觉:异常值可能是噪声,也可能是信号。删除前先问"这个值为什么会出现"——把 VIP 大单当错误删掉,等于删掉了最重要的业务事实。处理方式要记录,后续结论有据可查。
3.7 多列联合的异常检测
单列 IQR 只查单维离群,实际数据常常"单看不异常、组合才异常"——比如"订单量 1 但金额 99999":
# 先算金额的合理范围,再联合订单量判断 amount_q3 = df["金额"].quantile(0.75) amount_cap = amount_q3 + 1.5 * (amount_q3 - df["金额"].quantile(0.25)) suspicious = df[(df["金额"] > amount_cap) & (df["订单量"] == 1)] print("可疑记录数:", len(suspicious))
组合条件需要结合业务经验设计。刚开始可以简单点,等对数据熟悉了再加维度——先抓住单维离群,再逐步升级到组合检测。
3.8 清洗管道与建模管道的衔接
本书的清洗管道止步于"干净数据"。在实际项目中,清洗管道往往还要衔接特征工程与建模:清洗输出接特征工程(编码、标准化),特征输出再进模型训练。每一段都是独立函数、各自可测,整条链路用一行主流程串起来——这正是第 6.3 节管道工程化的雏形。
3.9 管道重跑的注意事项
管道跑第二遍时结果应该一致,但有三个隐蔽的不一致来源:inplace=True 修改了输入、随机数没设种子、读取的是"已清洗过"的中间文件又被清洗一遍。检查方法很简单——同一份原始输入跑两遍,用 assert df1.equals(df2) 验证。
一节小结
- 要点一:IQR 基于分位数抗污染,适合右偏与未知分布;Z-score 适合近似正态、样本量大
- 要点二:小样本别用 Z-score,一个离群点就能让检测失灵
- 要点三:处理三策略——确认错误就删、保留信息就截尾、压缩长尾就变换
- 要点四:检测是技术判断,处理是业务判断,两者要分开记录理由
- 要点五:清洗管道 = 类型 → 去重 → 缺失 → 异常 → assert 验证
- 要点六:管道必须幂等可重跑,新数据一键出干净表
数据终于洗得干干净净了,下一章进入最有趣的部分——探索分析与可视化,用图表把数据里的规律"看"出来。