2.1 计算服务与弹性伸缩
2.1 计算服务与弹性伸缩
本节摘要:计算服务是 IaaS 的核心,腾讯云的计算产品矩阵覆盖从通用到专用的各种场景。CVM(云服务器)是主力虚拟机,适合绝大多数通用计算;黑石裸金属给需要直接用物理硬件(无虚拟化损耗、特殊合规要求)的场景;GPU 云服务器给 AI 训练和推理、图形渲染等算力密集任务;弹性伸缩让实例根据负载自动增减,是应对流量波动的关键。本节讲这些产品的定位差异、实例类型怎么选、以及弹性伸缩的配置策略。
学习目标
阅读完本节,你应当能够:
- 区分 CVM、黑石裸金属、GPU 云服务器的定位和适用场景
- 根据应用的 CPU/内存/IO 特征选对实例类型
- 说清弹性伸缩的工作原理和配置要点
- 理解抢占式实例适合什么、不适合什么
- 规划一个应对流量波动的弹性计算架构
问题与直觉
部署一个服务,第一步是"在哪跑"。最直觉的选择是开一台 CVM——它就是一台虚拟机,和你熟悉的物理服务器用法一样,装系统、装软件、跑服务。所以 CVM 是绝大多数场景的默认起点。
但 CVM 不是万能的。有些场景它不够用:训大模型要 GPU,CVM 的 CPU 版本跑不动;金融业务要求物理隔离,虚拟机的多租户不满足合规;图形渲染要专业显卡。这些就要用专门的计算产品——GPU 实例、裸金属、带专业显卡的实例。
更进一层的问题:流量会波动。白天高峰要 20 台机器,半夜低谷 2 台就够。如果一直开 20 台,低谷时浪费钱;如果手动开关,运维累还容易出错。弹性伸缩就是解决这个——让机器数自动跟着负载走。这是云相对自建机房的核心优势之一(自建机房的硬件买了就不能退,云的实例按秒计费、随开随关)。
核心原理
2.1 计算产品矩阵
腾讯云的计算类产品主要这几个:
CVM(Cloud Virtual Machine,云服务器):腾讯云的通用虚拟机,绝大多数场景的首选。它提供各种规格(CPU 核数、内存大小、网络性能不同),按需选择。CVM 的核心卖点是弹性——按秒计费、随时创建销毁、镜像快速复制。你熟悉的一切服务器操作(装系统、配环境、跑服务)都能在 CVM 上做。
黑石裸金属:物理服务器,没有虚拟化层。适合两类场景:一是对性能极致敏感(虚拟化有微小开销,某些高性能计算不接受),二是有合规要求(金融、政务要求物理隔离,不能和别人共用物理机)。代价是弹性差——物理机的创建销毁比虚拟机慢,且不能像 CVM 那样灵活规格调整。多数业务用不到裸金属。
GPU 云服务器:带 GPU 的实例,用于 AI 训练/推理、图形渲染、视频转码等算力密集任务。按 GPU 型号分(如搭载不同代际的 NVIDIA GPU)。GPU 实例贵(每小时费用是普通 CVM 的几十倍),用时才开、用完就关是基本策略。
弹性伸缩(Auto Scaling, AS):严格说它不是一种实例,而是管理 CVM 数量的服务。它根据规则(CPU 利用率超阈值、定时、负载)自动增减 CVM 实例数量。
| 产品 | 本质 | 适用场景 | 弹性 | 成本 |
|---|---|---|---|---|
| CVM | 通用虚拟机 | 绝大多数通用计算 | 高(秒级开关) | 中 |
| 黑石裸金属 | 物理服务器 | 高性能、合规隔离 | 低(分钟级) | 高 |
| GPU 云服务器 | 带GPU实例 | AI、渲染、转码 | 高但贵 | 极高 |
| 弹性伸缩AS | 实例数量管理 | 应对流量波动 | 自动 | 省钱 |
2.2 CVM 实例类型怎么选
CVM 有几十种实例规格,按资源配比分成几个系列:
| 系列 | 资源配比特点 | 适合的应用 |
|---|---|---|
| 标准型 | CPU 内存均衡 | Web服务、中小数据库、通用应用 |
| 计算型 | CPU 多内存少 | 高计算 批处理、科学计算 |
| 内存型 | 内存多CPU少 | 大数据库、内存缓存、大数据 |
| 大数据型 | 大本地盘 | Hadoop、数据仓库 |
| 高IO型 | 高磁盘吞吐 | 数据库、IO密集应用 |
选型的核心是"匹配应用的资源消耗特征"。一个 Web API 主要是 CPU 计算,用标准型或计算型;一个 MySQL 数据库吃内存(缓存数据),用内存型;一个 Hadoop 节点要大本地盘存数据,用大数据型。选错系列(比如把数据库放在计算型上)会导致资源浪费或性能瓶颈。
💡 关键直觉:实例类型选对,比单纯加配置重要。我见过团队抱怨"数据库慢",加内存加 CPU 都没用——因为他们把数据库放在了计算型实例(CPU 多内存少),数据库的瓶颈是内存不够缓存数据。换到内存型实例,同样的总价性能直接翻倍。先认清应用的资源画像,再选匹配的系列。
2.3 弹性伸缩的工作原理
弹性伸缩让 CVM 数量自动跟随负载。它有三个核心概念:
伸缩组:一组配置相同的 CVM 实例,它们的规格、镜像、网络配置都一样,只是数量会变。
伸缩规则:触发增减的条件。常见的是告警触发(CPU 利用率超 70% 持续 5 分钟就加一台)、定时触发(每天早上 8 点扩到 20 台)、健康检查(某台实例不健康就替换)。
启动配置/模板:新实例怎么创建——用什么镜像、什么规格、初始化脚本。新扩出来的实例按这个模板创建,保证和现有实例一致。
弹性伸缩的关键挑战是"新实例要能快速就绪"。如果创建实例后要手动装一堆软件,扩容就太慢了(流量来了等你装完软件黄花菜都凉了)。所以弹性伸缩要求实例能"即开即用"——通常配合镜像(预先装好软件打包成镜像)和启动脚本(创建时自动执行初始化)。
工程实践要点
3.1 抢占式实例省钱用
除了按需实例(随时用随时计费),还有一种抢占式实例(spot instance):用闲置的物理机资源,价格便宜很多(可能是按需的 1–5 折),但可能被随时回收(资源紧张时厂商会抢回)。适合对中断不敏感的批处理任务——大数据 ETL、模型训练的容错版本、视频转码队列。不适合在线服务(被回收就服务中断)。
抢占式实例的核心使用策略是"任务要能中断和恢复"。把大任务切成小块,每块跑完存 checkpoint,被回收后从 checkpoint 继续。这样即使实例被抢,损失也只是当前小块。
| 实例类型 | 价格 | 稳定性 | 适合 |
|---|---|---|---|
| 按需实例 | 标准 | 高 | 在线服务、关键任务 |
| 包年包月 | 折扣 | 高 | 长期稳定负载 |
| 抢占式 | 极低 | 低(可能被回收) | 容错批处理 |
3.2 弹性伸缩的配置陷阱
扩容太迟钝:阈值设得太高(CPU 90% 才扩)或持续时间太长(持续 10 分钟才扩),等扩出来流量已经崩了。要根据业务流量曲线调——突发流量场景阈值要低、持续时间要短。
缩容太激进:CPU 一降就缩,可能把刚空闲的实例缩掉,结果下一个流量波峰来又要重新扩。缩容要比扩容保守(持续时间设长些),容忍短暂低谷。
新实例就绪慢:扩出来的实例要几分钟才能接收流量(创建+初始化+健康检查),这段时间它不算在可用实例里。要预留 buffer——别等到满载才扩,提前扩。
无状态要求:弹性伸缩要求实例是无状态的(任何实例都能处理任何请求),因为请求可能被分配到新扩的实例。如果实例上有本地状态(比如内存里的会话),缩容时状态会丢。状态要外置到数据库或缓存。
⚠️ 常见坑:弹性伸缩配合负载均衡(CLB)时,新实例要注册到 CLB 才能接收流量。如果伸缩组没正确配置 CLB 关联,新扩的实例创建了但不接流量,等于白扩。配置后务必压测验证:人为触发扩容,观察新实例是否真的开始处理请求。
3.3 GPU 实例的成本控制
GPU 实例贵,成本控制是重点。几个做法:
用完就关:GPU 实例按秒计费,训练任务跑完立刻关机。别让它空转——一个 GPU 实例空转一天的电费和折旧够你心疼。
训练用抢占式:模型训练如果做了 checkpoint,可以用抢占式 GPU 实例省钱。但要容忍中断和恢复的复杂度。
推理和训练分开:训练用大 GPU 实例(按需开),推理用小一点的或量化后的模型(长期跑)。别用训练规格的实例跑推理,浪费。
考虑托管替代:如果只是调大模型 API,用厂商的模型服务(按调用量计费)比自己开 GPU 实例便宜得多。只有要跑自己的模型、或对延迟/隐私有要求时才自建 GPU 推理。
本节要点回顾
- CVM 是默认选择:通用虚拟机,绝大多数场景从它开始,按需选规格。
- 黑石裸金属给特殊场景:高性能或合规隔离需求,多数业务用不到。
- GPU 实例给算力密集任务:AI 训练推理、渲染,贵且用时才开。
- 实例类型要匹配资源画像:CPU 密集用计算型、内存密集用内存型,选对系列比加配置重要。
- 弹性伸缩自动调节数量:伸缩组+规则+模板三件套,核心是新实例要能即开即用。
- 抢占式实例省钱但可能被回收:适合容错批处理,不适合在线服务。
- 弹性伸缩配置要避免四个坑:扩容太迟钝、缩容太激进、新实例就绪慢、实例要无状态。
- GPU 成本控制:用完就关、训练用抢占式、推理用小规格、考虑托管替代。
下一节讲存储和网络——数据放哪(对象/文件/块存储)、服务怎么连通(VPC/CLB/CDN)。
计算形态的概念分层与选型补充
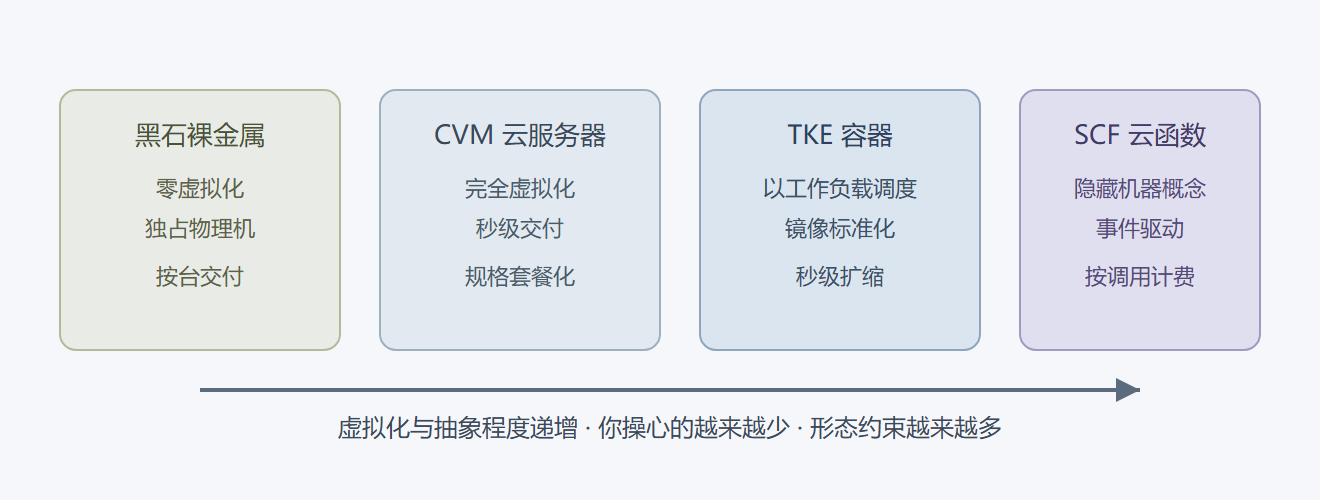
把本节出现的计算产品放回概念坐标系,记忆会更牢。本质上它们是同一条"虚拟化程度"轴上的不同刻度:黑石裸金属是零虚拟化(独占物理机,性能无损但交付慢、按台计费),CVM 是完全虚拟化(秒级交付、规格套餐化),容器服务在虚拟机之上再抽象一层(以工作负载而非机器为单位调度),Serverless 云函数则把"机器"这个概念彻底藏起来(只暴露函数和事件)。每往右一步,你操心的事情少一件(机器、操作系统、运行时),但形态约束多一分(镜像规范、冷启动、时长上限)。选型时先问自己要交付的最小单元是"一台机器"还是"一个函数",答案基本就把刻度定死了。
实例规格的选法再补一个实用细节:规格族命名里的字母对应资源配比(计算型 CPU 内存一比二、内存型一比八之类),拿不准时先看应用的资源画像——CPU 利用率常年是内存利用率的三倍,说明配比选反了。另外生产环境尽量用同一规格族,混部的集群在伸缩和预留实例采购上都会吃亏。
补充一句关于容量的经验:容量规划的核心不是算平均值而是算"峰值 × 余量",而余量来自你想要的故障冗余(N+1)和发布窗口(滚动更新时少一部分实例仍要顶住流量)。把这两个数字写进伸缩组的最大实例数里,才算是真正闭环。
图:计算形态的虚拟化程度光谱