4.1 网络原生 AI 与自治闭环
4.1 网络原生 AI 与自治闭环
本节摘要:内生智能(Native Intelligence)是 6G 的灵魂。本节解释 AI 如何从应用层外挂,沉到协议栈每一层,并通过分布式智能代理形成"网络即智能体"的自治闭环——自配置、自优化、自修复。读完你能区分"外挂 AI"与"内生智能"的设计哲学差别,说清联邦学习为何是隐私底线,以及为什么自治必须配人工护栏。
本节导航
阅读完本节,你应当能够:
- 区分"外挂 AI"与"内生智能"在设计哲学上的本质差别(不只是部署位置)
- 描述一个网络自治闭环的四个环节,及其"智能刷新率"的意义
- 说明联邦学习为何适合 6G 隐私保护型智能,以及它的代价
- 列出 AI 下沉带来的三类新风险(模型漂移、不可解释、偏见累积)
- 解释为什么自治闭环必须配人工可审计的护栏,不能全交黑盒
一、问题与直觉:外挂 AI 为什么撑不住 6G
5G 时代也讲"智能网络",但那时的 AI 多半是"外挂"——在网络之上加一个智能控制器,采集数据、回传到中心、跑模型、下发决策。这套做法在 5G 早期够用,但在 6G 的目标下开始捉襟见肘:
- 时延撑不住。把感知数据回传到智能层、再下发决策,一个来回至少几十毫秒。6G 要的是亚毫秒级闭环,外挂 AI 的"回传—决策—下发"链路本身就是时延瓶颈。
- 数据搬不动。海量感知数据(孪生城市的百万传感器、全息通信的实时点云)全往中心搬,传输和存储成本爆炸,也违反"数据最小化"的隐私原则。
- 决策不连贯。外挂 AI 和协议栈是两层皮,它看不到协议栈内部的细粒度状态,决策只能粗粒度下发,做不到"按每个数据包、每个时隙"实时优化。
把 AI 当外挂,等于给一辆燃油车贴个自动驾驶标——感知、决策、执行还是脱节的。6G 要的是"出厂就带电驱":AI 长在协议栈里,物理层预测信道、MAC 层优化调度、网络层编排资源、应用层编排服务,彼此用同一套状态联动。这样网络才能在不靠人盯的情况下自己调自己。这不是"把外挂 AI 移到网络内部"那么简单,而是设计哲学的根本转变——AI 不再是网络的"附加功能",而是网络的"运行方式"。
二、核心原理:自治闭环与分布式智能代理
图:网络原生 AI 自治闭环
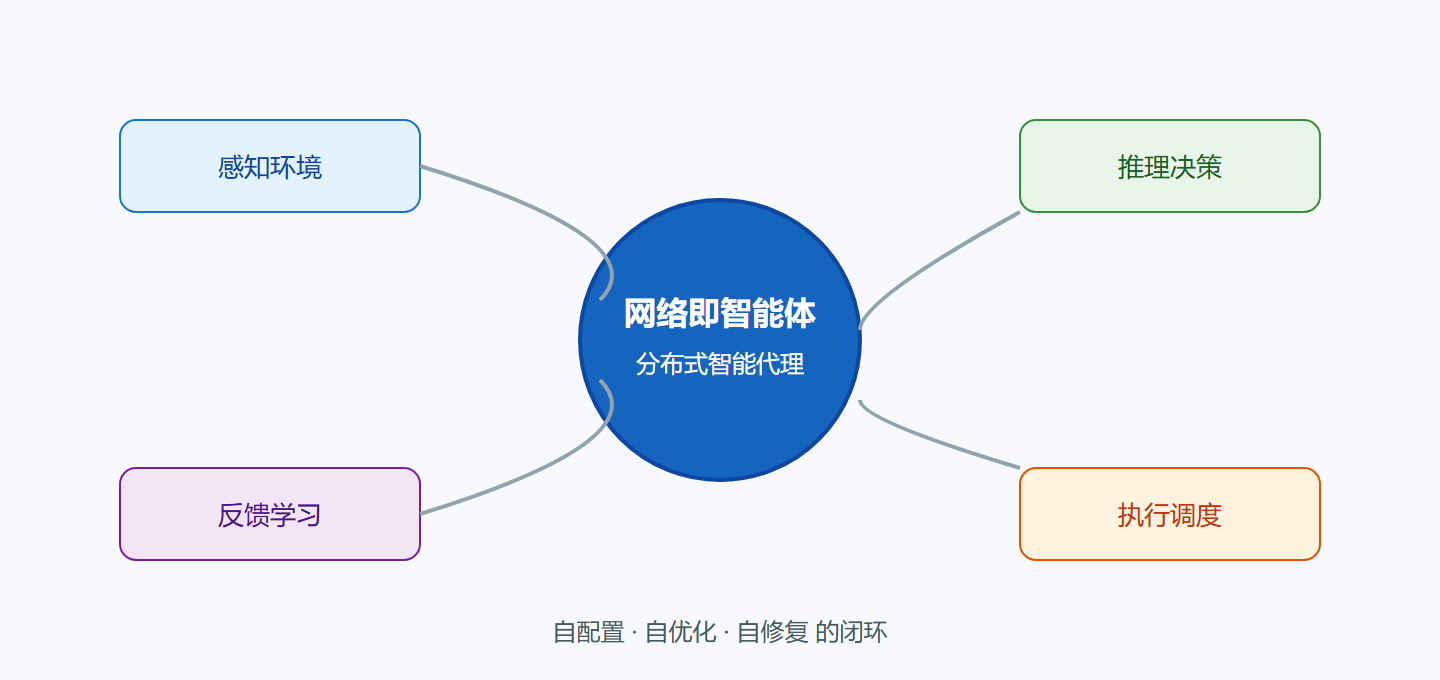
原生 AI 的核心是"自治闭环":感知(采集网络与环境状态)→ 推理(AI 模型预测和决策)→ 执行(下发配置到协议栈)→ 反馈(观测执行效果,更新模型)。这四个环节高速循环,循环的频率决定网络的"智能刷新率"——刷新越快,网络越像一个实时反应的智能体。6G 目标是把刷新率压到毫秒甚至亚毫秒级,这意味着 AI 推理必须就地做(在基站、在终端、在边缘节点),不能依赖中心云。
这个闭环不是单一中心化的,而是大量"分布式智能代理"协同。每个基站、每个边缘节点、每个终端都跑着自己的轻量 AI 代理,处理本地决策;它们通过联邦机制在全局层面协同,避免单点瓶颈。这就是"网络即智能体"——不是一个大脑控制全网,而是无数小脑协同形成群体智能。
核心网内置轻量训练与推理框架,支持联邦学习、迁移学习等隐私保护型范式。各节点本地处理敏感数据(如位置轨迹、业务行为),只上传模型参数,既保隐私又提效率。
联邦学习:6G 隐私底线的技术载体
6G 节点越智能,越需要数据;但用户数据越敏感(位置、健康、行为),越不能集中到一处。这是天然矛盾。联邦学习(Federated Learning)解这个矛盾——原始数据留在节点本地,只上传模型参数梯度,由协调器聚合成全局模型。这样数据不出域,模型却能在所有节点的数据上"学到东西"。
但联邦学习不是免费的午餐,它有三个工程代价:
- 通信开销。每轮训练都要在节点和协调器间传参数,参数量随模型规模线性增长。6G 用压缩、稀疏化、事件触发(只在模型变化大时上传)等手段降低通信成本。
- 异构性挑战。各节点的数据分布、算力、电量都不一样,简单的平均聚合效果差。要做法权重聚合、异步训练等处理。
- 安全风险。联邦学习自身也有攻击面——投毒攻击(恶意节点上传错误的梯度污染模型)、推断攻击(从参数反推原始数据)。需要差分隐私、鲁棒聚合等防御。
💡 关键直觉:联邦学习解决的是"数据不出域"的矛盾——6G 节点越智能,越不能把用户数据集中到一处。参数上云、原始留下,是内生智能的隐私底线。它不是"更安全的训练方法",而是"在隐私约束下唯一能做集中式学习的方法"。
三、工程实践要点:AI 下沉的三类新风险
| 层级 | AI 做什么 | 收益 | 风险 |
|---|---|---|---|
| 物理层 | 信道预测、波束选择、信号检测 | 降开销、提速率、抗高速移动 | 模型漂移、训练分布失配 |
| MAC 层 | 调度优化、多址决策 | 低时延、高频谱效率 | 决策不可解释、异常难复现 |
| 网络层 | 资源编排、切片调度 | 弹性、自愈 | 偏见累积、连锁故障 |
| 应用层 | 服务编排、意图解析 | 体验保障、意图理解 | 隐私推断、价值偏差 |
AI 下沉带来收益,也带来三类前代网络没有的新风险,必须正面应对:
风险一:模型漂移。AI 模型在训练数据分布上表现好,但真实网络环境会变(用户行为迁移、新业务涌现、硬件老化),模型性能会随时间下降。6G 必须配持续学习机制(在线学习、增量学习)让模型跟着环境演化,但这又和"模型稳定性"矛盾——频繁更新模型本身就是一个不稳定因素。工程上通常用 A/B 灰度、回滚机制、漂移监测来平衡。
风险二:不可解释。深度学习模型是黑盒,决策过程不透明。在 MAC 调度这种关键决策上,出了故障没法定位"为什么模型这么决策",排障极其困难。6G 的解法是发展可解释 AI(XAI),在关键决策点保留可解释的传统算法做对照和兜底。
风险三:偏见与连锁故障。如果训练数据有偏见(比如某类用户行为样本少),模型会对这类用户决策次优;多个层级的 AI 决策还可能互相放大偏差,形成连锁故障——物理层的小误差被 MAC 层的调度放大,再被网络层的编排进一步放大。这要求端到端的偏差监测和熔断机制。
⚠️ 常见坑:自治闭环一旦"自修复"逻辑出错,可能自己把正常配置改坏。6G 的自治必须配人工可审计的护栏,不能全交给黑盒。具体说,每个自动决策都要留审计日志、设异常熔断、保留人工一键回滚——AI 可以"建议",但关键变更要有人或规则确认。这不是不信任 AI,而是网络是关键基础设施,出了问题影响面太大,必须有兜底。
一个常被忽视的设计:闭环的"粒度"
自治闭环不是越快越好、越细越好。闭环粒度(决策的频率和范围)要匹配业务的特性:实时控制类(远程手术)要毫秒级细粒度闭环,但海量物联类(智能水表)用小时级粗粒度闭环就够,强行细粒度反而浪费算力。6G 的智能调度要能识别业务类型,动态选择闭环粒度——这本身又是一个 AI 决策。设计不好的话,闭环粒度管理会成为新的复杂度爆炸点。
一个真实的取舍:联邦学习到底划不划算
我在评估一个跨运营商协同的智能漫游调度项目时,正好撞上联邦学习的划算性问题,这里把账算给大家看。表面看联邦学习很美——数据不出域、隐私合规、还能集中学习。但落地时三个隐性成本会冒出来。第一是带宽成本:模型参数越大、参与节点越多、训练轮次越多,参数传输的开销就越可观,一个中等规模的模型在几百个节点上跑几十轮,参数流量可能比直接传原始数据还大。第二是收敛成本:节点数据分布不均(异构性)会让全局模型收敛慢,有时候训了上百轮还不如本地小模型准。第三是运维成本:要维护一套参数聚合服务器、节点注册、版本管理、防投毒检测,这套基础设施本身不简单。结论是:联邦学习适合"数据敏感且必须集中学习"的场景(比如跨医院的医疗模型),在数据不那么敏感、节点数量大、模型规模大的场景里,它的总成本可能反而高于集中式学习。选不选它,要先做一次诚实的成本对比,而不是因为它"听起来更安全"就盲目上。
还有一个被忽视的点:联邦学习的"隐私保护"是相对的,不是绝对的。参数梯度里仍可能泄露原始数据的统计特征,已经有研究能从梯度反推部分训练样本。所以高敏感场景里,联邦学习还要叠加差分隐私或安全聚合,而这又会进一步降低模型精度。工程上没有银弹,联邦学习是"隐私—精度—成本"三角里的一个折中点,不是免费午餐。
一节小结
- 要点一:内生智能把 AI 沉到协议栈每一层,不是部署位置改变,而是设计哲学从"附加功能"变为"运行方式"
- 要点二:分布式智能代理形成"网络即智能体",不是单一大脑控制全网,而是群体智能协同
- 要点三:自治闭环含感知、推理、执行、反馈四环节,刷新频率决定网络的实时反应能力,目标压到毫秒级
- 要点四:联邦学习让原始数据不出域、只上传参数,是内生智能的隐私底线,但有通信开销、异构性、攻击面代价
- 要点五:AI 下沉带来三类新风险——模型漂移、不可解释、偏见与连锁故障,必须配持续学习、XAI、熔断机制
- 要点六:自治必须配人工可审计护栏,关键变更留审计日志、设熔断、保留人工回滚,不能全交黑盒
- 要点七:闭环粒度要匹配业务类型,不是越快越细越好,强行细粒度会浪费算力甚至引发新复杂度
下一章看智能在"传什么"层面的落地——语义通信,它把"传比特"变成"传意图"。