5.1 语义通信:从比特到意图
5.1 语义通信:从比特到意图
本节摘要:语义通信跳过"比特精确还原",直接传输任务所需的"意义",在特定场景能大幅降低所需信息量。本节用一张对比图说清两种范式,给出损失函数的本质差异,并指出它的适用边界。读完你能写出两种范式的损失函数,知道语义通信何时该用、何时该退回比特通信。
学习目标
阅读完本节,你应当能够:
- 写出语义通信优化的损失函数形式,对比比特通信
- 对比比特通信与语义通信的适用场景,划清边界
- 说明为何语义通信离不开原生 AI 和共享知识库
- 解释语义通信"降量"的来源是任务明确,不是压缩更狠
- 列举语义通信不适用的几类典型场景,避免误用
一、问题与直觉:很多任务根本不需要原样还原
传统通信的目标很"轴":把发出去的每一个比特,在接收端原样还原。香农信息论把这件事形式化为"最小化还原误差",七十年来所有通信系统都围绕这个目标优化。问题是,很多任务根本不需要原样。
比如识别一张图里有没有猫。传统通信要把几百万像素的图原样传过去,接收端再跑识别模型;但其实"有猫"两个字就够了,何必传百万像素?再比如远程操控一个机械臂抓杯子,操作员需要的是"杯子的位置、形状、硬度",而不是机械臂视角的高清视频流——传"语义化的抓取信息"远比传原始视频高效。语义通信就是把这个常识变成通信范式——只传完成任务所需的"意义"。
这里的关键洞见是:通信的价值不在"传了多少比特",而在"任务是否完成"。当任务明确时,所需的信息量可能比完整还原少几个数量级。这不是更聪明的压缩(压缩仍以还原为目标),而是目标函数的根本改变。
二、核心原理:两种范式的损失函数之差
比特通信最小化还原误差(均方误差 MSE);语义通信最小化任务误差(如分类准确率、控制成功与否)。两者目标函数不同:
传统: min E[ ||m - g(f(m,h)+n)||^2 ]
语义: min E[ L_task( g(f(m,h)+n), y ) ]
其中 m 是原始消息,f 是编码器,g 是解码器,h 是信道,n 是噪声,y 是任务标签,L_task 是任务损失。注意两者的解码目标完全不同:传统解码器 g 要还原 m,语义解码器 g 要完成任务(输出对齐任务标签 y)。当任务明确(y 定义清晰)时,语义通信能砍掉大量与任务无关的冗余——这就是它的"降量"来源。
图:语义通信 vs 比特通信
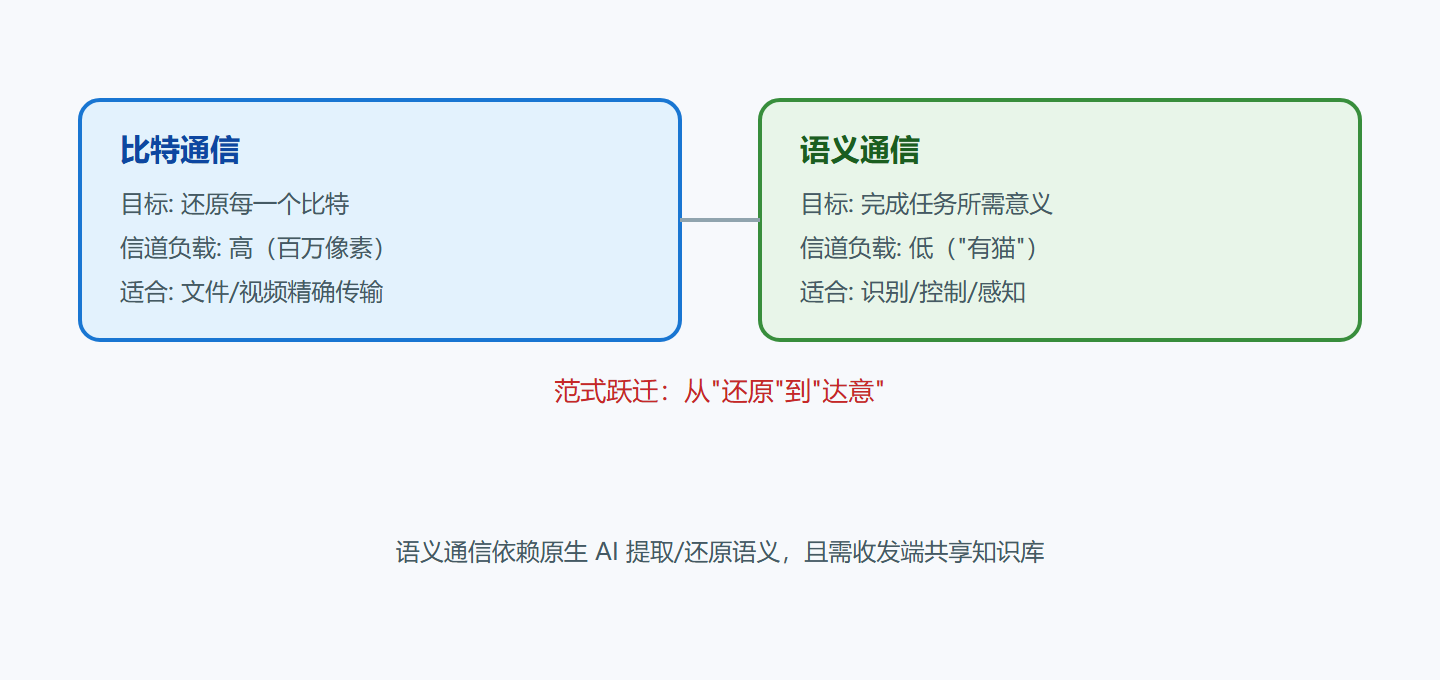
语义通信高度依赖原生 AI:发送端的语义编码器要靠深度模型提取"任务相关语义"(哪些信息对任务有用、哪些是冗余),接收端的语义解码器要靠模型从语义还原"任务结果"。两端还得有共享的"知识库"——这是语义通信和压缩的本质区别。压缩算法的编解码规则是公开固定的(任何解码器都能解),语义通信的编解码依赖收发双方共享的语义先验(双方都得知道"猫是什么"、"抓取是什么"),否则语义对不上。这个共享知识库是语义通信最难工程化的部分,也是它和普通 AI 压缩的分水岭。
语义通信的三层结构
学术界通常把语义通信分成三层,自下而上:
- 语法层(传统通信):关注比特无差错传输,等于香农范式。
- 语义层:关注"意义"的传输,发收双方对"意义"有共识,允许不还原比特。
- 语用层(Pragmatic):关注"意义如何被使用",传输的是"如何行动",强调任务闭环。
6G 语义通信的终极目标是语用层——不只是传意义,而是直接服务于行动决策。比如自动驾驶场景,传的不是"前方有障碍"这个语义,而是"该刹车还是该转向"这个行动建议。层次越高,对共享知识库和 AI 的要求越高。
💡 关键直觉:语义通信的红利来自"任务明确"。任务越明确("有没有猫""抓不抓得住杯子"),可砍掉的冗余越多;任务越模糊("传一部电影给人看"),越该退回比特通信——别为了降量牺牲正确性。判断要不要用语义通信,先问任务清不清晰。
三、工程实践要点:何时用,何时退
| 维度 | 比特通信 | 语义通信 |
|---|---|---|
| 优化目标 | 还原误差(MSE) | 任务误差(L_task) |
| 信道负载 | 高(传全部) | 低(只传任务相关语义) |
| 依赖 | 编解码标准 | 原生 AI + 共享知识库 |
| 适用 | 文件、视频、合同、代码 | 识别、控制、感知、检索 |
| 失败模式 | 比特错误,可检测 | 语义偏差,难检测 |
| 可解释性 | 高(标准编解码) | 低(黑盒模型) |
从这张表能看出语义通信的适用边界很清晰。它适合"任务明确、能容忍语义偏差"的场景:目标检测(传"有什么"而非原始像素)、远程控制(传"操作意图"而非原始视频)、语义检索(传"查询意图"而非原始文本)。这些场景里,失败是软失败(识别错一次、控制偏一点),且任务目标可量化。
它不适合"需要逐字节一致"的场景,这类场景误用语义通信代价很高:
- 文件传输(合同、报表、二进制程序):少一个字节都可能出错,语义通信的"语义偏差"在这里是致命的。
- 加密数据:语义通信对密文做"语义提取"毫无意义,密文本来就是无语义的随机比特。
- 通用视频/音频:人眼人耳对失真敏感,"语义偏差"可能让人明显感知到画质劣化,不如标准压缩。
- 法律/医疗记录:一字之差责任不同,绝不能用语义近似。
⚠️ 常见坑:语义通信不是"万能压缩"。通用文件传输、需要逐字节一致的内容(如代码、合同、加密数据),它没优势,反而因模型误差引入风险。看到"语义通信把视频流量降了 99%"这种宣传,要追问——降的是"还原质量"还是"任务性能"?如果只是把视频压得没法看,那不是语义通信,是劣化压缩。
一个被低估的难点:语义偏差的可检测性
比特通信出错是"硬错误"——CRC 校验不过,马上知道。语义通信出错是"软错误"——模型给出的语义看起来"合理",但实际错了,没有简单的校验机制能发现。比如目标检测把"狗"识别成"猫",输出还是合法的语义标签,单看输出无法判断对错。这对安全敏感场景(自动驾驶、医疗)是致命问题。6G 的语义通信工程化,必须配套"语义置信度估计"和"硬兜底"机制——模型不确定时退回比特通信或请求人工确认。没有这套兜底,语义通信不敢用在高风险场景。
共享知识库的工程难题
语义通信要求收发双方共享知识库,但知识库怎么同步、怎么更新、怎么版本管理,都是开放问题。如果发送端用新版知识库(知道"猫"的新定义),接收端还停在旧版,语义就对不上。在异构网络里,不同厂商、不同代代的设备知识库不一致,会严重限制语义通信的互操作性。这也是为什么语义通信短期内更可能在封闭专网(工业控制、特定应用)落地,而非开放的公网。
一个具体场景:语义通信在工业质检里到底怎么省带宽
把上面的抽象落到一个具体场景会更清楚。设想一条产线上的视觉质检任务:摄像头每秒拍几十张电路板照片,传统做法是把每张几兆的原图传到边缘服务器跑缺陷检测,一条产线几十个工位,回传带宽轻易跑满。换成语义通信后,摄像头端就跑一个轻量缺陷检测模型,只把"有无缺陷、缺陷类型、缺陷坐标"这几个语义字段传回去,每个工位的回传带宽从几兆降到几百字节,降了四个数量级,而质检任务的完成质量几乎不变——因为任务本来要的就是"有没有缺陷",不是"原图好不好看"。
但这个例子里也藏着语义通信的典型坑。第一,摄像头端的模型要够准,如果它把合格品误判成缺陷,下游就会跟着错,而且这种软错误很难靠校验发现,必须配套置信度估计和抽检复核。第二,缺陷类型如果新增了一种(比如换了个新工艺),发送端的模型要重新训练并和下游同步知识库,否则新缺陷传不过去。第三,如果质检任务临时变成"不仅要检测缺陷,还要把缺陷区域的高清图存档供追溯",任务目标就变了,原来传语义字段不够,得退回传原图——任务一变,语义通信的配置就要跟着变。这说明语义通信不是"配一次就一劳永逸"的,它高度绑定任务定义,任务漂移就要重新对齐。这也呼应了前面说的"任务明确"是它红利的前提,任务一模糊,红利立刻消失。
再补一个常被混淆的点:语义通信和边缘计算的关系。很多人把语义通信理解成"把计算推到边缘",其实两者目标不同。边缘计算解决的是"算力在哪",语义通信解决的是"传什么"。两者可以叠加——在边缘跑语义编码器,既省了回传带宽又就近做了任务推理,这是常见的组合拳。但它们不是一回事:一个网络可以边缘计算很强但语义通信完全没用(比如还在传原图到边缘跑识别),也可以用了语义通信但算力仍在中心(语义编码器跑在终端,结果回中心)。把这两个概念分清,你设计系统时就不会把它们搅在一起,能各自独立地评估收益和代价。
本节速览
- 要点一:语义通信优化任务误差(L_task),而非比特还原误差(MSE),目标函数根本不同
- 要点二:降量来源是"任务明确",不是压缩更狠;任务越明确降量越多,任务模糊该退回比特通信
- 要点三:依赖原生 AI 提取/还原语义,且需收发端共享知识库,知识库同步是工程难题
- 要点四:不是万能压缩,文件/代码/合同/加密数据等需逐字节一致的内容不适用,误用代价高
- 要点五:语义分三层(语法/语义/语用),6G 终极目标是语用层(直接服务行动决策)
- 要点六:语义偏差是软错误、难检测,安全敏感场景必须配置信度估计和硬兜底
- 要点七:短期内更可能在封闭专网落地,公网因知识库异构互操作性受限
下一章看安全如何内建到这套体系里——当网络开始懂语义,安全模型也必须升级。