第3章 · 组织规范与群体学习
第 3 章 · 组织规范与群体学习
章节摘要:前两章讲了智能体怎么设计、怎么交互,但静态的协调机制还不够——真实的 MAS 要能持续适应。这一章讲两件事:一是组织结构与社会规范(怎么把群体组织成层级、网络、市场等形态,并用规范约束行为);二是多智能体强化学习 MARL(智能体怎么在交互中边做边学,从经验里演化出协同策略)。读完你会理解 MAS 从"静态协调"走向"动态演化"的关键跃迁。
学习目标
阅读完本章,你应当能够:
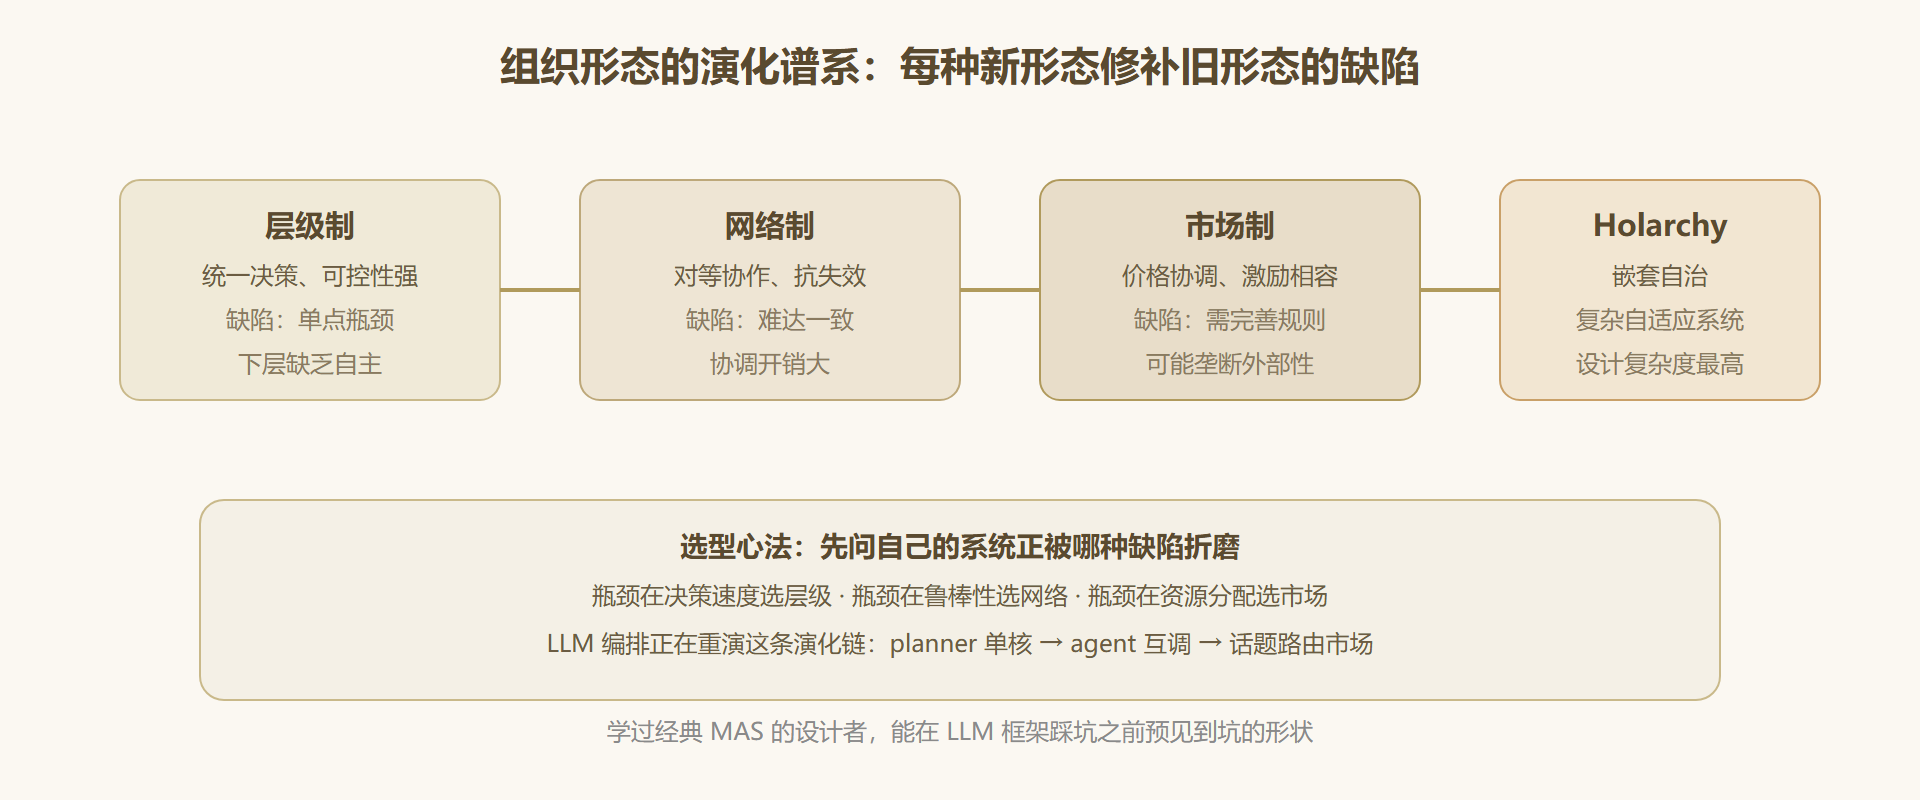
- 区分层级、网络、市场、 Holarchy 这几类组织形态及其适用场景
- 说清社会规范(法律、约定、制度)怎么约束智能体行为
- 解释 MARL 区别于单智能体 RL 的本质——环境内生非平稳性
- 复述 MARL 三大训练范式(CTDE、完全去中心化、分层角色化)的取舍
核心概念速览
组织定骨架,规范定规则,学习让群体在经验里持续变聪明——三者合起来让 MAS 能演化。
子章节导航
3.1 组织结构与社会规范
讲清层级、网络、市场、Holarchy 四类组织形态,社会规范(法律、约定、制度)怎么约束智能体行为,以及规范的内化、监督、演化机制。
3.2 多智能体强化学习
拆解 MARL 区别于单智能体 RL 的本质(环境内生非平稳),讲清三大训练范式(CTDE、完全去中心化、分层角色化),以及信用分配、策略空间爆炸、学习者困境三大技术挑战。
子章节之间的逻辑关系
3.1 讲"群体的组织骨架和行为规则"(自上而下的结构约束),3.2 讲"群体怎么从经验里学习演化"(自下而上的能力增长)。前者是组织设计,后者是能力获取,两者结合让 MAS 既有秩序又能进步。
3.1 组织与规范(结构) ──► 3.2 MARL(学习) │ │ └── 规范定边界,学习在边界内演化 ──┘
从静态组织到动态学习
本章两节构成一个递进:3.1 讲群体的静态骨架(组织和规范),3.2 讲群体的动态演化(学习和适应)。骨架决定学习能往哪个方向展开——层级制里的学习是"下级如何更好地执行",网络制里的学习是"对等者如何达成共识";反过来,学习会重塑骨架——训练出来的强势智能体会事实上占据层级高位,不管组织图上怎么画。理解这层互相塑造的关系,就理解了为什么本章必须两节连读。
图:组织形态的演化谱系
规范与学习的对角关系
组织规范和 MARL 还有一层容易被忽略的对角关系:规范是"设计者注入的先验知识",学习是"群体从经验里长出的后天知识",两者经常互相抵消。规范约束太强,学习探索不出新策略,群体被锁死在设计者的想象里;约束太弱,学习出的策略钻规范的空子,出现 3.2 讲的目标漂移。工程上的平衡手法是把规范做成"可违反但须付出代价"的软约束进入奖励函数,而不是硬性截断动作空间——给学习留下绕过规范的通道,同时让绕过的成本引导它通常不绕。这个设计细节,是规范与学习协作的关键接口。
前置知识与后续延伸
- 前置知识:读过前两章,理解智能体架构和通信交互机制。了解一点强化学习基础(状态、动作、奖励)。
- 后续延伸:本章是经典 MAS 理论。第 4 章进入大模型时代——LLM 怎么改变 MAS 的落地方式,以及工程实践和工具生态。
本章的位置:从"能协作"到"会进化"
前两章解决了单个智能体的构造(第 1 章)和彼此间交换信息(第 2 章),但一群能说话的智能体还不等于一个系统——谁听谁的、冲突怎么裁、经验怎么传,这些问题不解决,群体就只是一盘散沙。本章接手的就是这层"社会结构":组织结构分配权利与职责,社会规范约束行为边界,群体学习让整个系统随经验改进。这三样东西有一个共同特征——它们都是系统级属性,不存在于任何单个智能体内部,只存在于智能体之间的关系里。理解这一点有个实用推论:调试群体行为时,永远不要只盯着单个智能体找 bug,问题几乎总在"关系"上——信息不对称、激励错位、规范含糊。本章三节顺着"静态结构 → 动态行为约束 → 跨时间改进"的顺序展开,读的时候可以时不时问一句:这个机制在约束谁、靠什么约束、违反了会怎样。
预备概念:规范的三种执行方式
进入正文前预备一个后面反复出现的概念。规范的执行方式分三种:强制执行(违反即被系统拦截,如权限检查)、惩罚执行(违反会被记录并扣除信用,如声誉机制)、内化执行(智能体训练时把规范吸收进策略,不再有违反动机)。三者的成本和刚性依次递减,适用场景不同:安全底线用强制,商业协作用惩罚,长期共生的群体用内化。LLM 智能体的提示词约束是第四种——"劝导执行",成本最低也最脆弱,这解释了为什么纯提示词的规范在对抗性场景下频频失守。