4.3 多智能体系统调试与可观测性
4.3 多智能体系统调试与可观测性
本节摘要:多智能体系统的故障大多不在单个智能体内部,而在智能体之间的交互里——这决定了它的调试方法论与单智能体系统有本质差异。本节给出一套完整的可观测性方案:要记录什么(全链路轨迹、决策依据、消息语义)、怎么定位交互故障(回放、消融、影子对照)、怎么建立告警(群体指标的统计异常检测),并说明为什么"可调试性"应该在架构设计阶段就作为一等公民,而不是上线后补救。
为什么多智能体调试难一个量级
先直面这个问题。单智能体系统出故障,排查路径是清晰的:输入是什么、模型输出什么、哪个环节不符合预期,沿着执行流走一遍总能锁定。多智能体系统的故障排查路径是网状的:同一个异常表象,可能源自 A 的语义理解偏差、B 的记忆过期、C 和 D 的指令冲突、或者纯粹是消息乱序——四类根因分布在不同节点,还可能叠加发生。
更麻烦的是涌现性故障。五个智能体各自的行为都符合规格,群体的输出却在缓慢恶化——这种故障没有"肇事者",它在交互模式里,不在任何单点的日志里。工程团队面对这类问题的本能反应是给每个智能体加日志,但单点日志的堆砌并不能还原交互模式,你需要的是专门为多主体交互设计的观测手段。
这节的立场:可观测性是多智能体系统的架构属性,不是运维功能。设计阶段没为观测留位置的系统,上线后的调试成本会随智能体数量指数上升。
要记录什么:轨迹的三个层次
全链路轨迹
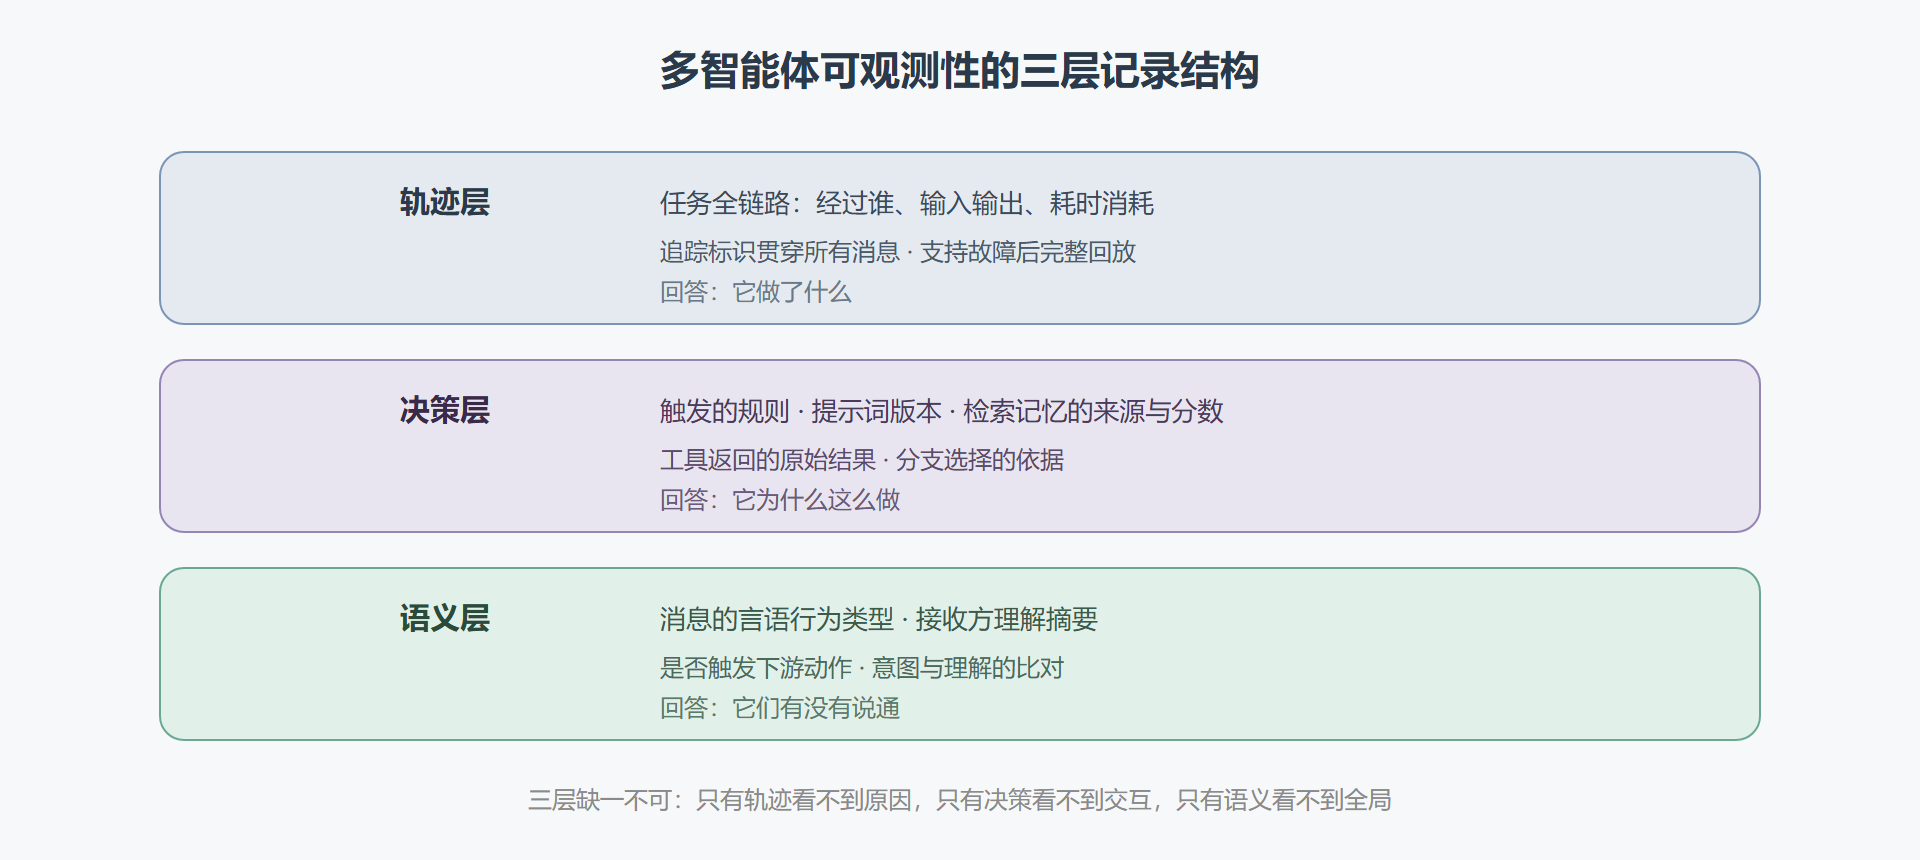
最基础的是全链路轨迹:每个任务从进入到完成(或失败)的完整路径——经过哪些智能体、每一步的输入输出、耗时、消耗。实现上给每个任务分配一个贯穿的追踪标识,所有消息都携带它,这样能把散落在各智能体日志里的碎片串成一条线。
轨迹的价值在回放。故障发生后,用保存的输入重放整条链路,逐步观察状态演化——这是网状故障里最有效的定位手段。要支持回放,记录必须包含每个决策点的完整输入(不只输出),存储成本换调试能力,这笔账在故障发生的那一刻会显得极其划算。
决策依据
比输入输出更深一层的是决策依据:智能体为什么这么做。对规则系统,记录触发的规则;对 LLM 驱动的智能体,记录关键的提示词版本、检索到的记忆片段、工具返回的原始结果。没有决策依据的轨迹只能告诉你"它做了什么",不能告诉你"它为什么"——而调试恰恰是在找错误的原因。
记录决策依据有个工程细节:提示词要记版本而非内容。同一版本的内容可以存在版本库里,轨迹里只存版本号和参数,否则存储成本无法承受。检索到的记忆片段要记来源和相似度分数,这两个字段是诊断"记忆污染"类故障的钥匙。
消息语义
第三个层次专为交互故障准备:每条消息除了内容,还要记录它的言语行为类型(请求、通知、承诺)、接收方对它的理解摘要、以及是否触发了下游动作。接收方的理解摘要是关键——它让"发送方的意图"和"接收方的理解"可以并排比对,语义漂移类故障(2.1 讲过的口径不一致)在这种记录下一眼可见。
图:可观测性的三层记录结构
交互故障的三种定位手法
有了记录,故障定位有三件趁手的兵器。
回放定位法适用于可复现故障:用故障时段的输入重放轨迹,在可疑节点插入断言(此处 B 应该已收到 A 的承诺),二分定位第一个断言失败的节点。工程要点是回放环境要能冻结外部依赖(工具返回、检索结果用录制值),否则重放时外部状态已变,故障无法复现。
消融定位法适用于疑似多因叠加:逐个禁用某些智能体或机制(关掉审查 agent、绕过某个协调规则),观察故障是否消失。消融的顺序有讲究——先消融最近变更的部分(新加入的 agent、新启用的规则),多数交互故障由变更引入。注意消融本身可能改变群体行为模式,结论要用多次运行取多数。
影子对照法适用于涌现性故障:并跑一个简化版系统(比如单体版或规则版)处理同样的输入流,对比两边的群体指标分歧点。分歧点不一定是故障点,但它标出了复杂系统"偏离可理解行为"的位置,是排查的最好起点。影子对照的代价是双倍计算,通常只在排查疑难时临时开启。
群体指标的告警设计
单机系统告警看阈值(延迟超过多少毫秒),多智能体系统的告警要看统计形态。原因是个体指标的波动被群体交互放大或抵消,绝对阈值要么误报频繁要么迟钝。实用的做法是给群体指标建基线分布(按小时段、任务类型分组的历史统计),告警触发在"分布偏移"上——比如任务完成率的日分布突然左移、消息量与任务量的比值骤变(大量协调消息没有产出,往往在死循环或无效协商)。
有三个群体指标特别值得建告警。协调开销比:协调类消息占总消息的比例,健康系统里它应稳定在低位,持续攀升说明机制在空转。重试率:任务被退回重做的比例,它上升通常比最终失败率更早暴露问题。语义分歧率:发送方意图与接收方理解不一致的消息占比,这个指标需要语义层的记录支撑,但对本体漂移类慢性病的预警价值极高。
⚠️ 常见坑:只给最终结果建告警(任务成功率、总耗时),不给过程指标建告警。多智能体系统的故障有很长的潜伏期——目标漂移、记忆污染、机制空转都会先表现为过程指标的缓慢劣化,最后才爆发为结果故障。过程指标告警是在病发前体检,结果指标告警是进了急诊室才有反应。
常见疑问解答
记录这么全,存储和成本压力怎么控?
分级保留是标准做法:轨迹层全量保留七到十四天,之后只保留故障任务和抽样任务的完整记录;决策层只保留失败和低置信度决策的详情;语义层做聚合统计而非逐条保留。再配一个"故障冻结"机制——群体指标告警触发时,自动冻结故障窗口内所有层的完整记录供排查。
LLM 驱动的系统输出不确定,回放怎么保证一致?
严格一致做不到(模型采样有随机性),实用做法是记录采样参数并在回放时固定随机种子,能大幅提高一致性;对仍然漂移的环节,回放目标从"精确复现"降级为"模式复现"——观察交互模式的形态是否重现异常,这通常已足够定位。
小团队没有精力建全套,最低配置是什么?
三样:贯穿的追踪标识(把日志串成线)、每步输入输出的留痕(支持基本回放)、一个群体过程指标(协调开销比或重试率)。这三样的实现成本大约一天,能覆盖最常见的两类故障(链路断裂和机制空转)的定位需求,是性价比最高的起步配置。
收获清单
- 多智能体故障在交互里不在个体里,单点日志的堆砌无法还原交互模式,需要专门的观测设计。
- 三层记录:轨迹层看行为、决策层看原因、语义层看沟通,缺一层就有一类故障不可见。
- 三种定位手法:回放(可复现)、消融(多因叠加)、影子对照(涌现性),按故障形态选用。
- 告警看统计形态不看绝对阈值,协调开销比、重试率、语义分歧率是三个高价值过程指标。
- 可调试性是架构属性:设计阶段不留观测位置,上线后调试成本随智能体数量指数上升。
一个完整的排错案例:循环踢皮球
给一个具有代表性的真实故障形态。某内容生产流水线(选题 → 撰写 → 事实核查 → 合规审查四节点)上线两周后出现"踢皮球循环":核查节点以"来源不足"打回撰写,撰写补充后合规又以"新增内容未核查"打回核查,两个节点互相打回十一轮直到 token 预算耗尽。链路追踪还原的过程值得复述:第一步看 trace 的节点转移图,发现核查和合规之间的往返边异常粗;第二步读往返消息原文,识别出打回理由其实是两条不同规范在打架(来源规范要求全量引用,合规规范限制引用数量);第三步定位根因——两个节点的规范文档由不同团队维护,从未对齐。修复分三层:立即层给两个节点加了打回计数器(超过三次强制升级人工),策略层统一了两份规范的引用条款,结构层把"来源合规"判定合并为一个前置节点。这个案例的可复用教训是:多智能体的故障极少是单个节点的模型能力问题,几乎总是节点间契约的问题——而契约的维护需要治理机制,不是写完一次就完事。
可观测性的最小可行配置
补一份"从零开始"的最小配置,按优先级排列。第一级,全链路 trace id 加每节点输入输出的结构化日志,没有这个,任何故障都是盲调。第二级,节点转移计数与循环检测,超阈值告警。第三级,每节点的 token 消耗与耗时分位统计,成本异常往往先于功能异常暴露问题。第四级,人工抽检队列,按失败率采样留档。这四级配置在多数框架里各需半天到两天工作量,性价比远高于先上全套 APM。一个常被低估的细节:日志里要保存模型的"思考过程"(推理轨迹或中间消息)而不只是最终输出——多智能体的故障现场往往藏在中途消息的措辞变化里,只存结果等于扔掉案发现场。
最后给一个排错优先级口诀:先查契约,再查上下文,最后才怀疑模型。真实故障的分布里,接口契约问题(字段缺失、格式漂移、规范冲突)占一半以上,上下文问题(信息丢失、注入、超长截断)占三成,纯模型能力问题不足两成。把排查力气按这个比例分配,平均定位时间能缩短一半以上——多数人栽在顺序颠倒,对着最强幻想的"模型变笨了"穷追猛打,而现场其实是一个字段名拼错了。