5.4 生产事故验尸:core dump 分析实战
5.4 生产事故验尸:core dump 分析实战
Core dump 是进程异常终止时内存映像的完整快照(代码、数据、栈、寄存器)。生产进程猝死后现场即焚,core dump 是唯一能带回答辩的"尸体"——在测试机上用 GDB 解剖它,就能还原死亡瞬间的一切。本节讲配置、解剖流程与常见死因判读。
第一步:让系统真的会产生 core
默认配置下很多机器根本不落 core,案发后两手空空。三项检查:
# 1. core 大小限制(很多发行版默认 0) ulimit -c # 输出 0 就不会落 core ulimit -c unlimited # 服务启动脚本里设置 # 2. 落盘路径与命名(含 pid 方便多实例) cat /proc/sys/kernel/core_pattern echo '/var/coredump/core.%e.%p.%t' > /proc/sys/kernel/core_pattern # %e 程序名 %p 进程号 %t 时间戳 # 3. systemd 服务要在单元里设 LimitCORE=infinity
容器环境还有一层:core 默认落在容器文件系统内,容器一销毁尸体就火化了。正确做法是把 coredump 目录挂载为持久卷,或改用 coredump 管道模式交给外部程序收集。磁盘要有预算——一个大堆的 Java/原生进程的 core 可以到几十 GB。
解剖流程
把 core 拉到同架构的测试机,配对当时构建的二进制与符号:
gdb ./myapp /var/coredump/core.myapp.3121.1693120400
(gdb) bt # 死亡时的调用链 #0 0x00007f... in raise () from libc #1 0x00007f... in abort () from libc #2 0x0000556... in orders_gc (self=0x5581f2c0) at gc.c:210 #3 0x0000556... in worker_main (arg=0x7f00a800) at worker.c:88 (gdb) frame 2 (gdb) info locals # 死亡瞬间的局部变量 cur = 0x0 ← 悬空指针 (gdb) info threads # 全部线程各自的死亡位置
这份案卷已经能定罪:GC 线程在 gc.c:210 解引用了空指针 cur。配合 thread apply all bt 看其他线程在做什么,基本可以还原死亡前一刻的全系统状态。
验尸的标准动作序列
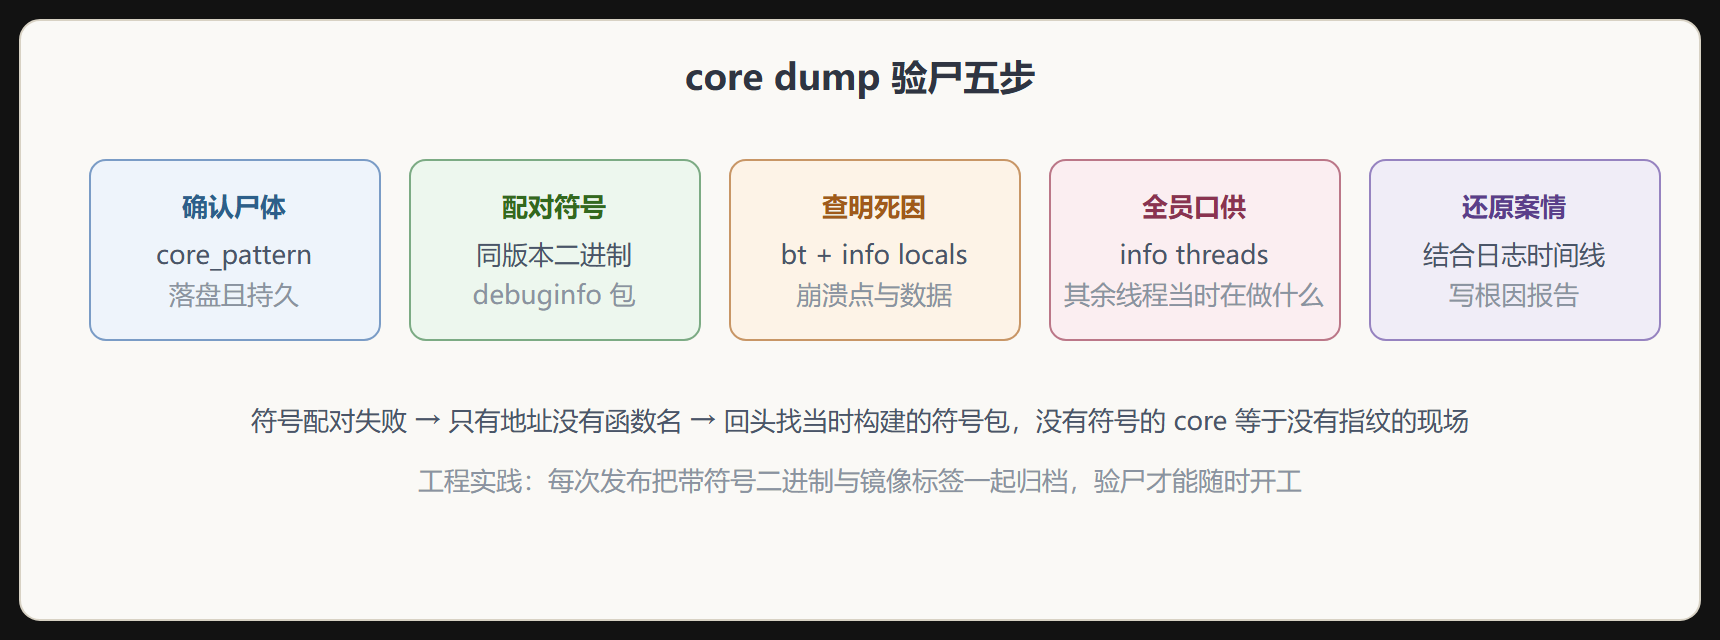
常见死因的判读模式
模式一:SIGSEGV,栈里悬空指针(本案)。基本是空指针解引用或 use-after-free。info locals 的可疑值加上游回溯通常足以定罪;若怀疑释放后使用,回头看第 5.3 节,在测试环境用 ASan 重演。
模式二:SIGABRT,栈顶是 abort/assert。 主动自杀而非他杀——某个断言或库的内部一致性检查失败。看 assert 的表达式即可定位。
模式三:SIGSEGV 但栈本身是坏的(bt 全是乱地址)。栈被写溢出破坏了,典型于局部数组越界。换 info registers 看栈指针位置,用 core 里的内存映像手工恢复线索;预防靠 ASan 提前布控。
模式四:堆内存早已损坏,崩溃在无害代码。 malloc 内部校验失败炸在分配器里,真凶在更早的越界写。这类案子的 core 只能证明"死于内伤",抓真凶要回到测试环境复现加 ASan。
💡 关键直觉:core 是死亡瞬间的快照,不是死亡过程的录像。它告诉你"死的时候在哪",要还原"怎么走到这一步",得结合应用日志的时间线交叉分析——快照 + 日志流水,验尸才有完整叙事。
与运行时工具的配合
core dump 属于事后证据,与事前/事中工具形成三段接力:
| 阶段 | 工具 | 证据形态 |
|---|---|---|
| 事前(测试) | ASan/TSan/UBSan | 主动布控,当场抓获 |
| 事中(生产) | 低扰动采样、日志 | 趋势与时间线 |
| 事后(崩溃) | core dump + GDB | 死亡快照 |
一套健全的工程实践三段都有:CI 里 sanitizer 常开,生产里指标与结构化日志常开,core 配置常备。任何一段缺失,对应的案件类型就只能靠猜。
本节要点回顾
- 三项配置先于事故:ulimit、core_pattern 带元数据命名、容器持久卷,缺一尸体即失;
- 符号配对是验尸前提:每次发布归档带符号二进制;
- bt 定死因、info locals 看数据、info threads 拿全员口供,三命令完成主体解剖;
- 栈损坏与堆内伤类案件 core 只能证明死相,真凶要回测试环境用 ASan 重演;
- core 是快照不是录像,叙事要靠日志时间线补全。
延伸:core 采集链路的健康检查
很多团队配了 core_pattern 却在真出事时发现 core 没落盘:磁盘满、ulimit 仍是 0、容器里路径未挂载、或 apport/abrt 吞了 core。健康检查要做成定期演练:
cat /proc/sys/kernel/core_pattern # 推荐管道模式, 由脚本落盘并限制大小 # |/usr/local/bin/core-save %e %p %s %t ulimit -c unlimited # systemd 服务需在 unit 里设 LimitCORE=infinity kill -SEGV $$ 2>/dev/null; sleep 1; ls -lh /var/case/ | tail -2 # 演练: 真生成一个 systemctl show svc -p LimitCORE # 容器/服务双重确认
演练里生成的"合成 core"同时验证了大小上限、压缩与上传策略。事故时缺的不是 GDB 技术,是这份提前打通的链路。
延伸:验尸报告的证据等级标注
core 分析结论要区分证据等级:寄存器与栈内存是"一手证据";符号化后的回溯是"二手证据"(可能被破坏或越界写污染);从堆对象反推的业务状态是"推理"。报告模板里给每条结论标等级,例如"$rdi 指向已释放对象(一手)→ 该对象在 3.7s 前被 timer 回调释放(释放栈,二手)→ 疑似定时器与请求并发未同步(推理)"。标注等级的验尸报告能直接指导修复:一手证据支撑的结论当天改,纯推理的结论先补探针再动手。