4.1 制造与设备孪生实战
4.1 制造与设备孪生实战
本节摘要:制造是数字孪生最早、最成熟的落地领域,因为制造业天生就在跟物理设备、工艺流程、生产数据打交道。本节按三个层次讲制造孪生:产品孪生(在设计阶段验证产品)、产线孪生(优化生产工艺)、工厂孪生(全局调度与决策)。每层的目标、数据、模型都不一样,理解这个分层,你就能判断自己的制造孪生该从哪层入手。
学习目标
阅读完本节,你应当能够:
- 区分产品孪生、产线孪生、工厂孪生三个层次的目标和范围
- 说清产品孪生在设计阶段的价值(减少物理原型)
- 解释产线孪生怎么优化工艺参数
- 理解工厂孪生做全局调度需要哪些数据和能力
- 说出制造业为什么是数字孪生的天然主场
一、问题与直觉
制造业有个天然的痛点:试错成本极高。设计一个新产品,要造物理原型来测试,一轮原型几十上百万,测出问题改设计再造一轮,循环好几轮,时间和金钱都烧不起。一条新产线投产,工艺参数要反复调试,调不好废品率高、产能上不去。一个工厂的产能分配,要在多个订单、多条产线、多种约束之间找平衡,靠人工调度往往不是最优。
这三个痛点,恰好对应数字孪生的三个层次。产品孪生用虚拟原型替代物理原型,在设计阶段就验证产品性能,把试错从物理世界搬到数字世界,成本和周期都大幅下降。产线孪生用虚拟产线模拟生产过程,在数字空间里试不同工艺参数,找到最优配置再落地。工厂孪生把整个工厂映射到数字空间,做全局的实时调度和决策优化。
制造业之所以是孪生的天然主场,就是因为它的每个环节都有“物理试错代价高”的特点,而孪生正是用数字试错替代物理试错。波音在 777X 研发里用数字孪生砍掉一半物理原型测试,省几十亿美元,就是产品孪生价值的典型例证。
二、核心原理
2.1 产品孪生:在设计阶段验证
产品孪生是最早成熟的一层,它的范围是一个产品(或关键部件),目标是在设计阶段就验证产品性能,减少物理原型。技术上,它主要是高保真机理模型——用有限元算结构强度、用计算流体力学算气动性能、用多体动力学算运动特性。
产品孪生的价值在两个场景特别突出。一是设计验证:产品还没造出来,先在数字空间里跑各种工况,看设计能不能扛住。二是设计优化:用优化算法在数字空间里搜索更好的设计方案,比如在满足强度约束下找到最轻的结构。这两个场景都把原本要靠物理原型才能做的验证和探索,前置到了纯数字阶段,省时省钱。
注意最后一步还是要做物理原型确认——数字孪生再准,也不能完全替代物理测试,因为模型总有偏差。孪生的价值是大幅减少物理原型的轮次,而不是彻底消灭它。
2.2 产线孪生:优化工艺参数
产线孪生的范围是一条生产线,目标是优化生产工艺。它要模拟的不只是单个设备,而是多个设备连起来的整个生产流程——原料进去、经过一道道工序、成品出来。
产线孪生的典型应用是工艺参数优化。一条产线上有很多可调参数(温度、压力、速度、时序),不同的参数组合产出不同质量、不同产能、不同能耗的产品。靠人工经验调参,很难找到全局最优;用产线孪生,可以在数字空间里穷举或智能搜索大量参数组合,找到让良率最高或成本最低的那组配置。
产线孪生的难点是建模复杂——它不光要建每个设备的模型,还要建设备之间的耦合关系(前道工序的输出是后道工序的输入),还要考虑产线的动态行为(设备故障、节拍不均)。所以产线孪生通常用离散事件仿真加设备机理模型的混合方式。
2.3 工厂孪生:全局调度
工厂孪生的范围是整个工厂,目标是全局的实时调度和决策。它把工厂里所有的产线、设备、物料、订单、人员都映射到数字空间,支持跨产线、跨车间的协同优化。
工厂孪生的典型应用是生产排程。一个工厂同时有多个订单要交付、多条产线可用、原料和产能有约束,怎么排产能让交期最优、产能利用率最高、库存最低?这是个高度复杂的优化问题,靠人工排程很难做到全局最优,工厂孪生结合实时状态和优化算法,能动态生成和调整排程。
工厂孪生是三层里最难的,因为它要整合最广的数据、协调最多的子系统、处理最复杂的约束。它通常建立在产品孪生和产线孪生之上——得先把每个产品和每条产线数字化了,才能拼成整个工厂的孪生。
| 层次 | 范围 | 目标 | 核心技术 | 典型价值 |
|---|---|---|---|---|
| 产品孪生 | 单个产品/部件 | 设计验证与优化 | 高保真机理仿真 | 减少物理原型 |
| 产线孪生 | 一条生产线 | 工艺参数优化 | 离散事件+机理模型 | 提升良率产能 |
| 工厂孪生 | 整个工厂 | 全局调度决策 | 集成平台+优化算法 | 最优排程与协同 |
三、工程实践要点
3.1 从哪层入手
三个层次,从哪层入手取决于企业的痛点和成熟度。设计驱动型企业(如航空、汽车),产品孪生价值最大,优先做。生产型企业(如化工、材料),产线孪生的工艺优化价值最大。多工厂、多产线的集团企业,工厂孪生的全局调度价值最大。
但不管最终想做哪层,都建议从底层的设备孪生和数据采集做起。没有设备级的数据和模型基础,产线和工厂孪生就是空中楼阁。见过不少企业一上来就要做工厂孪生,结果连单台设备的数据都没采全,最后只能做个可视化大屏。
⚠️ 常见坑:好高骛远,跳过产品和产线层直接做工厂孪生。没有底层数据和模型支撑,工厂孪生只能是个空壳可视化,谈不上调度优化。三层要自下而上逐步建设,跳级必翻车。
3.2 制造业的数据基础优势
制造业做孪生有个别的行业没有的优势:数据基础相对好。现代工厂普遍有 MES(制造执行系统)、SCADA(数据采集与监控)、ERP(企业资源计划),设备运行数据、生产工单数据、物料数据都已经数字化了。这意味着做孪生的数据管道不用从零搭,可以直接对接现有系统。
短板是这些系统往往是烟囱式的——MES 管MES的、SCADA 管SCADA的、ERP 管 ERP 的,数据标准不统一、接口不开放。孪生项目的第一关往往不是建模型,而是把这些系统的数据打通、对齐、清洗。这个数据治理的活儿枯燥但绕不开。
3.3 ROI 是绕不过的关
制造业对投入产出特别敏感,孪生项目必须能算清 ROI(投资回报率)。一个孪生项目花了几百万,省了多少废品、提升了多少产能、减少了多少非计划停机,这些要能量化。算不清 ROI 的项目,在企业里很难拿到持续投入。
💡 关键直觉:制造孪生别追求“高大上”,要追求“算得清账”。从 ROI 最明确的场景切入(比如某个高故障率设备的预测性维护),先把账算清楚、把价值做实,再逐步扩展。一个省了几百万维护费的设备孪生,比一个漂亮但说不清价值的工厂大屏,在企业里活得久得多。
本节要点回顾
- 三层孪生:产品孪生(设计验证)、产线孪生(工艺优化)、工厂孪生(全局调度),范围递增、难度递增。
- 产品孪生价值:用数字原型替代物理原型,大幅减少试错成本,但不能完全消灭物理测试。
- 产线孪生价值:在数字空间搜索最优工艺参数组合,提升良率和产能。
- 工厂孪生价值:全局实时排程调度,协调多产线多订单。
- 入手顺序:从底层设备和数据做起,自下而上,别跳级。
- 制造业优势:数据基础好(MES/SCADA/ERP),但系统烟囱化,数据治理是第一关。
- ROI 导向:从能算清账的场景切入,价值做实再扩展。
下一节我们看更复杂的城市与能源孪生,它们把孪生从单体推向系统,也带来新的挑战。
四、设备孪生的四阶段成熟度模型
图:制造孪生落地四阶段
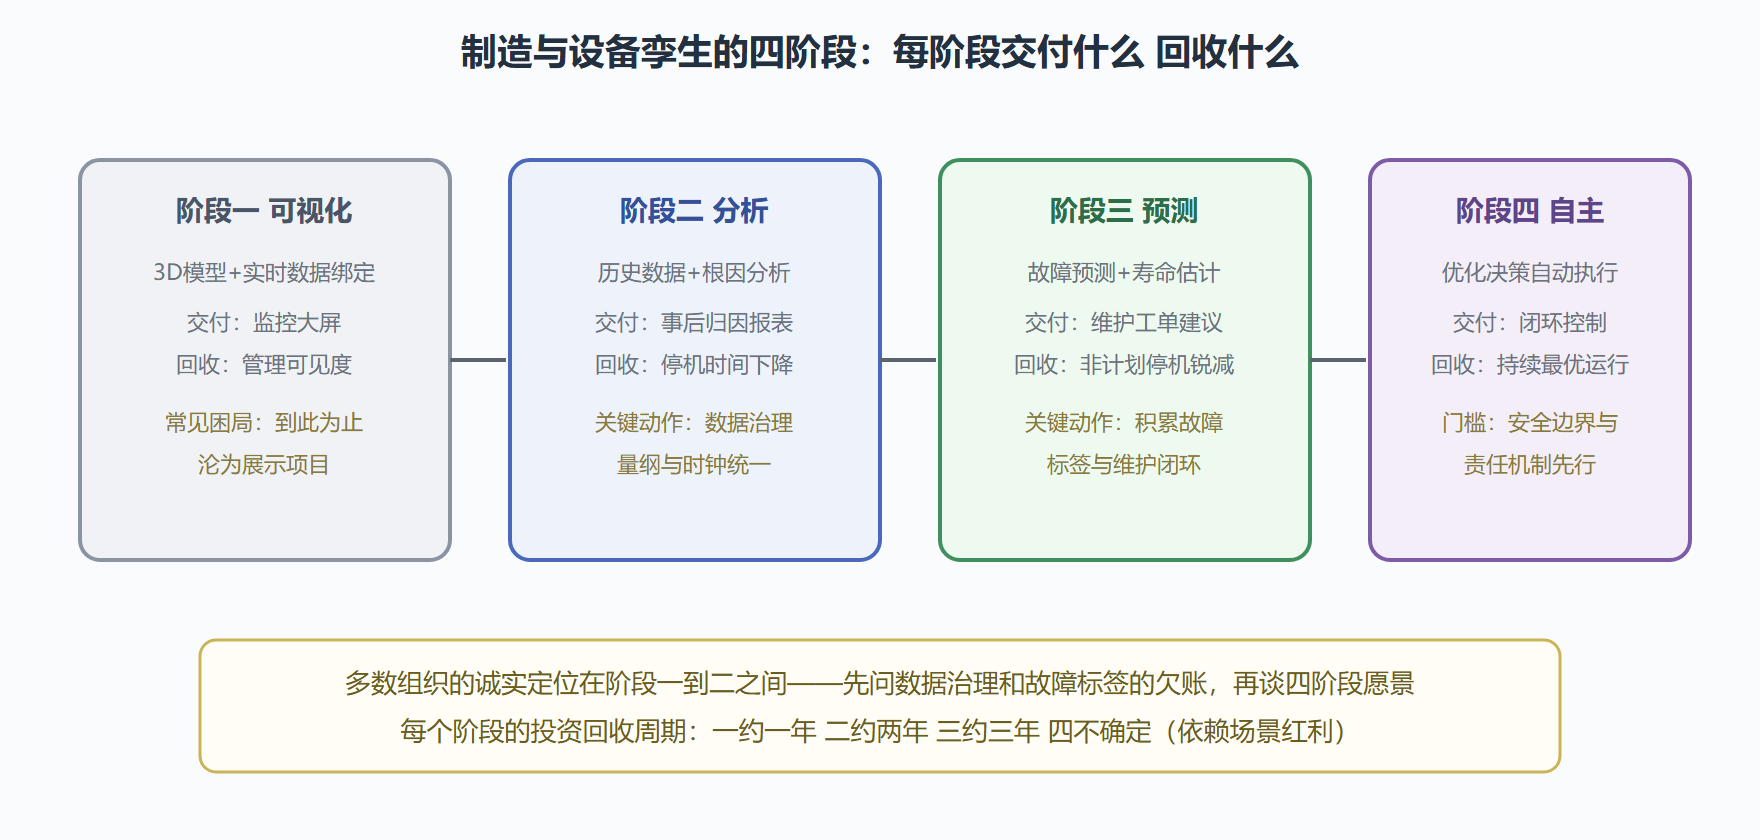
这张成熟度图的用法是"对号入座再前进一格"。给自己组织的现状定位时,用交付物判断而不是用愿景判断——如果孪生系统最重的产出是给领导看的大屏,无论宣传语多先进,你就是阶段一。前进一格的关键动作已标注在卡片下方,其中最值得注意的是从阶段二到阶段三的门槛不是算法而是故障标签的积累:没有拆检记录回流,预测模型永远停在论文里。这解释了为什么深耕多年的老工厂反而更容易建成阶段三孪生——它们的维护工单系统里躺着十年的故障标签。
五、从案例提炼的三条可迁移经验
把制造孪生的实战经验压缩成三条可迁移的判断。第一,数据治理决定天花板:所有成功案例的访谈里,团队都把数据清洗和标签回流列为最花时间的事,反而是模型部分被描述为"标准件"。评估任何孪生项目的风险,先看它对数据治理的预算分配,占比太低的基本是外行方案。第二,从单设备单场景切入:成功案例的起点清一色是最痛的单台设备(最高停机成本的产线、最难抢修的机组),而不是覆盖全厂的平台规划。单点跑通沉淀的模板和方法论,才是规模复制的本钱。第三,维护工单是金矿:拆检记录、更换件清单、故障描述这些非结构化工单文本,是故障标签最丰富的来源,把它们数字化并结构化,等于给预测模型喂了十年的经验。三条经验背后是同一个朴素逻辑——数字孪生的竞争不在算法精度,在数据资产的组织能力。