5.1 数字孪生项目落地路线图
5.1 数字孪生项目落地路线图
本节摘要:数字孪生项目失败率高,主因不是技术不行,而是推进路径错了——要么场景没选好,要么闭环没打通,要么急于求成跳级建设。本节把一个孪生项目从零到闭环拆成六个阶段:选场景、搭数据管道、建模型、验证可信度、打通反馈、迭代优化,每阶段讲关键动作和常见坑,给你一个能照着走的实施框架。
学习目标
阅读完本节,你应当能够:
- 制定一个数字孪生项目的六阶段落地路线图
- 用“决策价值”标准筛选出值得做的首批场景
- 说清模型验证为什么必须多工况、留出验证集
- 解释反馈通道打通的组织难点
- 识别“只建不闭”“跳级建设”等常见失败模式
一、问题与直觉
数字孪生项目有个尴尬的现实:概念很热,但真正跑出价值的案例比例不高。很多企业投入不少,最后得到的只是一个可视化大屏,离“智能孪生”差得远。复盘这些不太成功的项目,失败原因往往不是技术能力不够,而是推进路径出了问题。
最常见的三种失败模式:一是场景没选对,选了个决策价值低的设备做孪生,做完了没人用;二是闭环没打通,模型建了、预测做了,但结果没接回控制,孪生体停在“展示”档;三是急于求成,跳过基础直接上高阶能力,根基不稳全线崩塌。
要避开这些坑,得有一套清晰的推进路径。下面这个六阶段路线图,是经过实践检验的框架,按顺序走能大幅提高成功率。
二、核心原理
2.1 六阶段路线图
阶段一:选场景与定目标。 这是决定项目成败的第一步。不是所有设备都值得做孪生,要用“决策价值”来筛——这个设备出问题的代价有多高?优化它运行的收益有多大?选那个决策价值最高的设备做首批试点。同时明确目标:是降故障率、提产能、还是省能耗?目标要可量化,否则做完没法评估价值。
阶段二:搭数据管道。 选好场景后,第一件事是搭数据管道——把设备的运行数据采上来、清洗干净、存进时序库。这一步要解决协议接入、边缘预处理、时序存储等问题(详见第 2 章)。数据管道是后续一切的基础,数据质量不行,后面模型再好也白搭。
阶段三:建模型。 数据有了,开始建模。先从最简单的模型做起——哪怕是阈值报警,先把基线立起来。然后逐步引入统计方法、机理模型、数据驱动模型。别一上来就上最复杂的模型,简单模型能快速验证数据管道和闭环的可用性。
阶段四:验证可信度。 模型建出来,必须用实测数据验证它的可信度。验证要覆盖多种工况,且要用模型没见过的数据(留出验证集)。模型可信度不达标,绝不能进下一阶段——拿不准的模型下发给控制,出了事谁负责。
阶段五:打通反馈通道。 这是大多数项目卡住的地方。把模型预测结果接回控制系统,涉及 OT 安全、责任界定、人机协同(详见第 3 章)。这阶段要多和 OT 部门、运维部门协同,设计自动决策的边界和人工确认的环节。
阶段六:迭代优化与扩展。 闭环跑起来后,持续用新数据优化模型、扩展场景。孪生项目不是一次性工程,模型会随设备老化、工况变化而漂移,必须持续迭代。首批场景跑通后,再复制到其他设备。
2.2 用决策价值选场景
阶段一的“选场景”值得展开讲,因为它是决定成败的关键。判断一个场景值不值得做孪生,用两个维度:故障代价和优化空间。
故障代价高的设备(一旦故障停产损失大的关键设备),做预测性维护价值大。优化空间大的设备或工艺(当前运行效率离最优有差距的),做优化价值大。两个维度都高的,是首选试点对象。两个都低的,别浪费资源。
| 维度 | 高 | 低 |
|---|---|---|
| 故障代价高 | 首选:做预测性维护 | 次选:基础监控即可 |
| 故障代价低 | 可选:做优化 | 不做:性价比太低 |
2.3 成熟度阶梯:别跳级
第 1 章讲过三类形态(模型、影子、孪生)和三级成熟度(描述、预测、规范)。项目推进要顺着这个阶梯走,不能跳级。还在数字模型阶段,别急着铺物联网;还在数字影子阶段,别急着上预测模型;还在描述性阶段,别急着做自动控制。每升一级,技术复杂度和风险都阶跃式上升,跳级往往意味着翻车。
三、工程实践要点
3.1 快速跑通一个最小闭环
项目启动后,最重要的事是尽快跑通一个最小的端到端闭环——哪怕这个闭环很糙(数据采集简单、模型粗糙、反馈靠人工)。跑通闭环的价值在于:它能验证整条链路是否通顺、暴露所有隐藏的集成问题、让团队和干系人看到雏形。
见过不少项目,花大半年憋一个高精度的模型,结果拿出来发现数据管道有 bug、反馈接口对不上、运维不配合,整个闭环根本转不起来。先跑通粗糙闭环再精修,比憋大招稳得多。
⚠️ 常见坑:追求完美,憋大招,半年才出第一个版本,结果发现闭环根本转不起来。正确做法是先跑通最小闭环(哪怕粗糙),再迭代精修。敏捷思想在孪生项目里同样适用。
3.2 自建还是用平台
搭孪生系统,有个绕不开的取舍:自建还是用现成平台。主流平台(如微软 Azure Digital Twins、英伟达 Omniverse、西门子 Xcelerator)提供了数据建模、仿真、可视化的集成能力,能省大量基础开发工作。但平台也有锁定风险、定制灵活性受限、许可成本高等问题。
判断标准:如果你的需求比较通用(设备监控、基础预测维护),用平台更快;如果需求高度定制(特殊机理模型、特殊集成),自建更灵活。折中做法是用平台做底座(数据管理、可视化),自建核心模型和算法。
3.3 数据治理要前置
前面反复强调数据是基础,这里再强调数据治理要前置。很多项目到后期才发现数据质量不行(时间戳不对齐、传感器漂移、数据缺失),回头补数据治理,耽误进度。正确做法是项目一开始就建数据质量监控——实时监控完整性、准确性、一致性,发现问题立即修。
💡 关键直觉:孪生项目的成功率,前期(选场景、搭数据)决定一半,闭环期(打通反馈、迭代)决定另一半。模型算法本身反而只占两三成。把精力平衡分配到六个阶段,别把宝全押在模型上。
本节要点回顾
- 六阶段路线图:选场景→搭数据→建模型→验证→打通反馈→迭代,按顺序走。
- 选场景:用决策价值(故障代价×优化空间)筛选,首选两维都高的设备。
- 不跳级:顺着形态和成熟度阶梯走,每级技术复杂度阶跃上升。
- 最小闭环:先跑通粗糙的端到端闭环,再迭代精修,别憋大招。
- 自建vs平台:通用需求用平台快,高度定制自建灵活,可平台做底座加自建核心。
- 数据治理前置:一开始就建数据质量监控,别到后期才发现数据不行。
- 精力分配:前期选场景搭数据占一半,后期闭环迭代占一半,模型只占两三成。
下一节讲贯穿全程的核心权衡——保真度和实时性怎么平衡,这是孪生项目技术决策的底层逻辑。
四、路线图的阶段门机制
图:项目落地的阶段门与交付物
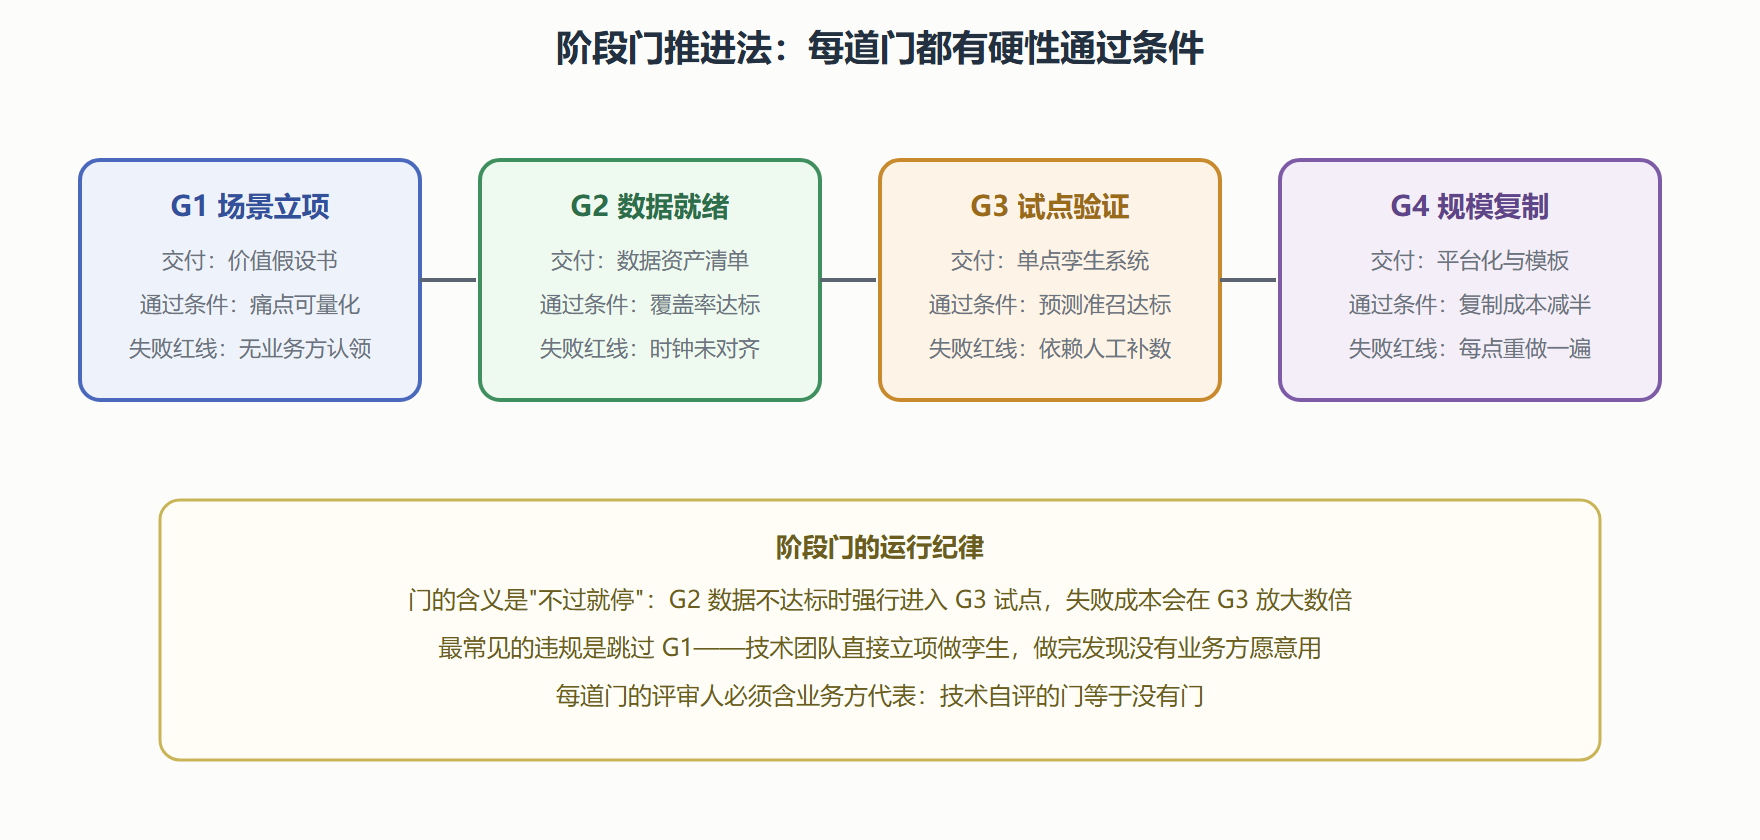
阶段门机制的价值不在图本身,而在它把"何时止损"从艰难的临时决策变成预设的规则。数字孪生项目最常见的死法不是技术失败,而是沉没成本绑架——数据治理做了半年,明知场景不成立也不忍心停。把 G1 的"业务方认领"设为硬条件,本质是在项目最便宜的时刻引入最强的否决权。
五、路线图的时间盒与角色配置
补充路线图的执行细节。时间盒:G1 到 G2 的数据就绪阶段常被严重低估,存量设备的传感器补装、点位核对、时钟对齐,三百台设备的规模通常需要六到九个月——把它压到两个月的计划,后面会用双倍的返工偿还。试点验证(G3)建议固定四到六个月的时间盒,拖长不会提高成功率,只会让团队疲态暴露。角色配置:最小核心团队是四个角色——业务负责人(有预算签字权)、数据工程师(占工作量一半)、领域建模专家(机理把关)、算法工程师;项目经理可以兼任,但业务负责人不可缺席,这是 G1 阶段门"业务方认领"的组织保障。外协策略:几何建模、平台部署这类标准件可以外包,数据治理和故障标签这两件事绝不能外包——它们是核心资产,外包团队做完就走了,组织里什么都没留下。
六、常见失败模式的病理切片
路线图之外,补三个失败项目的病理切片,比成功学更有诊断价值。病理一:大屏驱动型。立项的原始动机是领导要一个展示系统,所有资源流向可视化层,数据治理和智能层形同虚设。病理特征是演示数据与真实数据永远"还在打通中";死亡时间是第二年的预算评审会。病理二:技术理想型。团队被全要素孪生的愿景点燃,第一年就在建模精度上无限投入,迟迟不交付任何可用的决策功能。病理特征是模型越做越精、业务方越来越沉默;死亡时间是里程碑评审。病理三:数据裸奔型。跳过 G2 阶段门强行试点,模型建立在时钟不同步、量纲混乱的数据上,效果不稳定,团队陷入"调参-失效-再调参"的循环。病理特征是任何人问"效果为什么波动"都没有答案;死亡时间是信任耗尽。三种病理的处方是同一张阶段门清单——区别只在从哪道门开始补课。
结尾补一句关于文档的话:路线图落地过程中最值得写的三份文档是数据资产清单(G2 的交付物)、决策闭环记录(每次孪生建议与实际执行的对照)、以及失败决策的复盘笔记。前两份是组织资产,第三份是模型进化的原料——没有复盘回流的孪生项目,三年后和第一年一样幼稚。