3.3 多目标优化与决策闭环
3.3 多目标优化与决策闭环
本节摘要:前面两节讲了诊断和预测,这节讲最高一层能力——多目标优化,回答“该怎么调最好”。真实场景里,要同时优化的目标往往互相冲突(产能要高、能耗要低、寿命要长),不存在一个让所有目标都最优的解。本节讲帕累托前沿的概念、多目标优化算法的思路,以及怎么把优化结果接回控制系统形成决策闭环——这是孪生体价值兑现的最后一公里。
学习目标
阅读完本节,你应当能够:
- 理解为什么多目标优化通常没有单一最优解,而是帕累托前沿
- 说清帕累托最优和帕累托前沿的含义,并能在二维目标空间里识别
- 区分加权求和、遗传算法、强化学习三类多目标优化方法
- 解释把优化结果接回控制系统的难点和安全考量
- 描述一个从数据到优化到反馈的完整决策闭环
一、问题与直觉
做过工艺优化的人都知道一个痛苦:你想同时优化好几个目标,但这些目标天然打架。拿一条生产线来说,你想产能最大化(多出产品),又想能耗最小化(少用电),还想设备寿命最大化(少磨损)。这三个目标互相矛盾——产能拉满通常意味着高负荷运转,能耗上去了、寿命下来了;保寿命就得降负荷,产能又下来了。
这种情况下,根本不存在一个让三个目标同时最优的“完美解”。你能做的是找一组“权衡解”——在这组解里,想提升任何一个目标,都必须牺牲另一个。这组解就叫帕累托前沿(Pareto Front)。比如(高产能、高能耗、短寿命)是一个解,(低产能、低能耗、长寿命)是另一个解,它们之间没有绝对的优劣,只有不同的取舍偏好。
多目标优化的任务,就是先找到这条帕累托前沿,然后由决策者(人或高层策略)根据自己的偏好,从前沿里选一个解。这个过程跟单目标优化(找一个最大值)思路完全不同,理解这个差别是这节的关键。
二、核心原理
2.1 帕累托最优:什么叫“没法更好”
帕累托最优的定义是:一个解如果不存在另一个解在所有目标上都不差、且至少一个目标严格更好,那它就是帕累托最优的。换句话说,帕累托最优解是“没法在不牺牲某个目标的前提下改进另一个目标”的解。
所有帕累托最优解组成的集合,就是帕累托前沿。它代表了所有合理的权衡选项——前沿之外的解是被支配的(有更好的替代),前沿上的解谁也不支配谁。
举个具体例子。假设优化两个目标:最大化产能 P,最小化能耗 E。算法跑完,找到三个帕累托最优解:解甲(P=100,E=50)、解乙(P=80,E=30)、解丙(P=60,E=20)。甲产能最高但能耗也最高,丙能耗最低但产能也最低,乙居中。这三个谁也不支配谁,它们构成帕累托前沿。最后选哪个,取决于决策者更看重产能还是能耗——如果最近电费紧张,选丙;如果要赶交期,选甲。
2.2 三类多目标优化方法
找到帕累托前沿有几种思路,工程上常用的有三类。
加权求和法:最简单。把多个目标按权重加成一个综合目标,然后用单目标优化方法解。好处是好实现,坏处是权重得人为定,且没法找到所有帕累托最优解(只能找到凸前沿上的)。适合目标数量少、对前沿形状了解的场景。
多目标进化算法:代表性的是 NSGA-II。它用遗传算法的思路,维护一个种群,通过选择、交叉、变异,逐代逼近帕累托前沿。好处是能找到前沿上的多个解、不依赖权重、能处理非凸前沿。坏处是计算量大、参数调优复杂。这是目前最主流的多目标优化方法。
强化学习法:用 RL 智能体在环境里试错,学习在不同偏好下的最优策略。好处是能处理动态环境、能在线学习。坏处是训练慢、样本效率低、可解释性差。适合环境动态变化、能大量仿真的场景。
| 方法 | 思路 | 优点 | 短板 | 适用场景 |
|---|---|---|---|---|
| 加权求和 | 多目标合成单目标 | 简单易实现 | 权重人为定、找不全前沿 | 目标少、前沿已知 |
| 进化算法(NSGA-II) | 种群逼近前沿 | 找多解、不需权重 | 计算量大、调参复杂 | 主流通用方法 |
| 强化学习 | 智能体试错学习 | 适应动态、可在线 | 训练慢、不可解释 | 动态环境、可大量仿真 |
2.3 决策闭环:从优化到控制
找到最优解只是上半场,下半场是把这个解变成控制指令下发下去,真正改变设备运行。这就是决策闭环。
这个闭环的难点在第 2 章提过——把优化结果接回控制,要碰 OT 安全的地盘。优化算法算出“应该把负荷调到 85%”,但能不能真调,还得过几道关:这个调法在安全范围内吗?调下去会不会触发联锁?网络传输有没有延迟导致调错时刻?自动调还是人来确认?
工程上常见的是半自动闭环:优化算法给出建议(“建议降载到 85%,预计节能 12%”),推送给操作员;操作员结合现场情况确认或修改后,系统才执行。这种人在回路(human-in-the-loop)的设计,在关键场景里比全自动更稳妥——它既用了优化的智能,又保留了人的判断兜底。
三、工程实践要点
3.1 优化频率与控制频率的匹配
优化引擎算一个解要几秒到几分钟,而设备控制环路的频率可能是毫秒级。这两个频率不匹配,直接把优化结果当下发指令会有问题——优化算完,工况早就变了。
解法是分层:底层用快的反馈控制(PID 之类)维持设备稳定,上层用慢的优化引擎周期性调整控制器的设定值。底层管“稳”,上层管“优”,两层各跑各的频率,优化结果通过修改设定值传导下去。
3.2 模型预测的准确度决定优化价值
多目标优化依赖模型预测不同操作下的效果(比如“负荷调到 85% 会怎样”)。模型预测不准,优化结果就是垃圾进垃圾出。所以优化系统能不能用,前提是底下的诊断和预测模型够准。这就是为什么优化放在第 3 章最后讲——它建立在前面诊断和预测的基础上。
⚠️ 常见坑:跳过诊断和预测,直接上优化。模型不准,优化出来的“最优解”实际是最差解,真下发下去可能出事故。优化必须是诊断和预测都可信之后才做,不能倒过来。
3.3 留安全余量
即使模型很准,优化给出的最优解往往在边界附近(比如满负荷运行产能最高)。直接贴着边界跑,一旦模型有偏差或工况扰动,就可能越界出事。工程做法是给优化约束留安全余量——把实际允许的边界往内收一点,让最优解离真实边界有点距离,用这部分损失换安全。
💡 关键直觉:多目标优化的输出不是“唯一正确答案”,而是“一组可选权衡”。别指望算法替你做决定,它的价值是帮你把所有合理选项摆出来,最终选哪个还是要人根据当下业务偏好定。理解这一点,你才不会对优化结果抱不切实际的期望。
本节要点回顾
- 帕累托最优:多目标冲突时没有单一最优解,只有一组互不支配的权衡解(帕累托前沿)。
- 三类方法:加权求和(简单但找不全前沿)、进化算法(主流通用)、强化学习(适合动态环境)。
- 决策闭环:优化结果经操作员确认后下发控制,人在回路在关键场景里比全自动稳妥。
- 频率分层:底层快控制管稳,上层慢优化管设定值,两层各跑各的频率。
- 模型前提:优化建立在诊断和预测基础上,模型不准优化就是垃圾进垃圾出。
- 安全余量:给约束留余量,牺牲一点最优性换安全,别贴着边界跑。
下一章我们离开方法论,走进真实场景,看这些智能能力在制造、城市、能源领域是怎么用的。
四、帕累托前沿的工程读法
图:多目标优化中的帕累托前沿
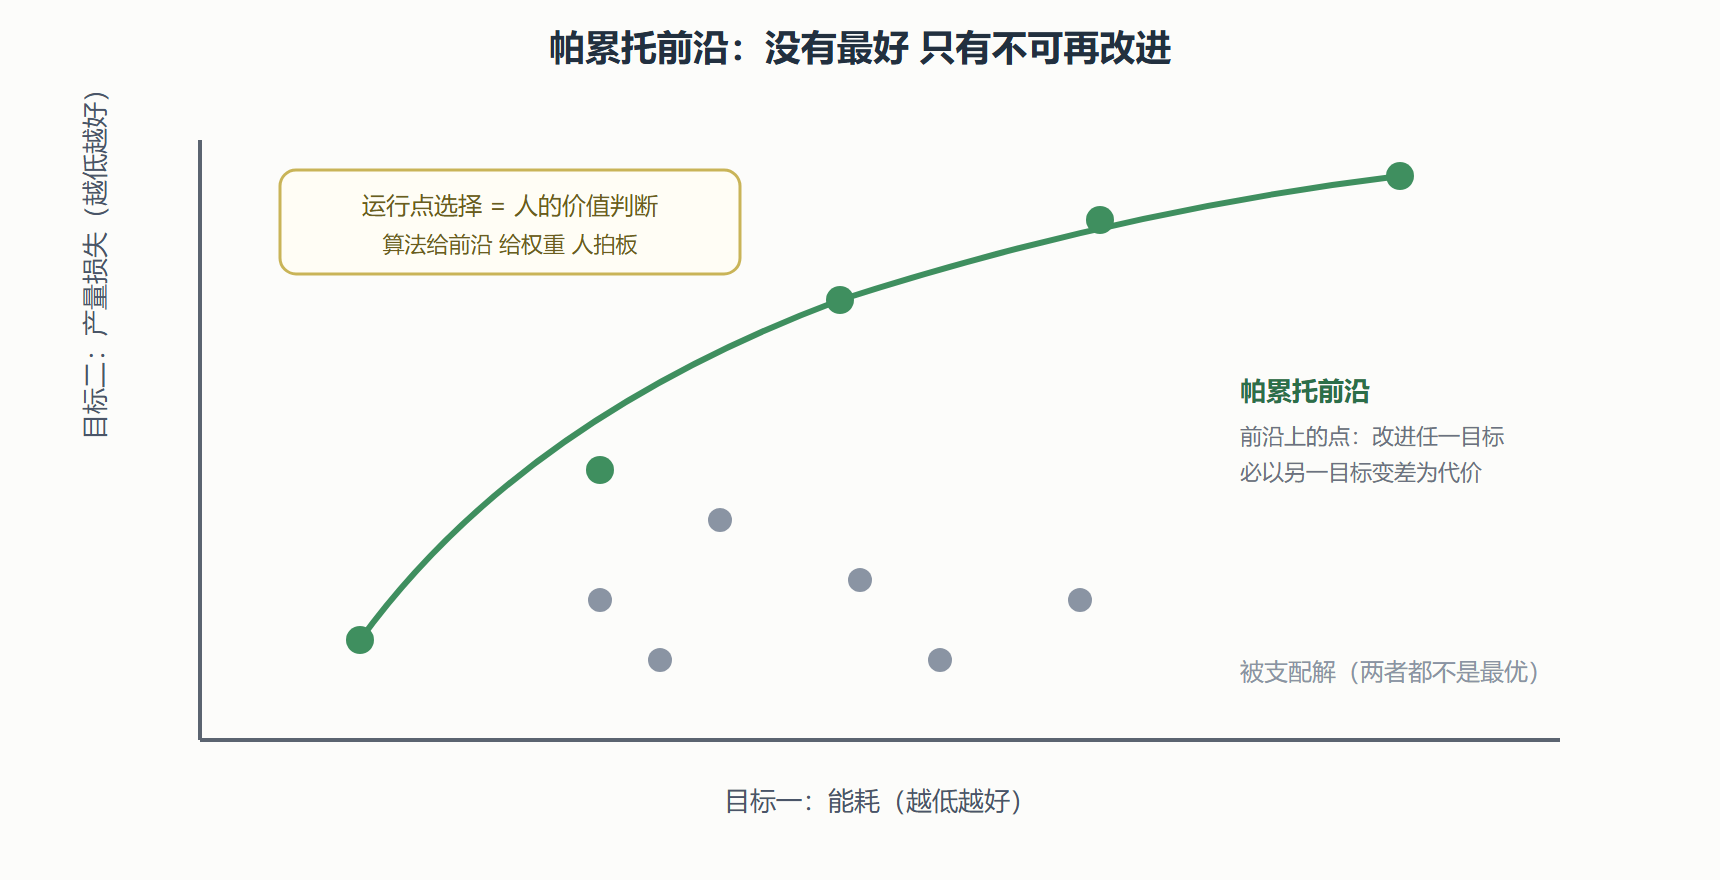
工程上对帕累托前沿有三个常被问到的误区。误区一,追求"唯一最优解"——多目标问题的本质就是没有同时最优,任何声称给出唯一解的算法都偷偷做了加权,把价值判断藏进了黑箱,正确的姿态是让算法暴露前沿、让人选点。误区二,前沿越密越好——给决策者的前沿点超过一打就成了负担,实践中按曲率自适应采样出五到八个代表点最实用。误区三,忽略前沿的时效性——设备状态漂移后旧前沿失效,孪生的价值就在于近乎实时地重算前沿,这是"离线优化"与"孪生优化"的分水岭。
五、决策闭环的分级自动化
优化出的决策建议如何回流执行,工程上按自动化程度分四级。一级人工确认:所有建议进工单池,由调度员审核执行,适合上线初期积累信任。二级白名单自动:低风险、可逆的决策(阀门微调、参数寻优)自动执行,高风险决策仍走人工,关键是为"低风险"划出清晰边界。三级有约束自动:大部分决策自动执行,但受安全边界硬约束,越界即回退,孪生的价值在这一级才充分兑现。四级自主寻优:系统在边界内持续探索更优运行点,涉及探索与利用的平衡,需要额外的安全论证。跃级是事故的主要来源——跳过一二级直接上三级,等于用生产环境做测试。分级推进的节奏没有统一答案,但每级停留的退出条件必须事前定义:通常是一段时间内自动决策的接受率和事后复盘的差错率双达标。
补一个新手常问的小问题:目标之间冲突了怎么办——冲突是常态不是异常,帕累托方法的价值恰恰是把冲突显性化;真正要警惕的是目标看似独立实则线性相关(两个指标其实是同一个东西的两种写法),那会让前沿退化成一个点,优化问题名存实亡。动手前检查目标矩阵的相关性,五分钟省掉两周无用功。