3.3PQC安全性评估与标准化
3.3 PQC 安全性评估与标准化
PQC 要真正可用,必须先经过"攻防博弈"的检验,再由权威机构定标。NIST 的 PQC 标准化项目是目前全球事实上的风向标。
安全性评估怎么做
| 评估维度 | 关注点 |
|---|---|
| 数学分析 | 算法依赖的数学难题是否真的难 |
| 密码分析 | 是否存在亚指数甚至多项式攻击 |
| 实现分析 | 常量时间、抗侧信道实现 |
| 形式化验证 | 用工具证明协议属性 |
标准化的意义
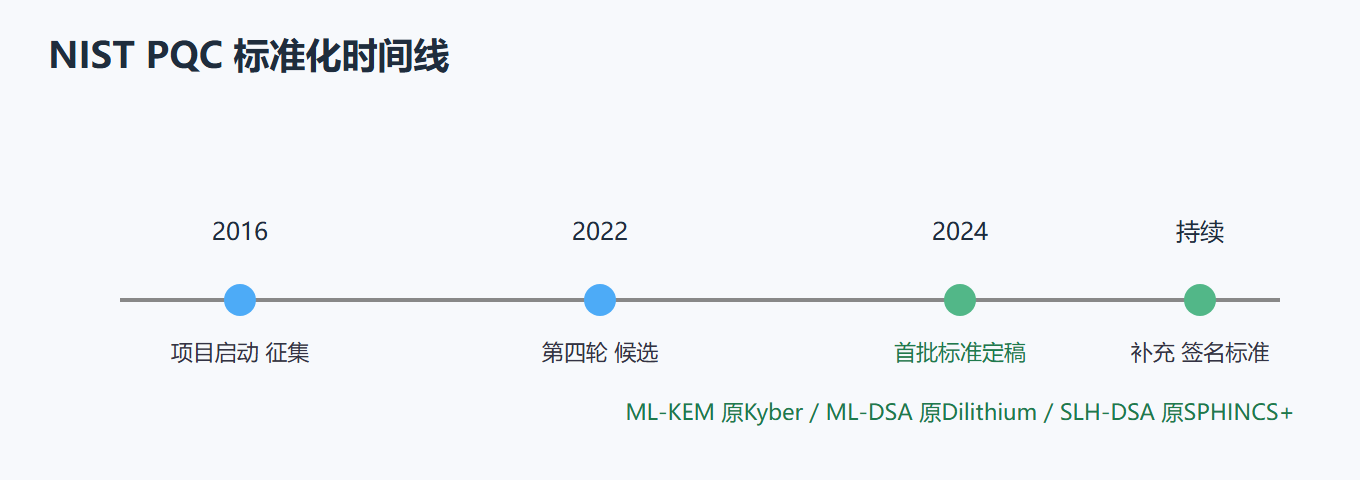
NIST 在 2024 年定稿的首批标准把原候选改名发布:ML-KEM(原 Kyber,封装)、ML-DSA(原 Dilithium,签名)、SLH-DSA(原 SPHINCS+,无状态哈希签名),后续还补充了 Falcon 等签名方案。统一标准意味着不同厂商的系统可以互联互通,也便于监管合规。
💡 评估是持续过程:一个算法今天安全,明天可能被新攻击削翻(SIKE 就是例子),所以 PQC 选型要保持"可替换"的架构,别把某一种算法焊死。
⚠️ 注意算法改名:对外采购或写代码时要用 ML-KEM/ML-DSA/SLH-DSA 等新名称,旧的 Kyber/Dilithium 称呼虽仍通用,但标准化文档里以新名为准。
深入讨论:标准名单变化带来的工程教训
NIST PQC 项目的淘汰历史本身就是最好的教材。第一轮收到 69 份候选,到 2022 年首批标准公布,绝大多数方案在公开分析中倒下或合并。多变量签名的 Rainbow 进入第三轮决赛却被代数结构攻击快速破解;同源方案 SIKE 以最小公钥著称,却在 2022 年被经典算法在普通 PC 上攻破——这两个案例说明,方案的「尺寸优势」随时可能被一份新论文抹平,标准化名单是动态的,不能把生产安全押在未经定稿的方案上。
对工程人员而言,标准化的真正价值是「提供可引用的安全基准」:FIPS 203(ML-KEM)、FIPS 204(ML-DSA)、FIPS 205(SLH-DSA)定义了参数集、安全级别与测试向量,采购与合规都能以此为准。同时也要保持「可替换」的架构意识:把算法选择做成配置项,跟踪第四轮候选与后续补充签名标准,一旦在役算法出现风险,可以平滑切换到备选,而不是被单一算法绑定。
# NIST 标准化关键节点速查 2016 征集启动,69 份候选 2019 第二轮筛选(26 个方案) 2020 第三轮决赛(7 个)+ 备选(8 个) 2022 公布首批标准算法(Kyber/Dilithium/SPHINCS+ 原名) 2024 定稿发布:ML-KEM、ML-DSA、SLH-DSA(改名) 2025+ 补充签名标准(Falcon/FN-DSA)与第四轮 KEM 观察 # 架构上保持可替换的落地要点 1. 算法名与参数集做成配置项,不硬编码 2. 记录依赖库版本与 FIPS 编号,便于审计 3. 订阅安全公告,识别在役算法的风险信号 4. 试点阶段预留备用算法通道,演练切换流程
把「标准是动态的」内化为设计原则,比记住某一版名单重要得多。今天选了 ML-KEM,明天如果出现削弱它的攻击,依赖「配置可切换 + 版本可审计 + 切换可演练」这三条,才能把冲击控制在可管理范围——这也是标准章节真正要传达的工程素养。
对合规与采购人员,这里还有一层实用含义:标准化名称与俗称的对应关系(ML-KEM 即 Kyber、ML-DSA 即 Dilithium、SLH-DSA 即 SPHINCS+)必须在文档与清单中统一登记。招标书、验收报告与供应链物料清单若沿用旧名,可能造成「采购了抗量子产品、审计却不认账」的混乱。把名称、参数集与 FIPS 编号三要素写进每一份相关文档,是成本最低也最容易踩漏的合规动作。
安全性评估的另一个落点是「第三方与供应链」:PQC 实现库版本、算法标识与安全公告需要像软件物料清单一样被追踪。建议把「算法版本 + KAT 向量比对 + 安全公告订阅」纳入依赖管理流程,与常规依赖审计同等对待,确保在役实现的正确性可复现、风险可追溯。
其中 KAT 向量比对是最容易自动化的一环:把官方测试向量作为 CI 回归用例,任何实现库升级或参数改动都会立刻暴露正确性偏差,避免「升级后无声地失去互操作能力」这类隐蔽故障。这个实践不限于 PQC,也适用于整个密码栈的依赖治理。
总而言之,标准化的动态名单、安全性评估的持续性和供应链的可追踪性,共同构成了 PQC「可信」的三根支柱——缺一根,技术再先进也难以在审计与长期运营中站得住脚。