2.2 MANO编排工作流
2.2 MANO 编排工作流
本节摘要:MANO 不只是个管理工具,它是一套把网络服务从"描述符模板"变成"运行中实例"的自动化引擎。本节讲清一个网络服务(NS)从 onboard、实例化、运行到终止的完整编排流程,以及监控-分析-决策-执行的闭环自动化怎么让 NFV 实现自愈和自适性扩缩容。
学习目标
阅读完本节,你应当能够:
- 画出 NS 从 onboard 到终止的完整生命周期
- 说清 NFVO、VNFM、VIM 在实例化流程里的协作
- 解释闭环自动化的四个环节
- 说明扩缩容和自愈的触发逻辑
- 指出编排工作流里的几个关键决策点
一、问题与直觉
传统网络运维里,部署一个新服务是高度人工的过程:工程师写配置脚本、登录各台设备、按顺序执行、出错了手动排查。一个复杂服务(比如包含防火墙、负载均衡、多个路由器的企业 VPN)可能要几天才能上线,中间任何一个环节出错都得回滚重来。
MANO 的编排工作流就是为了消灭这种人工。它把"怎么部署一个网络服务"编码成描述符(NSD/VNFD),然后由 MANO 自动执行:读模板、分配资源、启动 VNF、配置互联、验证可用。整个过程分钟级完成,出错可自动回滚。这就是"网络即代码"的威力——部署不再是手艺活,而是可重复、可版本化、可自动化的工程。
更进一步,MANO 还能在服务运行期间持续监控,发现负载高了自动扩容、发现故障了自动愈合。这种"闭环自动化"让网络具备了自适应能力,运维人员从"救火队员"变成"策略制定者"。
二、核心原理
2.1 NS 的完整生命周期
一个网络服务(NS,Network Service)在 MANO 管理下,经历这几个阶段:
Onboard(上架):把 NSD 和相关的 VNFD 上传到 NFVO。这一步是"注册模板",告诉 MANO"有这么一种网络服务,长这样"。Onboard 后模板存在目录里,可以反复用来创建实例。
实例化(Instantiation):NFVO 收到实例化请求后,按 NSD 的描述执行部署。这是最核心的流程,下面单独拆开讲。
运行与监控:NS 跑起来后,MANO 持续监控它的健康状态和性能指标(吞吐量、延迟、资源使用率)。监控数据是后续扩缩容和愈合决策的依据。
扩缩容(Scale):负载变化时,增加或减少 VNF 实例数。比如流量涨了,把 vFirewall 从 2 个实例扩到 4 个。
愈合(Heal):检测到某个 VNF 故障(崩溃、无响应)时,自动重启或替换它,恢复服务。
终止(Terminate):业务结束时,按顺序关闭所有 VNF,释放资源。
2.2 实例化的协作流程
实例化是最能体现三组件协作的环节。一个 NS 实例化的完整流程:
这个流程的关键点:
- NFVO 是总指挥:它读 NSD,决定要起哪些 VNF、按什么顺序、怎么互联。
- VNFM 是中层执行:它接收 NFVO 的指令,具体管理每个 VNF 的创建和配置。
- VIM 是底层操作:它实际分配 CPU、内存、网络资源,启动虚拟机或容器。
- 服务链配置在最后:所有 VNF 起来后,NFVO 配置它们之间的流量路径,形成端到端服务。
整个流程全自动,从请求到完成通常几分钟。如果中间某步失败,NFVO 可以自动回滚(销毁已创建的部分),保证不留半成品。
2.3 闭环自动化
实例化是"一次性"的部署,闭环自动化是"持续"的运维。它的核心是四个环节的循环:
监控(Monitor):持续采集 VNF 和 NS 的运行指标——CPU 使用率、内存占用、网络吞吐、延迟、错误率。数据来源是 VIM 的资源监控和 VNF 自身的功能监控。
分析(Analyze):判断当前状态是否偏离预期。比如某 vFirewall 的 CPU 持续 90% 以上(过载)、某 vLB 的延迟超过阈值(性能劣化)、某 VNF 心跳停止(故障)。
决策(Decide):根据分析结果和预设策略,决定采取什么行动。策略是预先定义的——比如"CPU 超过 80% 持续 5 分钟就扩容"、"VNF 无响应就重启"。
执行(Execute):NFVO/VNFM 执行决策——扩容(加实例)、缩容(减实例)、愈合(重启或替换)、告警(通知运维)。
| 闭环场景 | 触发条件 | 自动响应 |
|---|---|---|
| 过载扩容 | CPU 持续高 | 增加 VNF 实例 |
| 空闲缩容 | CPU 持续低 | 减少 VNF 实例省资源 |
| 故障愈合 | VNF 无响应 | 重启或替换 |
| 性能劣化 | 延迟超阈值 | 迁移或扩容 |
闭环自动化让网络具备了"自适应"能力。传统网络要运维人员盯着监控、人工判断、手动操作;NFV 的闭环自动化把这套流程自动化了,运维只需预设策略,系统自己应对常见波动。
💡 关键直觉:闭环自动化的价值不是"消灭运维",而是"把运维从重复劳动升级到策略设计"。运维人员不再处理"CPU 高了赶紧加机器"这种事,而是思考"什么策略下该自动扩容、什么情况下该告警人工介入"。这是运维角色的升级。
2.4 愈合(Heal)的细节
愈合是闭环里最考验工程能力的环节。一个 VNF 故障了,MANO 怎么自动恢复?
检测故障的方式:
- 心跳检测:VIM 定期 ping VNF,无响应判定故障。
- 健康检查:VNFM 调用 VNF 的健康检查接口,返回异常判定故障。
- 性能异常:VNF 还活着但性能指标异常(比如丢包率飙升),可能是软件 bug。
恢复策略(按故障严重程度递进):
| 故障类型 | 恢复策略 | 耗时 |
|---|---|---|
| 进程崩溃 | 重启进程 | 秒级 |
| 虚拟机卡死 | 重建虚拟机 | 分钟级 |
| 数据损坏 | 从备份恢复 | 分钟到小时级 |
| 硬件故障 | 迁移到其他节点 | 分钟级 |
愈合的难点在于"有状态恢复"。如果 VNF 崩溃前正在处理一批流量,简单重启可能丢失状态,导致连接中断。成熟的做法是 VNF 定期把状态检查点(checkpoint)保存到外部存储,重启后从检查点恢复,减少丢失。
三、工程实践要点
3.1 编排策略的设计
闭环自动化的效果,取决于预设策略的质量。设计策略时几个要点:
- 阈值要合理:扩容阈值定太高(如 95%),系统经常过载才响应;定太低(如 50%),频繁扩容浪费资源。要基于实际负载特征调。
- 要有冷却时间:扩容后给系统几分钟稳定期,避免抖动(刚扩容又缩容)。
- 区分自动和人工:常规波动自动处理,异常情况(如持续故障、容量耗尽)要告警人工介入。
3.2 描述符版本管理
NSD/VNFD 是"网络服务的代码",必须做版本管理:
- 每次修改描述符都要有版本号和变更记录。
- 部署时记录用了哪个版本的描述符,便于回溯。
- 升级时灰度部署(先小范围上新版本,验证没问题再全量)。
把描述符当代码管(Infrastructure as Code),是 NFV 运维成熟度的标志。
⚠️ 常见坑:很多团队初期不重视描述符版本管理,手动改、口头传,等出问题时根本不知道线上跑的是哪个版本、改过什么。NFV 部署规模一上去,没有版本管理就是灾难。从第一天起就要把描述符纳入 Git 管理。
3.3 闭环的局限
闭环自动化能处理常规波动,但有局限:
- 无法处理未知故障模式:策略是预设的,遇到没见过的故障(新型攻击、罕见 bug),系统不知道该怎么响应。
- 过度自动化有风险:如果策略设计不当,自动化可能放大问题(比如错误判断导致疯狂扩容,耗尽资源)。
- 复杂场景仍需人工:跨域故障、根因分析、重大变更,人工介入更稳妥。
理性的做法是:常规波动自动化,异常情况人工介入,两者结合。不要追求"全自动无人值守"——那在复杂网络环境里不现实。
编排章要点
- NS 生命周期六阶段:Onboard、实例化、运行监控、扩缩容、愈合、终止。
- 实例化是三组件协作的核心:NFVO 规划指挥,VNFM 管理每个 VNF,VIM 分配底层资源,最后配置服务链。
- 闭环自动化四环节:监控、分析、决策、执行,让网络自适应常规波动。
- 扩缩容和愈合是闭环的两大应用:前者应对负载变化,后者应对故障。
- 愈合的难点是有状态恢复:状态检查点机制能减少重启时的状态丢失。
- 编排策略要合理设计:阈值合理、有冷却时间、区分自动和人工。
- 描述符必须做版本管理:把它当代码管,是 NFV 运维成熟度的标志。
- 闭环有局限:常规波动自动化,异常情况人工介入,不要盲目追求全自动。
下一章钻进 NFVI——底层基础设施怎么搭建,虚拟化层怎么做资源抽象,硬件加速怎么解决性能瓶颈。
四、一次业务开通的编排分解
图:NS 实例化时序分解
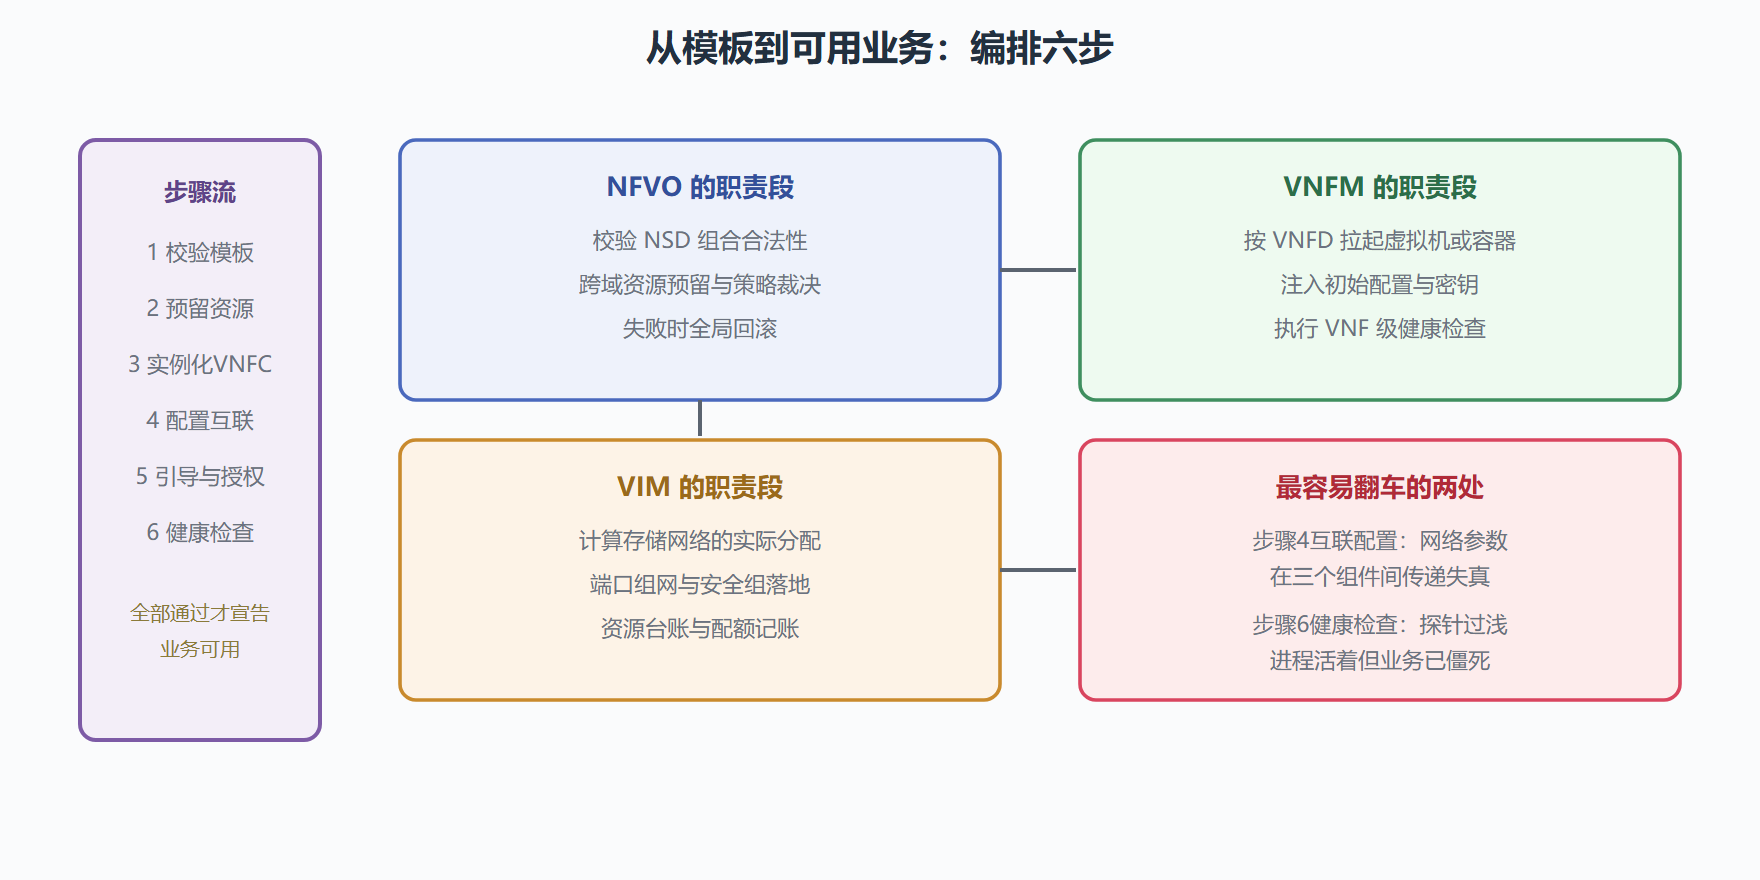
这张时序分解图给了 MANO 三组件一个可复述的协作故事:NFVO 把关全局与回滚,VNFM 管单个 VNF 的出生与体检,VIM 干最重的资源落地活。理解职责边界在故障定位时价值千金——业务开通失败,先按这六步定位卡在哪一步、归哪个组件,而不是三个团队互相拉扯。两处高发故障(互联参数失真、健康检查过浅)值得记住:前者是接口契约问题,后者是探针设计问题,第 5 章会再展开。
五、失败的回滚艺术
编排六步图讲的是成功路径,生产环境里同样重要的是失败路径——回滚的艺术。规则一,越早失败越便宜:校验阶段(步骤一)发现模板错误成本近乎零,资源预留阶段(步骤二)失败只涉及记账回退,实例化后(步骤三以后)失败则要逐台清理半成品;编排器应该把尽可能多的检查前移到校验阶段。规则二,回滚要有明确的所有者:跨组件的失败回滚由 NFVO 主导,它持有全局视图;让 VNFM 或 VIM 自行回滚会导致资源状态不一致的经典事故。规则三,回滚本身要有超时与人工兜底:回滚路径同样可能失败(清理脚本卡死),必须配超时告警与人工介入点,否则"自动回滚变自动挂起"。规则四,半成品状态要可查询:编排失败后的现场(哪些实例已拉起、哪些网络已配置)必须能一键导出,供人工决策"继续清理还是修复推进"。这四条规则合起来是一个工程认知:编排器的可靠性不在成功路径的速度,而在失败路径的完备——演示环境看前者,生产环境活下来靠后者。
补充一个编排六步的时间分布常识:成熟环境里一次标准业务开通的端到端时间,六成耗在实例化与配置段(虚拟机或容器的拉起与初始化)、三成在健康检查与验证段、一成在编排决策本身——知道时间花在哪,才知道优化什么(镜像预热与配置并行化是前两名的提速手段)。