6.1 HPC软硬件选型决策与成本权衡
6.1 HPC软硬件选型决策与成本权衡
本节摘要:HPC 的选型没有"最优解",只有"最匹配解"。本节把实战中最高频的三类决策拆成可判断的框架:硬件选型(该用 CPU 还是 GPU、互连带宽怎么估、内存层次怎么配)、软件选型(MPI、OpenMP、CUDA、AI 框架选哪一层)、部署选型(自建集群还是上云 HPC)。每个决策都给出判断依据和成本考量,强调"匹配任务特征"而非"追求最强配置"。读完你能建立一套从任务需求反推软硬件配置的实战思路。
核心问题
阅读完本节,你应当能够:
- 根据任务特征判断该用 CPU 还是 GPU、什么样的互连
- 在 MPI、OpenMP、CUDA、AI 框架间做出合理的软件选型
- 评估自建集群与上云 HPC 的成本权衡
- 避免选型中最常见的几类误区
一、问题与直觉
很多人接到一个 HPC 任务,第一反应是"买最强配置"。但"最强"是个没有参照系的说法——对分子动力学最强的配置,对大模型训练未必合适;对延迟敏感的实时仿真,吞吐再高的 GPU 也可能不适用。选型的本质不是堆参数,而是让硬件、软件、部署三者的特性匹配你任务的特征。
更现实的问题是,选型往往不是纯技术决策,而是技术加预算加团队能力的综合权衡。一台理论性能最高的超算,如果团队没能力驾驭它的异构编程,实际跑出来的效率可能还不如一台便宜但团队熟悉的集群。选型的成熟,体现在愿意为"匹配"而不是"先进"买单。
这节把三类高频决策拆开讲。每类都先给判断维度,再给对比表,最后给实战心法。目标不是给你一个标准答案(因为不存在),而是给你一套能复用的判断框架。
二、核心原理
2.1 硬件选型:先看任务,再看硬件
硬件选型的第一步不是看参数,是看任务。三个关键问题:任务的计算强度高不高(每个数据被算几次)、数据访问规不规则(是连续还是随机)、并行度大不大(能展开成多少独立单元)。这三个特征决定了硬件适不适合。
| 任务特征 | 推荐硬件 | 理由 |
|---|---|---|
| 高计算强度、规则访问、海量并行 | GPU | 海量线程高吞吐、高带宽显存 |
| 低计算强度、不规则访问 | 高频 CPU 多核 | 单核强、缓存深、分支预测好 |
| 强依赖、串行段多 | 高主频 CPU | 串行部分靠单核主频 |
| 大规模、需扩展 | 分布式集群加高速互连 | 加节点加算力 |
互连是硬件选型里最容易被忽视、却又最关键的维度。一台峰值算力很高的集群,如果互连带宽低、延迟高,跑通信密集的应用(如分子动力学的邻居通信、大模型的梯度同步)时效率会大打折扣。InfiniBand、NVLink 这类高速互连的存在,就是为了缩短数据搬运的时间。
💡 关键直觉:评估硬件别只看算力峰值,要看"你的任务能不能用满它"。一台 GPU 的峰值算力再高,如果你的任务计算强度不够、数据搬运占大头,实际效率可能只有峰值的几个百分点。先估算任务的计算强度,再对照硬件的"屋顶线"(算力除以带宽),就能预判它会卡在计算还是带宽上。
2.2 软件选型:匹配硬件层次
软件选型的核心原则第 2 章和第 5 章都讲过——匹配硬件层次。这里把它落成可操作的决策表。
| 场景 | 推荐起点 | 何时下沉一层 |
|---|---|---|
| 训练神经网络 | AI 框架(PyTorch 等) | 需要自定义算子或极致通信优化时 |
| 单节点多核加速遗留代码 | OpenMP 制导指令 | 性能不够、需要精细控制线程时 |
| 跨节点大规模仿真 | MPI | 总是分布式内存时 |
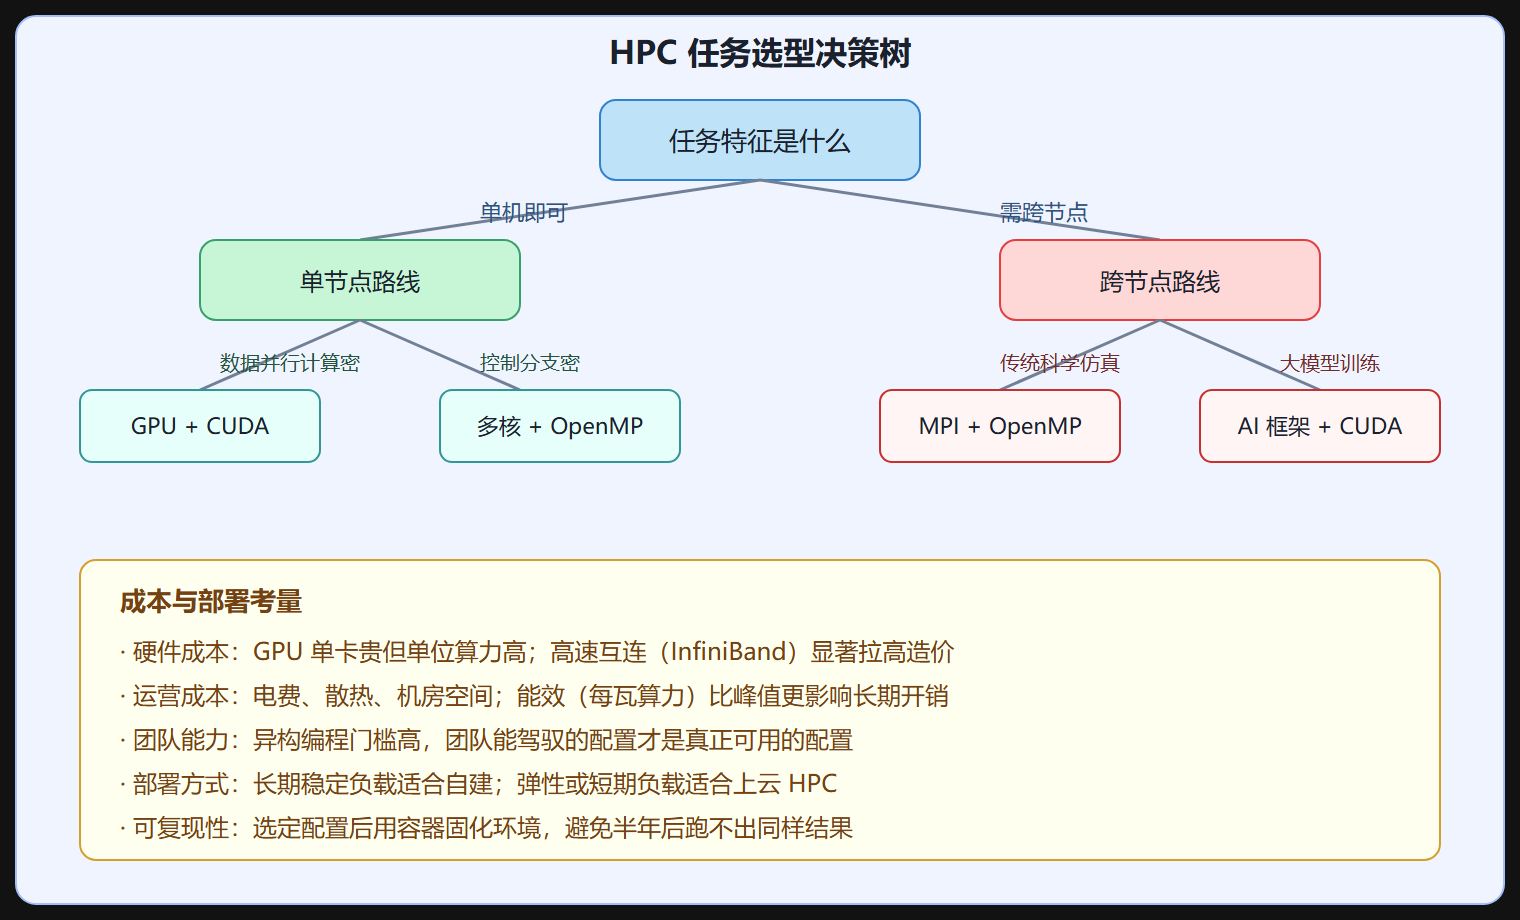
| GPU 数据并行 | CUDA 或数学库 | 抽象层挡住控制粒度时 |
| 极致性能内核 | CUDA 核函数加汇编 | 榨干最后一点性能时 |
软件选型有一个反直觉的原则:从最高抽象层开始,不够再下沉。能用 PyTorch 的分布式数据并行就别手写 MPI,能用 cuBLAS 就别手写 CUDA 核函数。抽象层的作用是把常见情况封装好,让你把精力放在业务逻辑而非底层细节上。只有在抽象层确实挡住了你需要的控制粒度时,才往下沉。
图 选型决策树:从任务到工具
2.3 部署选型:自建还是上云
过去 HPC 几乎等同于自建集群——买服务器、装空调、拉网络、聘运维团队。但云上 HPC(AWS ParallelCluster、Azure CycleCloud、阿里云 E-HPC 等)的成熟,让"租用"成为可行的替代方案。两者的权衡不是哪个便宜,而是哪个匹配你的使用模式。
| 维度 | 自建集群 | 云 HPC |
|---|---|---|
| 初始投入 | 高(硬件加机房) | 低(按需付费) |
| 长期成本 | 摊薄后低 | 高频使用时贵 |
| 弹性 | 差(固定规模) | 好(按需扩缩) |
| 可控性 | 高(完全自主) | 中(受云厂商约束) |
| 运维负担 | 重 | 轻(云厂商托管) |
| 适合场景 | 长期稳定负载 | 弹性、短期、试验性负载 |
⚠️ 常见坑:简单按"机器贵不贵"比自建和上云。真实的成本要算总拥有成本(TCO):自建算上硬件折旧、电费、散热、机房、运维人力;上云算上实例费、存储费、数据传输费。一个每年满载运行的集群,自建通常更划算;一个每周只用几小时的试验性任务,上云便宜得多。判断的关键是你的负载是"稳定满载"还是"间歇弹性"。
三、工程实践要点
3.1 用小规模测试反推大规模需求
💡 关键直觉:选型前先用小规模(单节点、几个节点)跑测试,把单节点的算力、内存、IO、通信需求测出来,再按目标规模放大,留出安全余量。这是选型最可靠的依据——比任何理论估算都准。一个常见的放大经验:通信密集的任务,从 N 个节点放大到 2N 个节点时,通信开销可能不止翻倍(因为通信对的组合数增长),这点要在估算时留余量。
3.2 别为未来过度配置
| 误区 | 表现 | 后果 |
|---|---|---|
| 过度配置算力 | 买远超当前需求的 GPU | 资金占用、闲置浪费 |
| 过度配置存储 | 买超大并行文件系统 | 成本高、维护重 |
| 过度配置互连 | 全机部署高端 InfiniBand | 通信不密集的任务用不上 |
选型常见的一个错误是"为未来留余量"过度。买比当前需求大一倍的配置,理由是"以后可能要用",结果两年后真正的新需求来了,当时的硬件已经过时,余量根本没用上。务实的做法是按当前明确需求配置,留百分之二十到三十的余量即可,未来真有需求再扩。
3.3 软件栈的一致性比单点最优更重要
⚠️ 常见坑:为了让某个热点算子跑最快,引入一个特殊版本的库或编译器,破坏了整个软件栈的一致性。短期看那个算子快了,长期看环境变得难以复现、难以维护、新人难以接手。HPC 的软件栈一致性(统一的编译器版本、统一的 MPI 实现、统一的数学库)比某个单点的极致性能更有价值——它保证了可复现性和团队的可维护性。
3.4 能效与散热:长期运营的隐形账单
选型时容易只盯着采购价,忽略运营期的电费和散热。一台峰值算力很高的超算,功耗动辄几十兆瓦,一年的电费可能赶上硬件折旧。更麻烦的是散热——高密度机柜如果散热跟不上,要么降频保命(性能打折),要么加速老化(寿命缩短)。
评估能效有两个常用指标:每瓦浮点运算数(Green500 用的就是这个)和每美元算力(性价比)。选型时把这两个指标和峰值算力一起看,才不会被"纸面数据"误导。对长时间运行的集群,能效高的方案(比如 ARM 加 GPU、液冷散热)哪怕采购价略高,长期算总账往往更划算。
| 维度 | 峰值导向 | 能效导向 |
|---|---|---|
| 采购价 | 高(堆顶级硬件) | 中(选能效好的组合) |
| 运营成本 | 高(电费散热) | 低(每瓦算力高) |
| 散热方式 | 风冷(易降频) | 液冷(稳定高密度) |
| 适合场景 | 短期峰值冲刺 | 长期稳定运行 |
| 长期 TCO | 偏高 | 更低 |
💡 关键直觉:超过三年的长期负载,能效比峰值更重要。这也是为什么 Green500 榜单越来越受关注——单纯堆算力的时代过去了,能效和可持续性成了新一代超算的核心指标。选型时如果团队有长期运行的需求,务必把电费和散热纳入总拥有成本的计算。
3.5 团队能力是最大的隐藏约束
选型的最后一个、也是最容易被忽视的维度:团队能力。一台技术最先进的异构超算,如果团队没人能驾驭它的编程模型,实际跑出来的效率可能还不如一台便宜但团队熟悉的集群。选型的成熟,是愿意为"团队能驾驭"而不是"技术最先进"买单。
这并不意味着永远停留在旧技术——而是要根据团队能力做渐进式升级。引入新硬件前,先评估团队的学习曲线、培训成本、招聘难度。一个务实的路径是:先用团队熟悉的技术栈把项目跑起来,同时安排人学新技术,等团队能力到位了再迁移。盲目上新技术、却没匹配的团队能力,是 HPC 项目失败的常见原因。
3.6 用基准测试看清真实性能
选型时只看厂商给的峰值参数是不够的——峰值是理想条件下的理论值,真实任务的持续性能可能只有峰值的几个百分点。要看清一套硬件的真实表现,得用基准测试(benchmark)跑和你的任务类似的负载。
HPC 领域有成熟的基准测试套件:HPL 测稠密线性代数的峰值算力、HPCG 测通信密集的实际性能、STREAM 测内存带宽、IOR 测并行 IO 吞吐。这些基准各有侧重,单看一个容易被误导——比如一台 HPL 分数很高的机器,HPCG 分数可能很低,说明它在通信密集的实际应用上表现差。
| 基准 | 测什么 | 局限 |
|---|---|---|
| HPL | 稠密线性代数峰值算力 | 偏理想,实际应用很少这么规整 |
| HPCG | 通信密集的实际性能 | 更贴近真实,但只覆盖一类负载 |
| STREAM | 内存持续带宽 | 不反映随机访问性能 |
| IOR | 并行 IO 吞吐 | 不反映元数据操作性能 |
💡 关键直觉:选型时同时看 HPL 和 HPCG 两个分数,能避免被"纸面算力"误导。HPL 高 HPCG 也高的机器,才是通信和计算都均衡的好机器;HPL 高 HPCG 低的机器,跑通信密集的实际任务会很吃亏。最好再用你自己的小规模任务做一次真实测试,这是最可靠的选型依据。
3.7 生命周期成本:别只看采购价
选型决策最后要算的是生命周期成本。一台超算从采购到退役,要经历部署、运行、维护、升级、退役几个阶段,每个阶段都有成本。只盯着采购价,会严重低估真实开销。
一个简单的经验:一台超算生命周期内的电费和运维人力加起来,往往和采购价相当甚至更高。这意味着选型时省下的采购价,可能在运营期加倍还回去。务实的做法是把总拥有成本(采购加电费加散热加运维加退役处理)作为决策依据,而不是只比采购价。
要点速记
- 硬件选型先看任务:计算强度、访问模式、并行度、通信密度决定 CPU 还是 GPU、什么互连。
- 软件选型匹配硬件层次:从最高抽象层开始,不够再下沉一层。
- 自建 vs 上云看使用模式:稳定满载自建,弹性间歇上云,比 TCO 不比单价。
- 小规模测试反推大规模需求,比理论估算可靠;别为未来过度配置。
- 软件栈一致性比单点最优更重要,可复现和可维护是长期价值。
下一节是排错 FAQ,汇总现场最常踩的坑和应对方向。