2.4 实战:用 Groovy 写一个数据处理脚本
2.4 实战:用 Groovy 写一个数据处理脚本
本节摘要:把 2.1-2.3 的能力整合到一个真实的数据处理任务里——读取销售记录、清洗脏数据、按品类聚合、输出报表。本节不仅展示代码怎么写,更展示"动态特性该用在哪个环节、哪里要收敛",让你第一次完整体会 Groovy 在真实任务里的手感。
上手前先明确
阅读完本节,你应当能够:
- 综合运用集合字面量、GString、闭包、GDK 方法完成一个完整的数据处理任务。
- 判断数据清洗、转换、聚合三个阶段各自适合用哪种写法。
- 用表格和文件输出生成可读的报表结果。
- 识别这个脚本里"动态特性用对了"和"该收敛却没收敛"的取舍点。
- 为脚本增加参数化与复用能力,把它从一次性脚本升级为可维护工具。
一、任务与直觉:一个"再常见不过"的需求
假设你是电商团队的工程师,运营丢给你一个 CSV 文件,里面是一周的所有订单:订单号、商品品类、单价、数量、地区。需求是:按品类汇总销售额和订单数,再按地区算客单价,最后输出一份人能看的报表。如果这是 Java,你得先定义 Order POJO、写解析器、写三个循环、拼字符串输出——半天过去了。运营想要的是"今天下午能用"。
Groovy 做这类事天然合适:脚本直接跑,不需要项目骨架;闭包让分组聚合一行搞定;GString 让报表生成像写散文。但注意,这恰恰是"动态特性最该发挥作用"的场景——任务是一次性的、逻辑变化快、正确性靠运行验证。我们在这个实战里刻意做全套,就是为了把这种感觉固化下来。
二、动手实现:四个步骤逐步推进
第一步:准备数据与结构
先用集合字面量定义一个简化版的数据样本,避免依赖真实文件就能跑通逻辑:
def orders = [ [id: 'A001', cat: '手机', price: 4999, qty: 2, region: '华东'], [id: 'A002', cat: '配件', price: 129, qty: 5, region: '华北'], [id: 'A003', cat: '手机', price: 3999, qty: 1, region: '华北'], [id: 'A004', cat: '配件', price: 59, qty: 3, region: '华东'], [id: 'A005', cat: '家电', price: 2599, qty: 1, region: '华南'], [id: 'A006', cat: '', price: 499, qty: 2, region: '华东'] ]
注意第六行的品类是空字符串——这是我们故意埋的脏数据,后面清洗环节会处理。
第二步:清洗——让数据可信任
清洗的第一步是过滤脏数据。品类为空、数量为负、价格为空的记录都不该进入统计:
def clean = orders.findAll { it.cat && it.qty > 0 && it.price }
这里用到的正是 2.3 的 Groovy Truth:it.cat 自动处理空字符串与 null。清洗阶段的目标不是"删数据",而是"让数据定义明确"。这一阶段建议用显式规则写清楚,因为它决定了后面所有统计的可信度。
第三步:聚合——闭包与 GDK 的主场
def byCat = clean.groupBy { it.cat } def report = byCat.collectEntries { cat, list -> def amount = list.sum { it.price * it.qty } def count = list.size() [cat, [amount: amount, count: count]] } println report // [手机:[amount:13997, count:2], 配件:[amount:822, count:2], 家电:[amount:2599, count:1]]
groupBy 分组,sum 带闭包求和,collectEntries 组装结果。三行完成三个统计维度。这就是闭包式集合操作的力量——你描述"按品类分组""求每组金额",迭代细节交给标准库。
第四步:输出报表——GString 的用武之地
def lines = [] lines << '品类 销售额 订单数' report.each { cat, s -> lines << "$cat ${s.amount} ${s.count}" } println lines.join('\n')
GString 让报表行拼接像写自然语言。更精细的需求——按地区算客单价、给数字加千分位——也都是同样模式的延伸,用 collect + GString 就能完成。
数据处理流水线全景
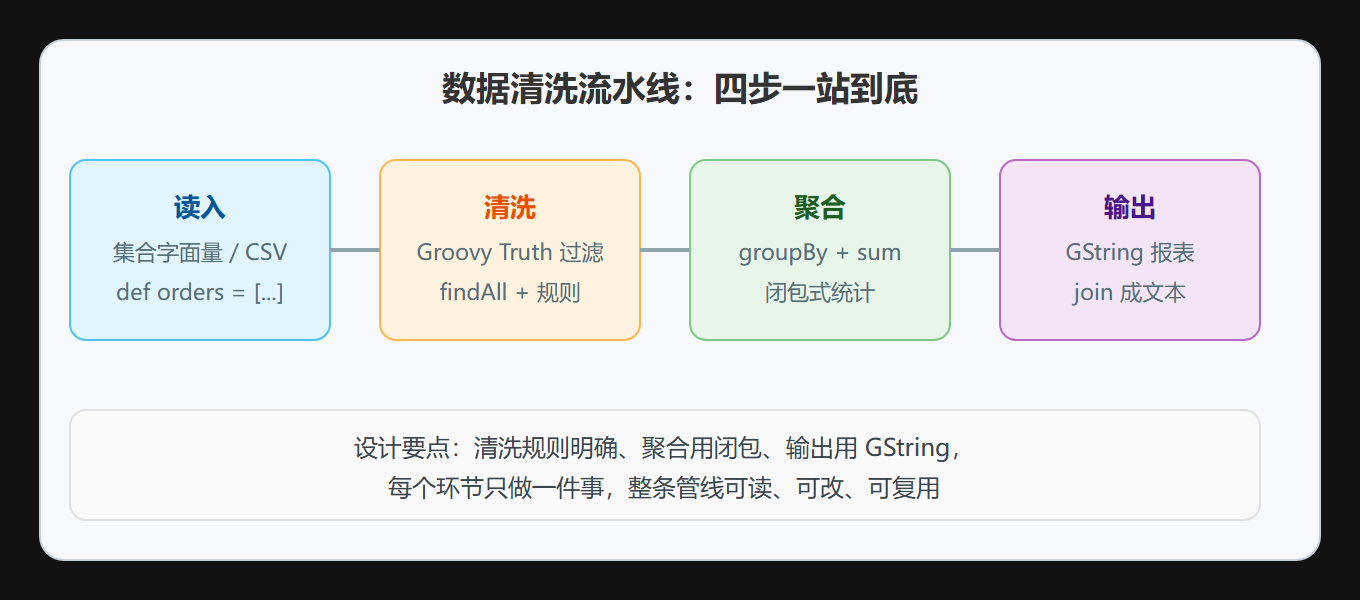
三、工程实践要点:这个实战教会我们的取舍
这个脚本如果只用十分钟写完,价值在于"快"。但要把它当工程看,有三条取舍经验值得沉淀。
第一,清洗规则必须显式。findAll { it.cat && it.qty > 0 } 看着简洁,但每个条件都是业务决策——"空品类算不算脏数据"这个决定,应该写清楚,而不是隐含在代码里。建议清洗规则用有名字的闭包或注释标明。
第二,聚合逻辑用闭包没错,但性能有边界。groupBy + sum 在几万行数据上完全够用;数据量到百万级,闭包创建的中间对象会成为压力。到那个量级,就该考虑转用 SQL 或者 MapReduce 式的并行处理(第 7.2 节讲 GPars 并行集合)。
第三,一次性脚本也要考虑复用。加一个参数(数据来源文件路径、输出格式、过滤条件),把核心逻辑抽成函数,这个脚本就升级成了可维护的工具。Groovy 的优势是"从脚本到工具"的升级成本极低——不必提前设计接口,边用边演化。
| 环节 | 推荐写法 | 如果数据量大 |
|---|---|---|
| 读入 | 集合字面量 / CSV 库 | 流式读取,勿全量载入 |
| 清洗 | findAll + 显式规则 | 下推到数据库 WHERE |
| 聚合 | groupBy + sum | 并行集合 / SQL |
| 输出 | GString + join | 写文件,勿全量进内存 |
⚠️ 常见坑:在一次性脚本里过度设计——接口、抽象、单元测试全上,把一个 50 行的脚本膨胀成 300 行框架。Groovy 的价值恰恰在于"先跑起来"。给脚本留一个演进路径(函数化、参数化)就够了,别提前建设。
💡 关键直觉:判断动态特性该不该用,就看"这个环节变化的频率"。清洗规则每月变一次,闭包写规则很合适;统计口径是审计级契约,就该写死、写测试。把变化的和稳定的分开,是脚本工程化的第一课。
参数化升级示例
def summarizeOrders(List orders, String category = null) { def filtered = orders.findAll { it.cat && it.qty > 0 } if (category) filtered = filtered.findAll { it.cat == category } filtered.groupBy { it.cat } .collectEntries { cat, list -> [cat, [amount: list.sum { it.price * it.qty }, count: list.size()]] } }
一个默认参数 + 两行过滤,脚本就变成了可复用的函数。这就是 Groovy 脚本向工程演进的典型路径——不推翻重写,持续小步增强。
四、进阶:读真实 CSV 与输出 JSON
前面的例子用了内存中的集合字面量,是为了聚焦核心逻辑。真实的运营数据通常在 CSV 文件里,用 Groovy 读真实文件也毫不费力,而且能顺手演示 @Grab 的威力。
读 CSV
@Grab('org.apache.commons:commons-csv:1.10.0') import org.apache.commons.csv.* def records = new File('orders.csv').withReader { reader -> CSVFormat.DEFAULT.withFirstRecordAsHeader().parse(reader) .collect { row -> [ id: row.get('订单号'), cat: row.get('品类'), price: row.get('单价').toBigDecimal(), qty: row.get('数量').toInteger(), region: row.get('地区') ] } }
注意两个细节。一是 withReader 闭包式资源管理——无论是否抛异常,文件都会正确关闭,这正是"执行围绕方法"模式的雏形,第 8.1 节会正式讲。二是 .toBigDecimal() 和 .toInteger() 的显式类型转换——CSV 里的字符串不会自动变成数字,这是数据处理里最常见的坑,必须显式转换。如果转换失败(脏数据),脚本会抛异常;想要更稳健,可以包一层 try-catch 或自定义清洗规则。
输出 JSON
@Grab('com.google.code.gson:gson:2.10.1') import com.google.gson.Gson def result = [summary: summarizeOrders(records), generatedAt: new Date().format('yyyy-MM-dd HH:mm')] def json = new Gson().toJson(result) new File('report.json').text = json
@Grab 让脚本零配置地引入 Maven 生态的库,这是 Groovy 作为胶水语言的重要能力。但要注意:在 CI 或生产脚本里,依赖应该显式声明在构建文件里,而不是靠 @Grab 现场拉取——前者可复现,后者依赖网络和缓存。
错误处理意识
脚本虽短,错误处理不能省。三处最关键:文件不存在(检查 File.exists() 并给可读提示)、数据格式异常(CSV 列缺失、数字转换失败)、统计口径变化(运营改了规则但脚本没跟上)。Groovy 的弹性让脚本跑起来容易,但也容易让人忽略错误处理——建议至少给脚本入口加一个 try-catch,把异常信息打印成"人话",而不是一长串堆栈。
五、把脚本变成工具的路径
最后给一条从"一次性脚本"到"可维护工具"的演进路径,这是实战的价值所在:
- 第一版:裸脚本,跑通流程,验证逻辑。
- 第二版:抽函数(如
summarizeOrders),加参数(品类过滤、输出格式)。 - 第三版:错误处理完善,输入输出可配置(命令行参数或配置文件)。
- 第四版:测试补上——清洗规则、聚合口径都值得写 Spock 测试固化下来。
每一步都是小改动,不需要推翻重来。这正是 Groovy 脚本工程化的核心优势:渐进式成熟。别在第一版就背上全部工程负担,但也别停在第一版。"能跑"和"可维护"之间的距离,就是这四步。
六、这个实战为什么值得再复盘一遍
复盘的价值在于把"做过"变成"理解"。这个脚本虽然小,但浓缩了本书前半部分的几乎所有关键点,值得逐条对照:
第一,语法糖是手段不是目的。我们用了集合字面量、GString、闭包、GDK 方法,但每一个都用在了"减少噪音"的位置上——没有为了用而用。写 Groovy 的标准不是"代码短",而是"读代码的人能最快理解业务"。如果某条语法糖让代码变短却让意图变模糊,它就是负资产。
第二,数据处理的通用骨架浮现了。任何数据处理任务,无论领域是什么,骨架都是"读入 → 清洗 → 变换 → 聚合 → 输出"。这个骨架你在 2.4 练过一次,第 5 章做 DSL 时还会见到它的变体——那时它叫"管线"。把骨架练熟,新任务来了就是填内容,不是从零开始。
第三,动态特性的边界感出来了。脚本里哪些地方动态(聚合规则用闭包)、哪些地方收敛(清洗规则显式、数字显式转换),你心里应该已经有了一条线。这条线是全书反复打磨的核心能力——知道什么时候该让 Groovy 灵活,什么时候该收住。
如果把数据换成百万行
最后做一个思维实验:如果这份数据是一百万行,这个脚本会怎样?三条结论:第一,groupBy 全量进内存,一百万个 Map 对象会让 GC 压力陡增——这时应该用流式或并行集合(第 7.2 节);第二,闭包在循环里反复创建,可以用复用闭包变量或 @CompileStatic 缓解;第三,统计口径此时已经从"临时需求"变成"数据契约",必须写 Spock 测试固化。这个思维实验的意义在于:脚本的"能跑"和系统的"能扛"之间,隔着一整本第 7 章的知识。现在知道差距在哪,学第 7 章时就有目标了。
实战检查单
收尾之前,对照检查单过一遍,确认这个实战你真的做透了:
- 是否理解了每一条闭包在做什么,而不只是会抄?
- 是否知道脏数据会从哪些环节混进来(空值、类型、异常字符)?
- 是否知道这个脚本在大数据量下会卡在哪,以及备选方案?
- 是否能把
summarizeOrders改成按地区、按日期维度聚合? - 是否能给这个脚本补上 Spock 测试?
如果五个问题都能答,这一章的实战就真正归你了。下一章进入面向对象进阶,我们会把"继承"这件事重新拆开来看——Groovy 用特质给出了一个不同于 Java 单继承的答案。
一句话总结这个实战
这个实战的本质,是用约五十行 Groovy 完成了一个 Java 项目里可能要写两百行加三个类的数据处理任务。省下来的不是体力,而是把"意图到代码"的距离缩短了——运营说"按品类看看",代码就真的只是"按品类看看"。当你习惯了这种距离,会反过来发现 Java 里那些循环和样板其实是可省的语言税。这就是 Groovy 脚本的魅力,也是它为什么值得出现在你工具箱里的原因。当然,如我们反复强调的,省税不等于免税——动态性的代价(性能、类型安全、可维护性)都在,只是换了个位置。清楚了这些,你才算是真正"会用"而不是"被它诱惑"。
要点速记
- 完整管线:读入 → 清洗 → 聚合 → 输出,每步用最适合的语法糖。
- 清洗显式化:Groovy Truth 简洁,但规则意图要写清楚。
- 聚合声明式:groupBy + sum + collectEntries 三行完成多维度统计。
- 输出 GString:报表生成像写散文,可读性直接拉满。
- 性能边界:小数据量随便写,大数据量转 SQL 或并行。
- 演进路径:脚本 → 函数 → 参数化 → 工具,小步增强而非重构。
- 核心取舍:动态特性投给变化频繁的环节,稳定契约要写死写测试。
这一章把"用 Groovy 写代码"的手感建立了。下一章进入面向对象进阶——特质、类别、泛型,看 Groovy 怎么在继承体系之外重构代码复用。