4.3 文件读写与路径解析
4.3 文件读写与路径解析
本节摘要:Blender 语境下的文件读写承载时间与空间的双重责任。空间上,路径有三重上下文——用户视角的相对路径、系统视角的打包资源、沙箱视角的用户资源目录;时间上,外部时间流与离散帧号需要显式换算。本节讲路径解析器的设计、大文件的内存映射加载、多插件共享文件的原子替换,以及"保存用户设置"的正确姿势。
核心问题
阅读完本节,你应当能够:
- 正确解析双斜杠相对路径并处理打包资源;
- 跨平台定位用户资源目录,不写死任何路径;
- 用内存映射加载 GB 级点云而不耗尽内存;
- 用临时文件加原子替换避免多插件竞态。
一、路径的三重上下文
多数开发者以为路径就是字符串拼接。在 Blender 里,同一个逻辑路径至少有三种身份。
用户视角:工程文件里常见的 //textures/brick.jpg——双斜杠表示相对于当前工程文件。插件若直接做字符串拼接,得到的是字面意义的路径而非真实位置,必须调用路径解析接口把相对路径展开成绝对路径。
系统视角:用户打包资源后,// 指向的文件实际已嵌入工程文件内部。此时解析接口可能返回伪路径,真正的内容要从图像数据块的打包文件成员读取。插件若不区分这两种状态,打包工程发给别人就丢贴图。
沙箱视角:在线资产插件下载的资源存于用户配置的资产目录,位置由用户资源查询函数动态确定,且随操作系统而异——Windows 的应用数据目录、macOS 的资源库、Linux 的配置目录各不相同。硬编码任何一个,跨平台分发即失败。
鲁棒的文件模块应内置路径解析器:根据运行时上下文自动选择解析策略,对外提供统一接口——传入路径字符串,返回文件内容或真实位置。
import bpy, os def resolve_texture(raw_path): # 展开相对路径 abs_path = bpy.path.abspath(raw_path) if os.path.exists(abs_path): return ("file", abs_path) # 尝试打包资源 img = bpy.data.images.get(os.path.basename(raw_path)) if img and img.packed_file: return ("packed", img.packed_file.data) return (None, None) def addon_config_dir(): # 用户资源目录 跨平台安全的插件自管配置落点 root = bpy.utils.user_resource('CONFIG') path = os.path.join(root, __name__) os.makedirs(path, exist_ok=True) return path
⚠️ 常见坑:把双斜杠路径直接交给标准库的打开函数。字符串拼接出来的路径指向工作目录而非工程目录,本机"碰巧能跑",用户机器上必坏。相对路径必须先过解析接口。
二、时间维度:外部时间流到离散帧
文件不只是空间坐标,还是时间容器。从外部读取帧序列(图片序列、带时间戳的点云)生成动画时,插件必须回答:这些帧映射到时间线的哪个范围?起始帧是固定值还是跟随项目设置?帧率匹配工程还是锁定源数据?
外部时间戳到帧号的换算,本质是一次仿射变换:先减去外部时间零点,除以采样间隔得到"外部帧号",再乘以目标帧率并加偏移。公式不复杂,但指向一个本质矛盾:Blender 的时间模型是离散帧号,物理世界的时间是连续流。不做显式换算,动画就会出现跳帧或拖影;做了换算,还要决定四舍五入策略并保证确定性——同一份数据每次导入结果一致,撤销重做才可信。
def timestamps_to_frames(times, origin, interval, fps, offset): """外部时间戳序列 → 确定性的帧号序列""" return [int(round((t - origin) / interval * fps)) + offset for t in times]
三、大文件:内存映射让 GB 级数据可加载
一个两 GB 的点云文件,一次性读进数组将瞬间耗尽内存。专业方案是内存映射:把文件映射进虚拟地址空间,按页按需加载,把 I/O 压力从物理内存转给操作系统的页调度。解析二进制格式头定位数据块偏移后,直接从映射区构造结构化数组——零拷贝:
import mmap import numpy as np def load_vertices_mmap(filepath): with open(filepath, 'rb') as f: with mmap.mmap(f.fileno(), 0, access=mmap.ACCESS_READ) as mm: header_end = mm.find(b'end_header') header_end = mm.find(b'\n', header_end) + 1 dtype = np.dtype([('x', 'f4'), ('y', 'f4'), ('z', 'f4')]) # 从映射区直接构造视图 不复制数据 return np.frombuffer(mm, dtype=dtype, offset=header_end)
收益有三:内存占用只与实际访问的页相关;加载速度由页调度按需承担;后续向量化处理(第 5 章的性能主题)可以直接在这个视图上进行。新一代的点云对象类型底层正是类似机制实现的延迟加载。
四、并发安全:原子替换是唯一被保证的手段
多个插件操作同一文件是常态:A 写缓存文件、B 读缓存文件。文件锁不可靠——解释器的线程锁无法保护文件系统。操作系统层面唯一被保证的并发安全手段是原子替换:先写临时文件,全部落盘后用原子重命名替换正式文件。读方任何时刻看到的都是完整的旧文件或完整的新文件,绝无半截状态:
import os, tempfile def atomic_write_json(path, data): directory = os.path.dirname(path) fd, tmp = tempfile.mkstemp(dir=directory, suffix=".tmp") try: with os.fdopen(fd, 'w', encoding='utf-8') as f: json.dump(data, f, ensure_ascii=False, indent=2) f.flush() os.fsync(f.fileno()) # 确保落盘 os.replace(tmp, path) # 原子替换 except BaseException: os.unlink(tmp) # 失败清理 不留半截 raise
这个模式在 Windows 与主流平台都成立。顺带一提,用户设置的保存也应遵循"变更即写、原子落盘"——用户调了半天的偏好,不能因为一次异常退出而回 factory 状态。
五、工程实战:给插件加导出预设
把本章技术串成一个完整功能——把第 2 章插件的参数预设导出为文件、再导入:
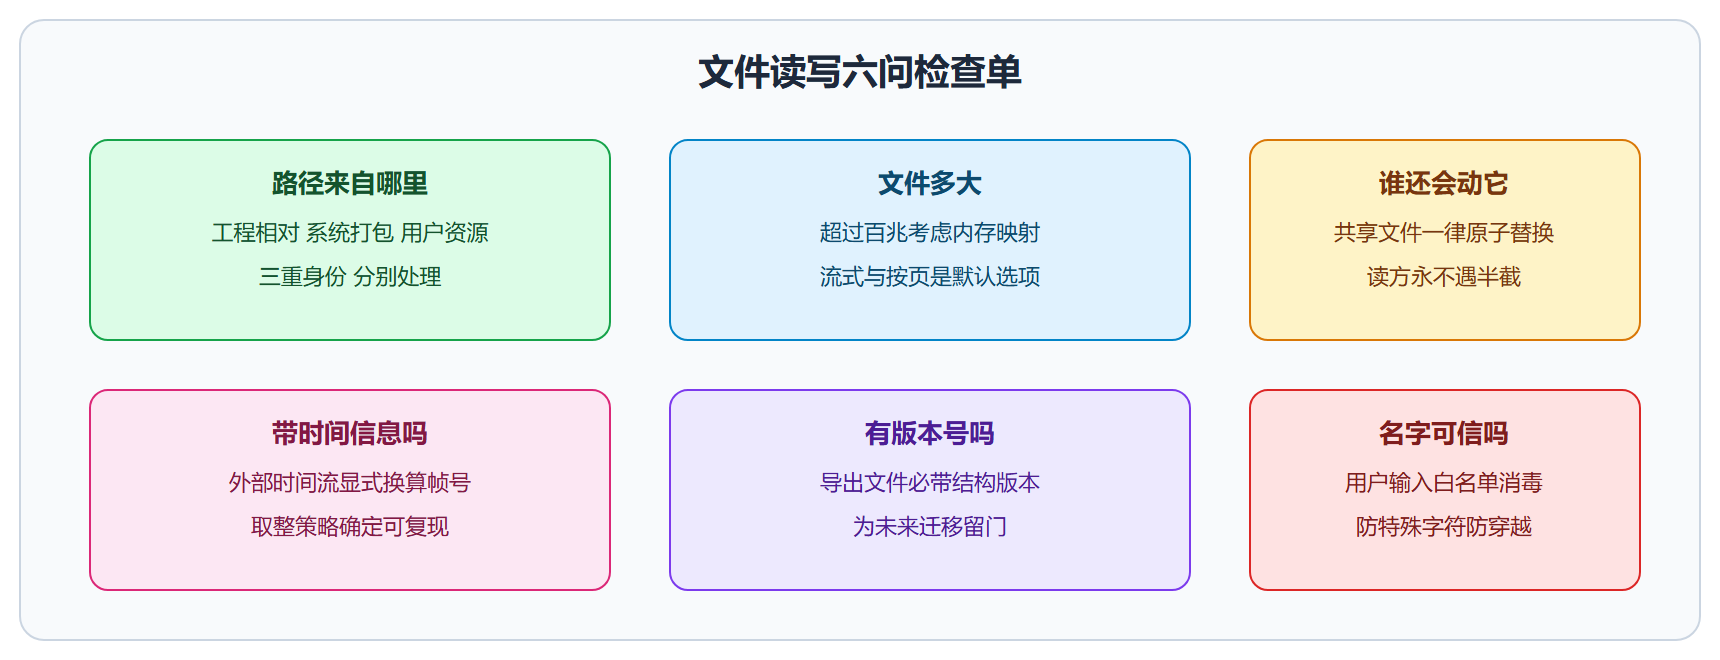
三个细节决定成败。导出要带版本号——属性组结构将来会变(第 6 章讲迁移),无版本号的存档是定时炸弹。导入要校验后赋值,赋值走属性组而不是绕开它——这样更新回调、撤销登记、界面刷新全部自动生效。文件名要消毒——用户输入的名字直接当文件名,特殊字符与路径穿越都会出事,白名单过滤是最便宜的自卫。
| 场景 | 错误做法 | 正确做法 |
|---|---|---|
| 工程相对路径 | 字符串拼接 | 解析接口展开 |
| 打包资源 | 直接读磁盘 | 检查打包成员读内嵌数据 |
| 配置目录 | 写死平台路径 | 用户资源查询函数 |
| 大文件 | 一次读入 | 内存映射按页加载 |
| 共享文件 | 直接覆盖写 | 临时文件加原子替换 |
| 用户文件名 | 直接拼接 | 白名单消毒 |
文件读写检查清单
六、路径与文件的进阶问答
相对路径在什么时机解析最合适?
使用时解析,不要启动时解析后缓存——用户可能在会话中另存了工程,相对路径的锚点就变了。每次读写前现解析,成本可忽略,正确性永远在线。同理,遍历工程引用的资源时,逐个现解析而不是攒一份绝对路径列表,后者在用户移动文件后整体失效。
内存映射的数据什么时候失效?
映射区在文件对象关闭或映射对象释放后失效。所以从映射构造的数组要么在使用完毕前保持映射存活,要么及时拷贝出需要的部分再释放映射。常见错误是函数返回了基于映射的数组视图、映射已在函数内关闭——调用方拿到一段悬垂内存,读出来的是垃圾值且不一定报错。返回前显式拷贝,是最稳妥的纪律。
导出大文件怎么避免占满磁盘?
两招:流式写出(边生成边写,不在内存里攒完整结果)与预估检查(写出前估算目标体积,超过阈值提示用户或自动降级精度)。临时文件也要算在占用里——原子替换的中间产物在写入期间与正式文件并存,磁盘峰值是双份。写完确保替换成功后,临时文件不复存在;失败路径的清理要覆盖所有异常出口。
跨平台还有哪些隐藏差异?
路径分隔符之外:文件名大小写敏感性(两个仅大小写不同的文件在 Windows 共存失败)、非法字符集(冒号问号星号各平台不同)、路径长度上限、以及换行符差异(文本模式读写时的自动转换可能损坏二进制数据——二进制务必用二进制模式打开)。这些差异平时隐形,在用户群里必然发作;白名单消毒加二进制模式显式声明,是最省心的组合拳。
七、一个完整的导入器走查
用走查方式把本章知识串成完整流程——假设要写一个"从结构化文本导入标记点"的功能。
第一步,接入:拿到用户给的路径,先过相对路径展开(用户很可能拖进来一个工程内相对路径);文件不存在时报错并附建议("请检查文件是否被移动")。第二步,解析:整个文件读入、逐行解析成中间表示列表(坐标加标签加分组),解析层不创建任何场景对象;格式错误的行记入警告列表而不是中断整个导入。第三步,映射:按分组创建集合并赋予语义命名,同名冲突走用户可配置的消解策略;标记点转成球体物体,业务标识写进自定义属性。第四步,落库:批量创建在主线程一次完成,结束后统一报告"成功 N 个、跳过 M 行(原因分布)"。
走查的要点在边界:空文件、只有头没有数据、坐标超范围、分组名含非法字符——每个边界都有确定的分支与用户能看懂的说法。把这份走查表保存下来,它就是第 6 章契约测试的用例清单雏形。
八、路径解析器的完整接口设计
把 4.3 节的解析器思路落成完整接口,供直接采用。解析器对上暴露三个方法:解析(输入原始路径,输出真实位置或内嵌数据的统一描述)、存在性检查(综合磁盘与打包两种状态)、读取(按描述返回内容,调用方无需关心来源)。内部维护一张"打包资源索引",在文件加载事件时重建——工程打包状态变化时索引自动同步。设计要点有二:对外统一、对内分层,调用方彻底摆脱"这是磁盘文件还是内嵌资源"的心智负担;索引的重建挂在生命周期事件上而非每次查询时全量扫描,热路径零额外开销。这个解析器一旦写好,全插件所有涉及路径的代码都应经它,不再出现第二处路径拼接。
一节小结
- 要点一:路径有三重身份——相对路径要展开、打包资源读内嵌、资源目录动态查;
- 要点二:外部时间流到帧号必须显式换算且策略确定,否则跳帧拖影加撤销失真;
- 要点三:内存映射让 GB 级文件按页加载,零拷贝衔接向量化处理;
- 要点四:原子替换是操作系统唯一保证的并发安全写入手段,共享文件必用;
- 要点五:导出的数据文件带版本号,导入走属性组赋值让回调与撤销自动生效;
- 要点六:用户提供的文件名要白名单消毒,这是最便宜的自卫。
记忆系统完工。第 5 章进入深水区:让它快起来、不卡顿、还能跑原生代码。