1.3 四个真实故障里的共同缺口
1.3 四个真实故障里的共同缺口
本节摘要:延迟飙升、连接泄漏、容器逃逸、调度抖动看起来不像一类事故。把它们拆到内核路径上,缺的是同一种能力:在特定瞬间关联进程与内核对象,并且能按条件开关、能立刻卸载。本节用四个场景把第 1 章的痛点钉成可检验的需求清单。
阅读收获
阅读完本节,你应当能够:
- 把四类故障映射到具体的内核瞬间和对象
- 指出每类故障上传统手段会丢哪一块证据
- 写出 eBPF 介入时该挂的程序类型方向(不必一次写对代码)
- 用同一张缺口清单评估自己环境里的下一起事故
故障复盘里最浪费时间的一句是:“应用日志没看出来。” 下面四个故事都在这句话里停过。它们业务完全不同,缺口却能合并成一张表。
一、延迟:P99 跳了,栈上没有坏人
某支付接口在滚动发布的 10 分钟内 P99 从 6 毫秒跳到 90 毫秒。应用线程池空闲,SQL 正常,Sidecar 的 HTTP 直方图几乎没动。真正的时间花在内核:新版本把连接改成短连接,connect 在 syn backlog 满时阻塞;同时节点开了 CPU 限额,软中断和用户态抢同一核。
用户态看见的是“这次 RPC 慢”。抓包看见三次握手重传,却对不上是哪个 Pod。系统调用追踪能对上进程,一开就让已经很满的 CPU 更满,故障被放大。采样剖析给出的热函数是加密库——那是平均值,不是这 10 分钟里的排队。
缺口是:在 connect 返回前,把进程、cgroup、TCP 状态机和等待原因绑在一条记录上,并且只在耗时超过阈值时输出。这正是追踪类挂载点加 Map 聚合擅长的事,详见第 4 章。
二、连接:fd 没漏,内核里的 sock 在漏
有个网关内存缓慢上涨,应用侧文件描述符数量稳定。最终发现是 TCP 连接在 FIN_WAIT 一类状态里堆积:对端不按预期关闭,本端应用已经把 fd 关掉,内核还在为 sock 记账。用户态工具盯着 fd,自然说没泄漏。
抓包能看见 FIN 往来,但你很难在海量连接里自动找出“应用已关闭、内核未释放”的那一群。ss 能快照,却给不出“是哪次发布引入的关闭路径错误”。你需要按 inode 或 sock cookie 做生命周期跟踪:创建、用户态 close、内核真正释放。没有跨事件状态,快照只是一张张照片,拼不出动画。
缺口是:跨系统调用保存一份小状态,而不是每次都把全量连接表拖到用户态。Map 就是为这个存在的,详见第 3 章。
三、逃逸:策略写在 YAML 里,执行发生在系统调用里
一次演练里,容器里的进程通过可写挂载点组合出提权路径。网络策略显示“只允许 443 出站”,但逃逸发生在文件与命名空间操作上,Sidecar 完全无感。主机审计日志有,却是事后全量,没有“该容器是否允许 unshare / mount”的即时裁决。
安全团队习惯的边界模型在这里失效:包过滤看的是已经形成的连接,YAML 看的是意图。真正的执行点是系统调用入口。要在那个入口结合进程凭证、cgroup、文件路径做允许或拒绝,还不能把节点审计 IO 打满。
缺口是:把策略下沉到 LSM 或系统调用钩子,用 Map 存放策略,用验证器保证策略程序自己不会把内核写坏。这不是替代所有安全产品,而是补上“意图与执行之间的那一毫米”。
四、调度:CPU 不忙,任务却在饿
批处理与延迟敏感服务混部。平均 CPU 40%,延迟敏感服务却出现 50 毫秒级毛刺。原因是 CFS 在唤醒路径上的排队,加上一次内存回收把持锁时间拉长。用户态看到的是“偶发超时”,top 看到的是大家都挺闲。
调度问题几乎无法用抓包理解。你需要 sched_switch、唤醒、以及当时的 runqueue 深度。采样剖析能碰到调度器函数,但关联不到“被谁抢了、抢的时候内存压力多大”。把调度事件和内存回收事件在同一时间轴上对齐,才说得清毛刺。
缺口是:系统类挂载点上的低开销计数 + 条件出栈,而不是持续把每次切换都打到磁盘。
五、把四个故事收成一张缺口清单
| 故障 | 关键内核对象 | 传统手段丢什么 | 需要的瞬间 | eBPF 方向 |
|---|---|---|---|---|
| 延迟飙升 | sock、cgroup、等待队列 | 进程语义或自身开销 | connect/recv 超时那一拍 | 追踪类 + 阈值过滤 |
| 连接泄漏 | sock 生命周期 | 只看见 fd 不看见内核态 | close 与真正释放 | Map 做状态机 |
| 容器逃逸 | 凭证、命名空间、文件 | 网络策略看不见系统调用 | 危险调用入口 | LSM/系统调用钩子 |
| 调度抖动 | 任务、runqueue、回收 | 平均值掩盖饿死 | 切换与唤醒 | tracepoint 计数 |
四行可以合成一句需求:
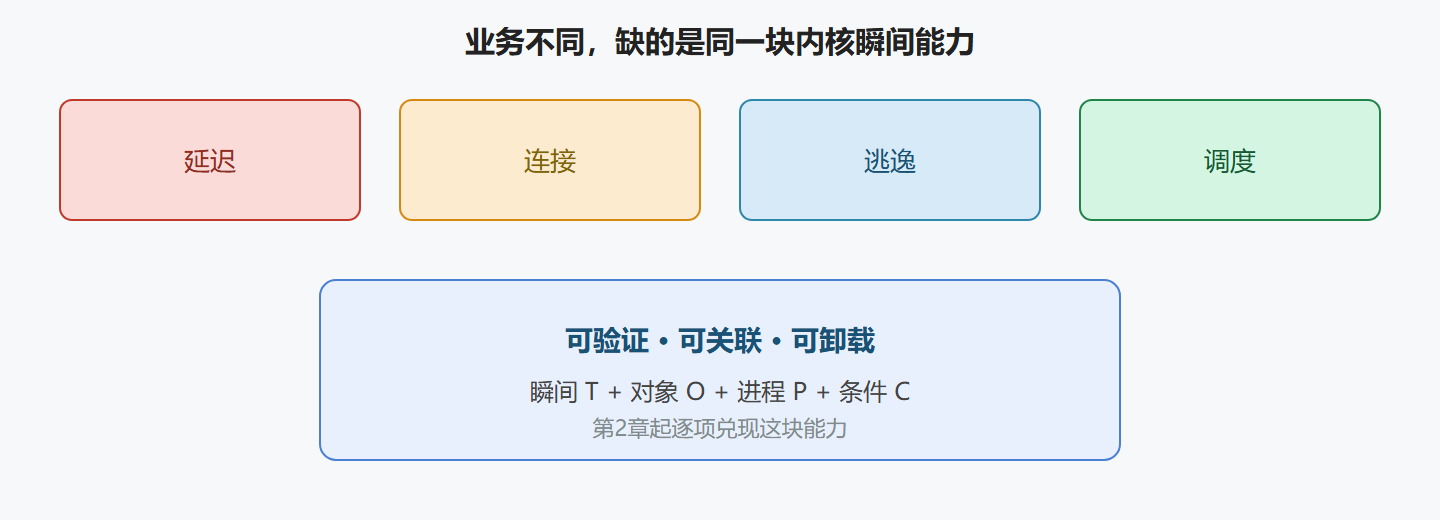
在瞬间 T,读取对象 O 的字段, 关联到进程 P 与工作负载 W, 若条件 C 成立,则写入 Map 或输出一条事件; 程序必须可验证、可卸载、默认克制。
这就是后文所有机制要对齐的规格。验证器保证“读取字段”不会变成任意内核写;Map 保证跨事件有记忆;挂载点决定瞬间 T 是否存在;工具链决定你能不能把这段规格变成可发布物。
⚠️ 常见坑:用一个超级程序同时打四个场景。验证器路径会爆炸,开销也无法按场景关停。生产上按故障类型拆程序,用 Map 共享少量状态即可。
💡 关键直觉:先写上面那四行规格,再去选 kprobe 还是 XDP。先选技术名词的人,最后会把探针挂在错误的时间点上。
图:四个故障共用同一块缺失能力
问题:这四个场景是不是都该上 eBPF?
不一定。如果延迟来自下游 HTTP 500,先查服务。eBPF 适合“用户态证据链断在内核对象上”的情况。四个故事的共同点是证据链断点明确,不是“先上 eBPF 再看能挖出什么”。
问题:没有生产权限怎么练?
用一台可控虚拟机复现“短连接 + cgroup 限额”就能看见延迟构成变化。不要在别人的生产节点上练卸载和全量 kprobe。
六、把缺口写成可验收的探针规格
四个故事若只停在“需要 eBPF”,下一步仍会吵。把缺口写成可验收规格,团队才能分头干活。规格至少包含:瞬间名称、关联键、条件、输出、预算、卸载方式。没有预算的规格会在评审时被当成愿望。
延迟规格示例:挂在系统调用退出跟踪点;键是 tgid 加 cgroup id;条件是耗时大于 20 毫秒;输出是 pid、耗时桶、可选栈;预算是每核每秒最多 200 条事件;卸载是毁掉 link 且不 pin。连接规格示例:在创建与关闭路径更新 HASH;键用 sock cookie;满员告警;禁止 LRU。逃逸规格示例:LSM 上先计数后拒绝;策略表用户态写;双开关。调度规格示例:切换跟踪点只做直方图;超过 10 毫秒唤醒延迟才抽样。
验收不要只验收“能看见数据”。要验收假阳性:在健康流量下事件率是否可接受;验收假阴性:用已知慢调用能否打出事件;验收关闭:开关关掉后 P99 是否回到基线。三项缺一,上线后你无法证明仪器在工作,也无法证明仪器没在捣乱。
四个缺口还会互相污染。为了查延迟开的系统调用探针,可能让调度毛刺更明显,于是你以为发现了调度问题。对照实验必须按故障类型隔离:查延迟时先关掉调度探针,查调度时先关掉出栈。共用 Map 可以,共用热路径出栈不行。
最后写进复盘模板:下次再出现“日志看不出来”,先填缺口表,再提工具需求。表填不清,说明问题还停留在业务层,不该进内核。这能挡住很大一部分跟风式上探针,把真正的内核瞬间留给真正的断点。
现场笔记:四个缺口同时出现时先救哪一个
高峰时延迟、连接堆积、调度毛刺可以一起出现,看起来像要同时上四套探针。同时上会让对照实验失效:你不知道是谁伤了 P99。顺序应是:先开无条件计数的系统调用探针看频率是否离谱;再开连接表的满员告警看是不是表本身在制造问题;调度直方图放在第三,因为它最热;LSM 拦截永远不要在故障夜临时打开真拒绝。
救的是证据链,不是情绪。领导要“立刻看见一切”,你要翻译成“十分钟内给出哪一条链断了”。四套全开的十分钟,往往只换来一份被污染的现场和一张谁也读不完的事件洪水。先断定主缺口,再决定要不要第二套。主缺口判断错了,切换成本仍低于四套叠加。
把这个顺序写进应急预案,和数据库主从切换预案放在一起。内核观测没有预案时,现场会退化成谁声音大谁上工具。预案不保证判断正确,保证判断可回放:当时先开了什么,何时关掉,P99 如何响应。回放比天才更有用。
延伸讨论:缺口表怎样进复盘
复盘加三行:内核对象是什么,传统工具丢掉哪一段,若用 eBPF 则瞬间条件预算各是什么。三行空着就禁止写加强可观测性。空结论会原样迎接下一场故障。填过十次,团队自己知道哪些不该下沉。不该下沉的送回应用或数据库。该下沉的把规格交给框架选择,而不是交给嗓门。模板是在情绪高峰保持问题驱动的夹具。夹具比培训稳。培训会忘,提交框不会忘。强制填写看起来官僚,实际是给值班的人一块挡箭牌:表没填完,不上重工具。挡箭牌能减少镜像口事故,也能减少四套探针同时上的污染。污染一旦发生,对照实验就死了,后面的优化全是猜测。猜测很贵。
重点提炼
- 延迟:缺的是 connect/等待原因与 cgroup 的绑定,不是再一张 HTTP 直方图。
- 连接:fd 稳定不代表 sock 稳定,需要跨事件状态机。
- 逃逸:YAML 意图与系统调用执行之间缺即时裁决。
- 调度:平均值健康可以与饿死同时存在,需要对齐切换与回收。
- 共同规格:瞬间、对象、进程、条件、可验证、可卸载。
- 拆程序:不要用一个探针包打天下,开销和验证复杂度都会反噬。
下一章进入内核内部:一段字节码如何被验证、编译、挂上钩子,又如何在失败时被挡在门外。