1.1 规格拆解与模块接口
1.1 规格拆解与模块接口
本节摘要:规格拆解是把“芯片要做什么”翻译成时钟域、复位极性、端口位宽、握手与存储器边界。没有这张表,RTL 只是散文。本节给出一份能直接开写的接口契约,以及跨时钟域、复位和吞吐预算怎么落到端口,而不是落到注释里。
本节目标
阅读完本节,你应当能够:
- 从功能描述列出时钟、复位、数据、控制四类端口
- 用吞吐与延迟预算反推总线宽度和流水级数
- 标明跨时钟域点,禁止把异步信号当普通线
- 写出一份模块级接口表,作为后续 SDC 的草稿
一、先问交货,再问算法
芯片项目死得最早的一种方式,是算法组交出“参考模型能出正确结果”,硬件组按软件函数签名开写,三个月后才发现:参考模型按帧处理,硬件要按拍处理;参考模型允许反压停顿任意久,片上 SRAM 只有两个口;复位在模型里是“重新 new 一个对象”,在硅上是异步断言、同步释放,还要和扫描移位共存。
所以开工第一件事不是写加法器,是把规格拆成可被下一站工具消费的边界。综合器不读产品白皮书,它只认端口、时钟名和约束文件。布局工具不认“差不多 1 GHz”,它认你有没有把宏挡住时钟主干。测试机台不认“功能对了”,它认扫描链长度和捕获周期。
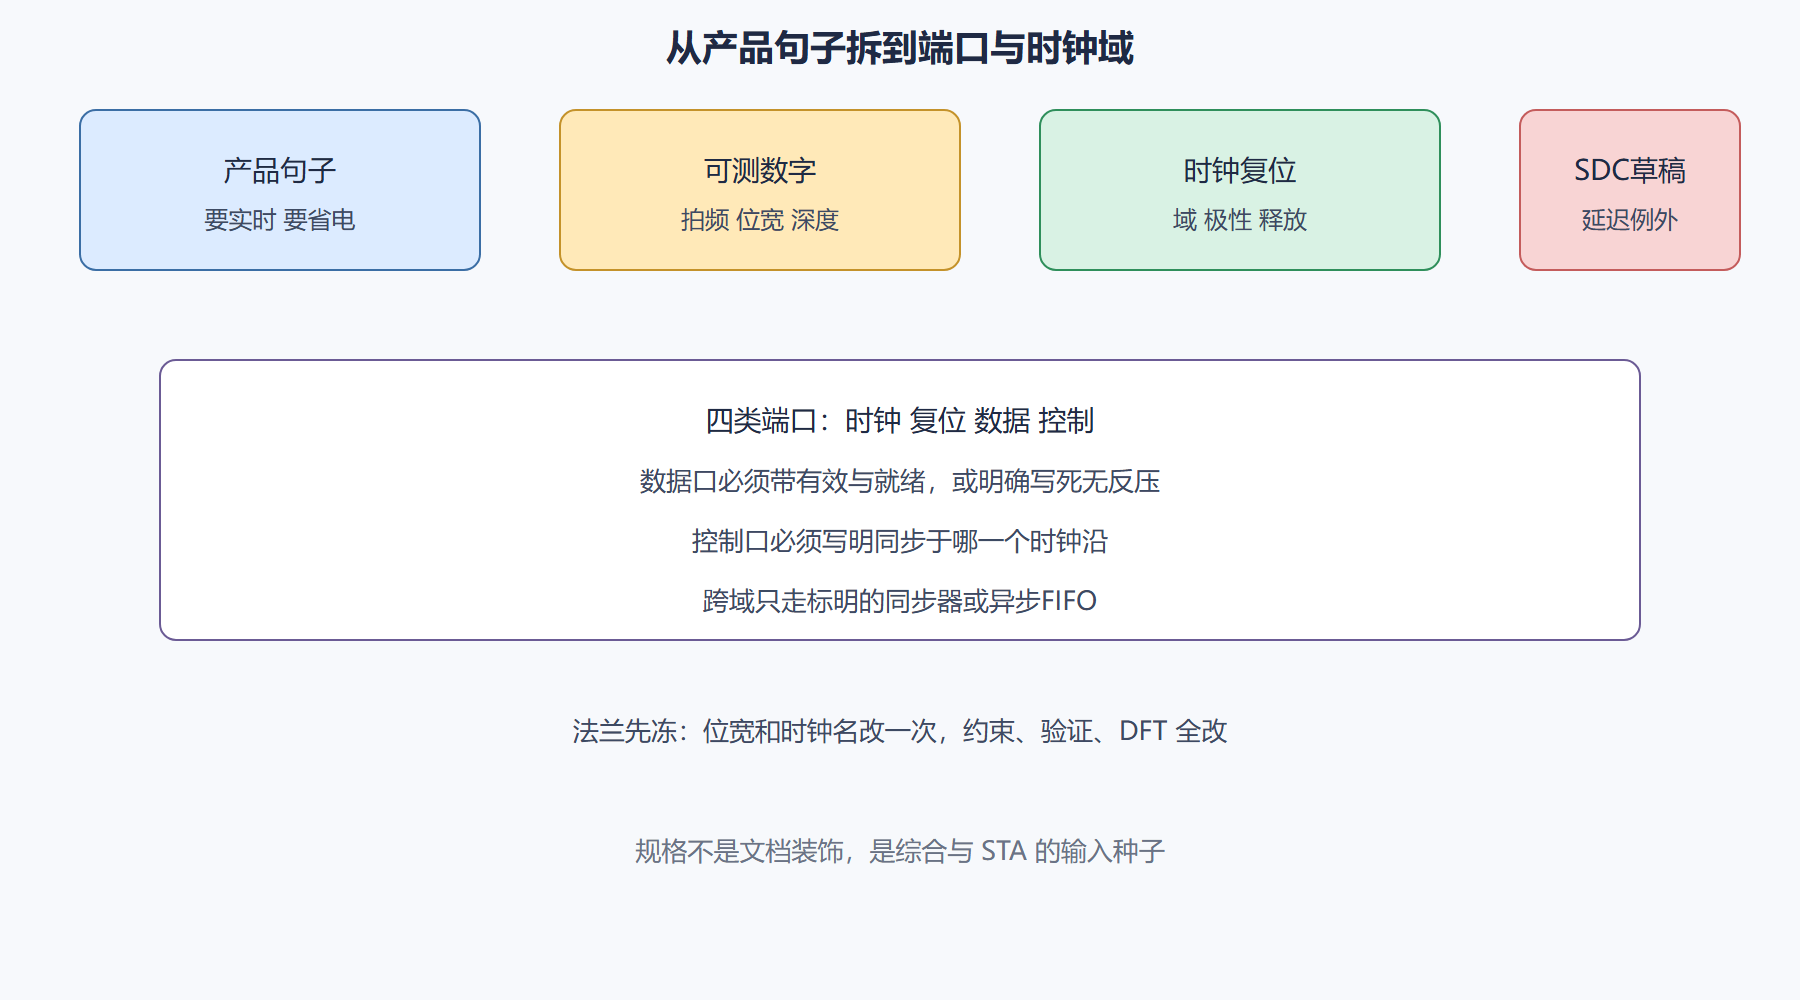
把芯片比作船坞合拢:分段车间可以并行焊肋骨,但合拢口的法兰直径、螺栓圆和密封槽必须先冻结。接口就是法兰。法兰改一次,所有已焊分段都要割开。
一份能开工的规格,至少回答六件事:
- 有几个时钟,谁是主拍,谁是常开域
- 复位是高有效还是低有效,异步进、如何同步出
- 每个数据口的位宽、对齐、是否允许背压
- 存储器是片上宏还是外接,端口数和延迟拍数
- 哪些信号会跨时钟域,同步方案是什么
- 性能数字是“典型激励平均值”还是“最坏包必须达标”
最后一条最容易被营销话术带偏。STA 只认最坏路径,不认平均帧率。规格里写“平均 4K30”,实现时必须改写成“像素通路每拍必须吐出 N 像素,行缓冲深度 M,否则丢行”。
图:接口契约拆解图
二、吞吐预算怎么变成位宽
假设规格写“视频通路要支撑每秒 60 帧、每帧约两百万像素、每像素 24 比特”。不要在会议上用“带宽很大”结束讨论。把它除到时钟上。
若像素时钟暂定 150 MHz,则每拍需要搬运的像素大约是:总像素率除以拍频。除不尽就有两种合法选择:加宽总线(每拍多个像素),或提高拍频。加宽会吃布线与引脚;提高拍频会吃建立时间。规格拆解的产出,是把这个选择写死,而不是留给写 RTL 的人现场拍脑袋。
算术通路同理。原文里 64 位行波进位在吉赫兹目标下会直接炸关键路径,这不是“以后综合器会优化”能糊弄的。规格阶段就要问:加法是一拍做完,还是切成两拍?乘法是 Booth 编码的组合阵列,还是流水乘加?你现在选的拍数,就是后面 STA 的周期预算。
存储器边界更不能含糊。片上 SRAM 宏通常有固定的建立保持和时钟到数据延迟,还可能要求地址在时钟沿前稳定。若规格写“随机访问”,实现可能是单口宏加仲裁;若写“同时读写”,必须双口或两块乒乓。原文强调过:逻辑门数量涨得快,片上存储容量和访问延迟涨得慢。规格里若假装存储是无限寄存器,后端只会在 floorplan 阶段拿宏把你的数据通路挤断。
像素率 ──÷──► 每拍像素数 ──► 总线位宽 │ └─► 行缓冲深度 ──► SRAM 宏规格
| 规格原话 | 应改写成的接口事实 | 若含糊会在哪一站爆 |
|---|---|---|
| 实时处理 | 每拍必须有数据或明确停顿协议 | 仿真能过,硅上欠拍 |
| 低功耗 | 哪些时钟可门控,唤醒几拍内就绪 | 综合插了门控,功能抖一下 |
| 可配置 | 哪些参数是综合常数,哪些是运行寄存器 | 位宽被参数化到综合器崩溃 |
| 与 CPU 相连 | 总线协议、对齐、错误响应 | 集成时发现从设备不会等 |
三、时钟域是接口的一部分
现代 SoC 很少单时钟。CPU 一个域,外设一个域,常开域可能只有几十 kHz 量级的唤醒逻辑。规格必须画出域,而不是在 RTL 里用“这个 always 块碰巧用了另一个 clk”偷渡。
跨域规则很硬:
- 单比特控制:两级触发器同步,第二级自己必须时序干净
- 多比特数据:用握手或异步 FIFO,禁止直接采样总线
- 复位:每个域有自己的同步释放链,不要一条复位线扫所有触发器还指望保持时间
这些内容后面 STA 会变成 set_clock_groups 和假路径。假路径不是“这条线我不想管”,而是“我已经用同步器保证功能,请 STA 不要用建立检查去审判两个无关时钟”。规格阶段不标跨域点,后端就会把异步口当成同步路径报一堆假违例,或者更糟:漏报真违例。
复位极性也要在接口表里写死。低有效复位在板上好接上拉,但和扫描使能混在一起时,测试模式的复位释放时序经常被忽略。原文前端章节写过:你在 RTL 里写的 if (!rst_n) q <= 0; else q <= d; 其实是在声明一份时序闭包——异步断言、释放时不能让复位树的偏斜制造出半个芯片已醒、半个还困在零的状态。
⚠️ 常见坑:接口文档只列数据位宽,不列“该信号相对于哪个时钟沿稳定”。STA 的 input_delay 只能靠猜,猜错就出现虚假违例或隐藏风险。
💡 关键直觉:端口表是 SDC 的草稿。你现在不写时钟名,综合脚本里就会出现一堆匿名虚拟时钟。
四、一份能开写的模块接口表
下面这种表,我要求每个顶层模块开工前填完。填不完就还没资格写功能。
模块:pixel_pipe 时钟:clk_pix 主拍;clk_cfg 配置域 复位:rst_n 异步进,各自域内两级释放 数据:tdata 48b 每拍两像素,tvalid/tready 配置:csr 同步于 clk_cfg,禁止被像素域直接读 存储:linebuf 单口 SRAM 宏,读延迟 1 拍 跨域:csr → 像素域只走握手影子寄存器
概念代码只表达契约,不当作工程落盘指令:
module pixel_pipe ( input wire clk_pix, input wire rst_n_pix, input wire clk_cfg, input wire rst_n_cfg, input wire [47:0] tdata, input wire tvalid, output wire tready, input wire [15:0] csr_addr, input wire csr_we, input wire [31:0] csr_wdata ); // 像素域不得直接采样 csr_wdata endmodule
验证计划也属于规格拆解。至少写清:复位释放后多少拍内接口必须回到空闲;反压拉低时上游不得丢拍;配置写与像素流重叠时,哪一拍生效。这些会变成断言,而不是变成“出了再看波形”。
问题:规格能不能边写 RTL 边改?
小模块可以。一旦时钟名、复位极性和主数据位宽冻结后又改,成本按几何级数涨:测试平台、断言、SDC、DFT 端口、PAD 定义全动。我的做法是把接口分成“冻结核”和“可长肉的内部流水线”。核改要开会;肉可以在时序收敛时切拍。
问题:算法模型要保留到什么时候?
一直保留到门级仿真和关键路径对照结束。模型是功能黄金,不是写完 RTL 就扔掉的脚手架。但模型的时间粒度必须标明:是无时序的函数,还是按拍对齐。两种对拍方式不同,混用会造成“参考也对、RTL 也对、两者对不上”。
五、把规格写成可执行的开工包
接口表填完仍不能开写的情况很常见:表上有时钟名,却没有“该时钟从哪颗 PLL 来、是否与配置域同源可当分频”。同源分频可以当同步处理并在 STA 里设倍数关系;不同源就必须走 CDC。写错这一格,后面假路径会成灾。
吞吐除法也要写余数去哪。每拍两个像素若行末只剩一个像素,是填哑元还是拉低 valid?哑元会进 SRAM 浪费,拉低 valid 要保证下游计数器不把空拍当像素。规格不写,验证各写各的黄金模型。
复位释放后的空闲态要能在波形上指出来:哪些寄存器必须是 0,哪些可以是 X。扫描退出后的状态若不算空闲,要规定再来一次功能复位。量产测试结束立刻进用户模式的芯片,这一条漏了会在产线表现为“偶发不开机”。
开工包建议至少五件:接口表、跨域清单、存储器宏意向(推断数组还是编译器)、断言列表、SDC 草稿。五件能被另一人按表实施,规格才算拆完。口头对齐不算。
把这五件放进版本库,和 RTL 同一提交。接口改了,五件一起改。只改代码不改表,就是下一次合拢口切错法兰。
六、和系统软件对齐的那一厘米
硬件接口表如果只给芯片组看,软件仍会按自己的头文件写驱动。复位后第几拍可以访问寄存器、哪些位在扫描退出后必须再写一遍、DMA 与 CPU 同时访问谁优先,这些都是规格。缺了它们,硅上“偶发错包”会在驱动线程里被解释成软件 bug,浪费数周。
把寄存器地图、中断脉冲宽度、缓冲深度写成与 RTL 同源的表。软件要的是稳定的拍数,不是“差不多一个周期”。跨域配置尤其要标明:写完到像素域生效需要几次握手。黄金模型若无时序,必须另做一份按拍的事务级模型给驱动联调,避免无时序模型把驱动教成错误的等待方式。
开工评审问三句:软件能否按表写出复位序列;测试机能否按表进扫描;后端能否按表写时钟。三句都有人点头签字,法兰才算冻。点头但没有表,等于没冻。
反压也要写成拍契约。valid 拉高后 ready 迟到几拍、FIFO 几乎满时上游必须停几拍、最后一个 beat 的 last 与空拍是否允许叠在同一周期,这些都会变成综合后的多周期或假路径争论。规格里写成“流控按 AXI 习惯”不够,要写清 outstanding 上限和空拍规则。另一人应能只凭表画出波形,而不是凭习惯猜。
核心回顾
- 法兰先冻:位宽、时钟名、复位极性是合拢口,不是注释。
- 吞吐要除到拍:平均帧率必须改写成每拍数据量和缓冲深度。
- 跨域是接口:同步器与 FIFO 的位置写在表里,不写在某个人脑子里。
- 复位是时序闭包:异步进、分域释放,和扫描模式一起想。
- 端口表即 SDC 草稿:input_delay 的语义现在就要有主。
- 黄金模型保留:但必须标明时间粒度,避免无时序模型与按拍 RTL 假比对。
下一节把这份接口写成综合器认得出的 RTL,并列出仿真能过、硅上会炸的编码习惯。