3.2 负载均衡算法选型实录
3.2 负载均衡算法选型实录
本节摘要:Nginx 的 upstream 支持轮询、加权轮询、least_conn、ip_hash 等调度算法。选型是在均衡度、会话亲和与后端感知之间做取舍,本节用一次扩容实测对比各算法的真实分布。
扩容现场:三台不一样的机器
新集群是三代机器混搭:一台 16 核新机、两台 8 核老机。直接默认轮询上线,半小时后老机 CPU 90%、新机 30%——请求均匀了,负载并不均匀。这就是算法选型的起点:轮询假设后端同质,现实往往不是。
四种算法实测
# 1. 加权轮询:按能力分配 upstream backend { server 10.0.1.11:8080 weight=5; # 16核新机 server 10.0.1.12:8080 weight=3; server 10.0.1.13:8080 weight=2; } # 2. least_conn:谁闲谁接单 upstream backend_lc { least_conn; server 10.0.1.11:8080; server 10.0.1.12:8080; server 10.0.1.13:8080; } # 3. ip_hash:同 IP 恒定落同一台 upstream backend_ih { ip_hash; server 10.0.1.11:8080; server 10.0.1.12:8080; server 10.0.1.13:8080; }
一万次请求的实测分布(三台同配置 + 一台模拟慢节点):
| 算法 | 均衡度 | 慢节点表现 | 会话保持 |
|---|---|---|---|
| 轮询 | 请求均匀 | 拖垮慢节点 | 无 |
| 加权轮询 | 按权重 | 权重需手工维护 | 无 |
| least_conn | 连接均匀 | 自动少派给慢节点 | 无 |
| ip_hash | IP 均匀 ≠ 负载均匀 | 不感知 | 有 |
慢节点实验最能说明问题:模拟一台后端响应慢三倍,轮询与加权照旧派活,慢节点请求堆积;least_conn 因为它的活跃连接一直偏高,新请求自动流向其他节点。没有健康检查参与时,least_conn 是对异构与降质最鲁棒的选择。
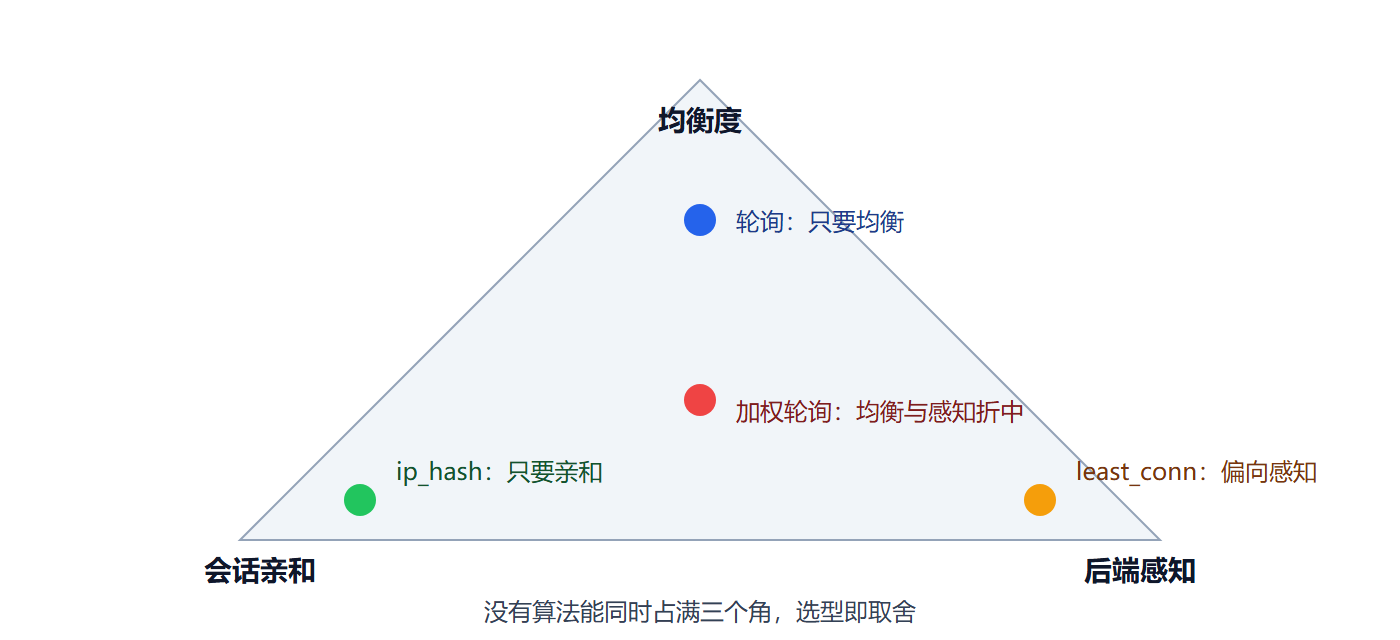
图:算法取舍三角
会话保持的正确姿势
ip_hash 的代价要认清:出口 NAT 场景下一大楼用户共享少数 IP,流量严重倾斜;后端摘一台,大量用户会话同时失效。更现代的做法是把会话搬出应用层——Session 存 Redis、登录态用 JWT,让调度器彻底无状态,轮询随便用。ip_hash 适合改造不动的历史系统。
# 备用后端:只降级不承压 upstream backend { server 10.0.1.11:8080 weight=5; server 10.0.1.12:8080 max_fails=3 fail_timeout=30s; server 10.0.1.99:8080 backup; # 全挂时才启用 }
max_fails 加 fail_timeout 是开源版的被动健康检查:30 秒内失败 3 次就摘 30 秒。它是"请求探出来的",摘除期间仍有少量请求会撞上——对失败敏感的业务要配合应用层重试。
验证分布:不要相信配置,相信日志
算法上线后分布是否符合预期,用访问日志验证而不是凭感觉。前提是 6.2 节的日志格式里有 upstream_addr 字段,然后一条命令看三台机器各接了多少:
# 提取 upstream 字段按节点计数 grep "ur=/api/items" access.log \ | awk -F'up=' '{print $2}' | awk '{print $1}' \ | sort | uniq -c | sort -rn # 期望输出(weight 5:3:2): # 5120 10.0.1.11:8080 # 3080 10.0.1.12:8080 # 2015 10.0.1.13:8080
加权轮询实测比例若明显偏离权重比,先查有没有第二个 server 块也引用了同名 upstream 但带不同参数——upstream 名字冲突时后定义的生效,这是"改了权重没反应"的头号原因。least_conn 的分布在小流量下天然不均(短时请求数少,随机性大),样本要拉长到分钟级再看。
摘除一台后的观察演练
健康检查的行为要在演练里见过,不能等真实故障时第一次见。手动把一台后端的权重改成 down,观察三件事:摘除是否即时(新请求不再进);存量连接是否被优雅处理完;摘除节点恢复(去掉 down)后流量是否回流平滑。演练命令与观察点:
server 10.0.1.13:8080 down; # 临时摘除,reload 生效
一轮演练下来会发现 passive 健康检查的边界:down 是确定性的,而 max_fails 触发的摘除有半分钟的模糊窗口。对一致性敏感的读请求,应用侧按节点做熔断比依赖网关摘除更可靠——网关保命,应用保对。
权重的维护是长期成本而非一次性设置。机器的"能力"会随负载构成漂移:同样一台 16 核机器,跑 CPU 密集接口时权重 5 合理,业务切到 IO 密集后可能 3 才对。实践中可行的做法是把权重与容量压测绑定——每次大版本上线后跑一轮单机压测,用实测吞吐比刷新权重。没有这个流程的加权,一年后基本退化成拍脑袋数字,反而是负载失衡的隐性来源。这也是我在新集群上越来越倾向 least_conn 的原因:它把"评估机器能力"这份工作交给了连接数这个天然信号,维护成本为零。
还有一个常被问到的问题:开源版要不要为了主动健康检查去买商业版或上第三方模块?我的判断标准是业务对"摘除延迟"的容忍度。passive 检查的窗口是 fail_timeout 量级(几十秒),对页面浏览类业务足够;交易类业务几十秒的失败请求意味着真金白银的订单流失,值得引入主动探测(开源生态里 nginx_upstream_check 模块或干脆换支持主动检查的入口组件)。但决策前先算另一笔账:绝大多数"后端挂了"的故障,后端自己会在秒级崩溃而非慢死,passive 的摘除速度其实够用——为小概率场景增加一个需要同步维护的模块,未必划算。
本节要点回顾
- 轮询的前提是后端同质,异构机器上加权或 least_conn;
- least_conn 对慢节点最鲁棒,无需人工调权重;
- 会话保持优先做无状态化,ip_hash 是历史系统的过渡方案;
- 被动健康检查有摘除窗口,失败敏感业务需应用层重试兜底。