5.3 多文件批量处理实战
5.3 多文件批量处理实战
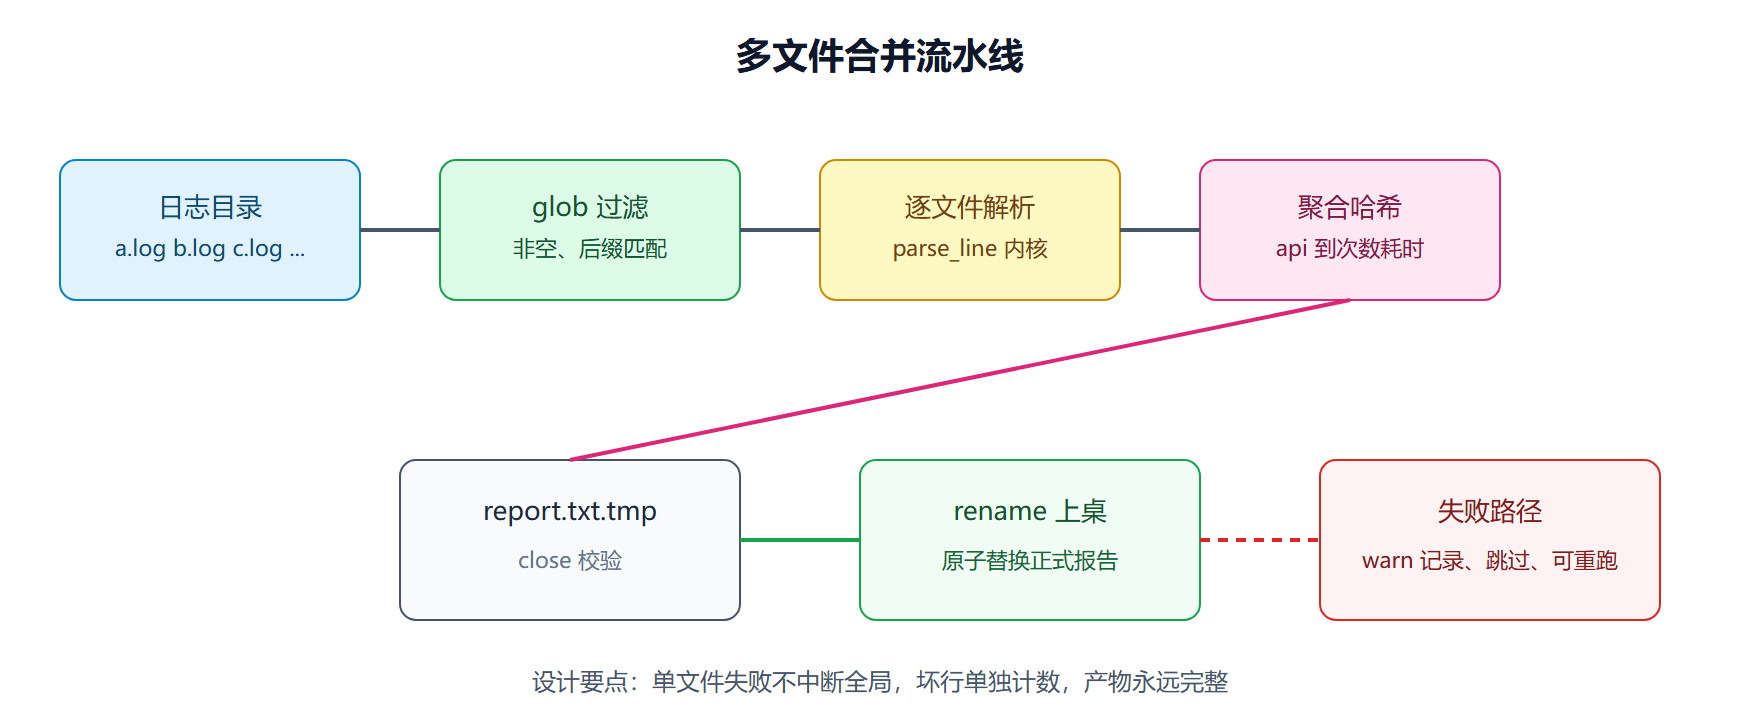
本节产出全工坊第一条完整流水线:遍历日志目录,复用第 4 章解析内核,把多个文件的统计聚进同一份哈希,最后以"写临时文件 + 原子改名"的方式产出合并报告。
完整脚本骨架
#!/usr/bin/perl use strict; use warnings; my $dir = shift or die "用法: perl merge.pl 日志目录"; my @files = sort grep { /\.log$/ && -s $_ } glob "$dir/*.log"; die "目录下没有日志文件" unless @files; my %stat; # api -> [次数, 总耗时] my %bad_lines; for my $f (@files) { open my $fh, '<', $f or do { warn "跳过 $f: $!"; next }; while (my $line = <$fh>) { my $rec = parse_line($line); # 第4章的解析内核 if ($rec) { $stat{ $rec->{api} }[0]++; $stat{ $rec->{api} }[1] += $rec->{ms}; } else { $bad_lines{$f}++; } } close $fh; } report(\%stat, \%bad_lines);
报告产出:临时文件加原子改名
sub report { my ($stat, $bad) = @_; my $final = 'report.txt'; my $tmp = "$final.tmp"; open my $out, '>', $tmp or die "写临时文件失败: $!"; printf $out "合并报告:共 %d 个接口\n\n", scalar keys %$stat; printf $out "%-40s %8s %10s\n", '接口', '次数', '平均ms'; for my $api (sort { $stat->{$b}[0] <=> $stat->{$a}[0] } keys %$stat) { my ($n, $sum) = @{ $stat->{$api} }; printf $out "%-40s %8d %10d\n", $api, $n, $sum / $n; } printf $out "\n无法解析行数:%d\n", sum(values %$bad); close $out or die "关闭失败,临时文件不可信: $!"; rename $tmp, $final or die "上桌失败: $!"; }
这套"三段式"值得背下来:先写 .tmp,close 确认成功,再 rename 上桌。中途断电、磁盘满、脚本被杀,磁盘上要么是完整旧报告、要么是完整新报告,永远不会有半份。代价是写之前要检查 close 的返回值——缓冲落盘失败往往在 close 时才暴露。
流水线全程鸟瞰
⚠️ 常见坑:多个文件的头几行可能是轮转时重复写的同一段日志,按"文件+行号"或时间戳去重再做累加,否则 Top 接口会被重复计数抬高。
去重的落地实现
坑里提到的去重不必复杂,按"时间戳 + IP + 接口"做业务主键就够轮转场景用:
my %seen; while (my $line = <$fh>) { my $rec = parse_line($line) or next; my $key = join '|', @{$rec}{qw(time ip api)}; next if $seen{$key}++; # 轮转重复行在此拦截 $stat{ $rec->{api} }[0]++; $stat{ $rec->{api} }[1] += $rec->{ms}; }
注意去重键的取舍:加入状态码与耗时会把"同一毫秒的重试"当两条记录放行——是否合理取决于统计目的,误杀重复与漏放重复之间的平衡,想清楚业务语义再定键。哈希 %seen 在千万行级别会占用可观内存,量大时换成按时间窗分桶或直接用磁盘排序去重,思路不变。
让脚本配得上 cron:进度与退出码
流水线脚本最终多半住进 cron,两个工程细节决定它能不能无人值守:一是长任务要打进度到 STDERR(不污染可能被重定向的数据流),二是退出码要能被监控判断:
my $t0 = time; for my $i (0 .. $#files) { process_one($files[$i]); printf STDERR "\r[%d/%d] %s", $i + 1, scalar @files, $files[$i] if ($i + 1) % 10 == 0; } printf STDERR "完成,耗时 %d 秒\n", time - $t0; END { $failed ? exit 1 : exit 0; # 坏行超标即非零退出,监控才能报警 }
退出码这条常被一次性脚本忽略,可一旦脚本进了定时任务,"跑完"和"跑成"必须区分——监控只认非零退出,人只认报表,两端各取所需。
断点续跑:把失败粒度压到单文件
一百个文件的批处理跑到第七十个挂了,重跑前七十个纯属浪费。给脚本加断点记忆,成本极低收益极高:
my $done_marker = "$dir/.processed"; my %done; if (open my $m, '<', $done_marker) { chomp and $done{$_} = 1 for <$m>; # 上次已完成的文件清单 } for my $f (@files) { next if $done{$f}; process_one($f); open my $m, '>>', $done_marker or die $!; print $m "$f\n"; # 完成一个记一个 close $m; } unlink $done_marker if eof_batch_all_done(); # 全部完成后清理标记
两个设计细节:标记文件用追加而非重写,进程中途被杀也不丢已完成的记录;文件路径里若含换行以外的怪字符会破坏标记格式,稳妥做法是存 basename 或给路径做摘要。配合本节的退出码与进度输出,批处理脚本就具备了生产级的三件套:可中断、可恢复、可监控——这就是"一次性脚本"与"能上 cron 的脚本"之间的全部距离。
本节要点回顾
- 先收集文件列表再逐个处理,失败可定位、可跳过
- 聚合哈希跨文件累积,这是"合并报告"的全部秘密
- 临时文件 + close 校验 + rename,产出的文件永远完整
- 坏行计数按文件分组,数据质量问题一查一个准
- 轮转重复行要去重,统计前想清楚幂等性