6.1 子查询的四个落点:SELECT、FROM、WHERE、HAVING
6.1 子查询的四个落点:SELECT、FROM、WHERE、HAVING
本节摘要:子查询是写在另一个查询内部的 SELECT,按落点不同对返回形状有硬性要求——SELECT 与比较符旁边要标量(一行一列),IN 要单列多行,FROM 里要一张"表"(多行多列且必须起别名)。相关子查询的内层引用外层列、逐行重算,是优雅与性能危险的结合体。本节用同一组业务问题把四个落点全部走一遍。
查询里再套一个查询
业务问题:"哪些书的价格高于全店平均价?"条件里的"全店平均价"本身就是一个查询的答案,于是答案里套答案:
-- WHERE 落点:标量子查询参与比较 SELECT title, price FROM books WHERE price > (SELECT AVG(price) FROM books);
+-----------------------+----------+ | title | price | +-----------------------+----------+ | 数据库系统概念 | 89.00 | | 算法导论 | 128.00 | +-----------------------+----------+ 2 rows in set (0.02 sec)
括号里的 SELECT 先独立执行,算出一个数(约 72.67),外层查询拿着这个数逐行比较。标量子查询(返回一行一列)是唯一能直接放在比较符旁边的形状——它扮演的就是一个值。若子查询意外返回两行,数据库立刻报错:
-- 形状违规:比较符旁边放了多行子查询 SELECT title FROM books WHERE price > (SELECT price FROM books WHERE category_id = 2);
ERROR 1242 (21000): Subquery returns more than 1 row
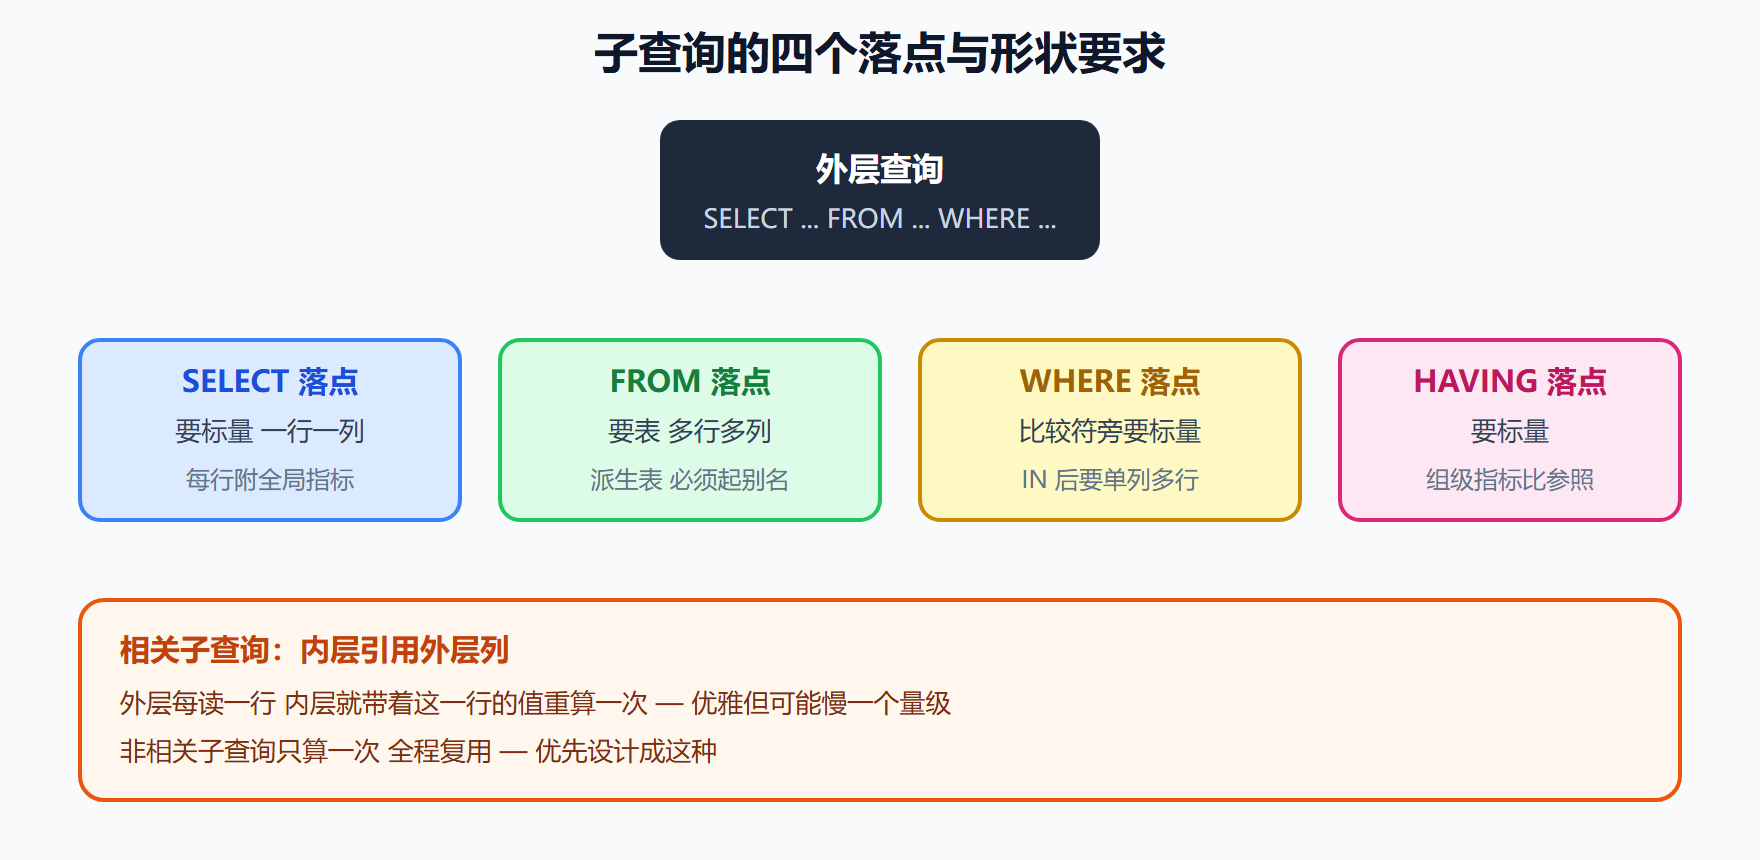
两个书的价格都回来了,比较符不知道该跟谁比。这个报错是子查询世界的第一课:先想清楚形状,再决定落点。四落点的形状要求一张表说尽:
| 落点 | 写法形态 | 要求形状 | 典型用途 |
|---|---|---|---|
| SELECT 列表 | SELECT 列, (子查询) | 标量 | 每行附带一个全局指标 |
| WHERE 比较符旁 | WHERE 列 > (子查询) | 标量 | 高于平均/最大值 |
| WHERE IN 后 | WHERE 列 IN (子查询) | 单列多行 | 属于某集合 |
| FROM 子句 | FROM (子查询) AS t | 多行多列,必须起别名 | 先加工再查,派生表 |
SELECT 落点:每行带一个参照值
报表里常见"每本书价格 + 全店平均价"同屏,标量子查询放在 SELECT 列表里,外层每行都会执行一次取值:
-- SELECT 落点:给每行附上全店均价做参照 SELECT title, price, ROUND((SELECT AVG(price) FROM books), 2) AS 全店均价, ROUND(price - (SELECT AVG(price) FROM books), 2) AS 高出均价 FROM books ORDER BY price DESC LIMIT 3;
+-----------------------+----------+--------------+--------------+ | title | price | 全店均价 | 高出均价 | +-----------------------+----------+--------------+--------------+ | 算法导论 | 128.00 | 72.67 | 55.33 | | 数据库系统概念 | 89.00 | 72.67 | 16.33 | | 计算机网络 | 79.00 | 72.67 | 6.33 | +-----------------------+----------+--------------+--------------+
写法成立,但同一句子查询写两遍已经露出坏味道——第 7 章窗口函数的 AVG OVER 能一行写完这个需求且只算一次,第 8 章的 CTE 也能把均价先算成一个名字。子查询不是唯一解时,可读性与执行次数就是选型依据。
FROM 落点:派生表,先加工再查询
第 4 章的悬案在此结案:"各分类销售额的平均值"要先分组求和、再对结果求平均。把第一步的结果当表用,就是派生表:
-- FROM 落点:先聚合出每分类总额 再求这些总额的平均 SELECT ROUND(AVG(cat_sales.销售额), 2) AS 分类平均销售额 FROM ( SELECT b.category_id, SUM(oi.quantity * oi.unit_price) AS 销售额 FROM order_items oi JOIN books b ON b.id = oi.book_id GROUP BY b.category_id ) AS cat_sales; -- 派生表必须起别名 否则直接报错
+--------------------------+ | 分类平均销售额 | +--------------------------+ | 288.50 | +--------------------------+
派生表的心智模型:内层查询跑完,结果是一张临时表,外层对这张表正常查询。它能彻底解耦"加工"与"使用"两步,代价是嵌套的括号层级——内层再套一层时,可读性急剧下滑,这正是第 8 章 WITH 子句要拯救的场景。HAVING 落点则少而精:聚合结果当筛选值用。
-- HAVING 落点:组的指标与另一个查询的结果比 SELECT category_id, ROUND(AVG(price), 2) AS 平均价 FROM books GROUP BY category_id HAVING AVG(price) > (SELECT AVG(price) FROM books);
+-------------+-----------+ | category_id | 平均价 | +-------------+-----------+ | 3 | 82.33 | +-------------+-----------+
图 6-1 子查询落点地图
相关子查询:内外层的传话筒
前文的子查询都是非相关的——内层与外层无关,算一次、处处用。相关子查询的内层引用了外层的列,外层每行都触发一次内层计算。经典应用"每分类价格最高的书":
-- 相关子查询:内层的 c.id 来自外层当前行 SELECT b1.title, b1.category_id, b1.price FROM books b1 WHERE b1.price = ( SELECT MAX(b2.price) FROM books b2 WHERE b2.category_id = b1.category_id -- 传话筒:引用外层的 b1 );
+-----------------------+-------------+----------+ | title | category_id | price | +-----------------------+-------------+----------+ | 数据库系统概念 | 2 | 89.00 | | 算法导论 | 3 | 128.00 | | 操作系统导论 | 5 | 39.00 | +-----------------------+-------------+----------+
执行画面:外层扫到《数据库系统概念》时,把它的 category_id=2 传给内层,内层只对分类 2 求 MAX;扫到下一行再传下一个分类号。分类有多少个值,内层就重算多少次。小表无感,大表上相关子查询的执行次数是外层行数级别的——第 7 章的窗口函数(ROW_NUMBER 取每组第一)与第 8 章的 CTE 都是这个写法的接班人,面试时三者的对照也是高频题。
⚠️ 常见坑:派生表忘了起别名(MySQL 直接报错 EVERY derived table must have an alias);标量子查询实际返回多行(数据一变就炸,测试时恰好多半只有一行)。上线前给子查询单独跑一遍、确认行数,是最便宜的自检。
💡 关键直觉:写子查询前先画两栏——左栏外层每一行需要什么,右栏内层能提供什么形状。两栏对得上再动笔,形状不匹配的报错全都源于没画这两栏。
本节要点回顾
- 形状决定落点:标量配比较符与 SELECT 列表,单列多行配 IN,多行多列配 FROM(必起别名);
- 派生表解耦加工与使用:聚合的聚合必须靠它分两步,代价是括号嵌套;
- 相关子查询逐行重算:内层引用外层列是标志,优雅但行数级执行次数,大表慎用;
- 非相关子查询只算一次:设计时优先让内层独立于外层;
- 同一指标写两遍就是坏味道:窗口函数与 CTE 是子查询的两个接班方向,第 7、8 章逐一登场。