3.2 CASE 表达式:查询里的分支逻辑
3.2 CASE 表达式:查询里的分支逻辑
本节摘要:CASE 是 SQL 里唯一的条件分支结构,两种写法——搜索式按条件逐个判断、简单式按一个表达式对号入座。它能在 SELECT 里打标签、在分档里划区间、在聚合函数里实现条件计数与条件求和,还能配合聚合完成行列转换的雏形。写好 CASE 的关键是理解它是一个"表达式":凡能放值的地方都能放它。
从定价分档需求说起
运营想看每本书的价格档位:"50 元以下算低价,50 到 100 算中价,100 以上算高价"。表里没有这一列,应用层循环打标又慢又割裂。CASE 表达式正是为此而生——在查询执行的瞬间,按行计算出一个新值:
-- 搜索式 CASE:条件从上到下依次判断,命中即返回,不再往下看 SELECT title, price, CASE WHEN price < 50 THEN '低价' WHEN price < 100 THEN '中价' ELSE '高价' END AS price_band FROM books;
+-----------------------+----------+------------+ | title | price | price_band | +-----------------------+----------+------------+ | 数据库系统概念 | 89.00 | 中价 | | SQL必知必会 | 52.00 | 中价 | | 算法导论 | 128.00 | 高价 | | 计算机网络 | 79.00 | 中价 | +-----------------------+------------+ ------------+ (《操作系统导论》39.00 显示 低价)
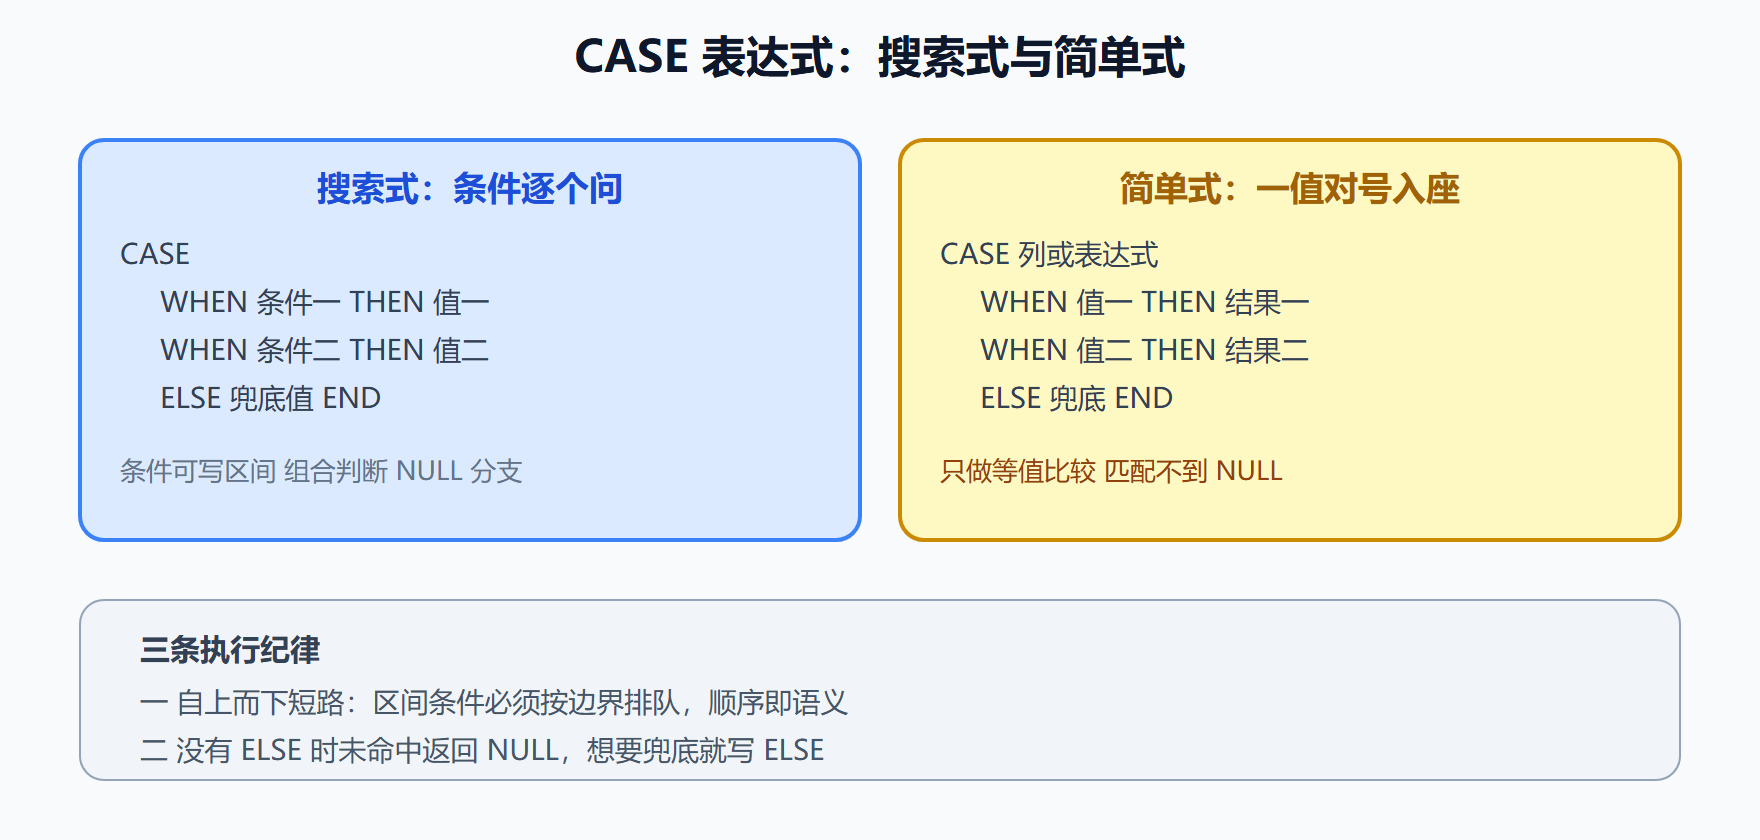
两个语法要点立刻浮出来。其一,条件自上而下短路:price 为 89 时命中第二个 WHEN 前先被第一个 WHEN 判过(89 < 50 为假),轮到 89 < 100 为真即返回"中价",后面的 ELSE 根本不看。区间条件因此必须按边界从小到大(或从大到小)排队,顺序就是语义。其二,CASE 以 END 收尾、整体是一个表达式:它产出一个值,可以起别名、可以参与运算、可以嵌进函数——"凡能放值的地方都能放 CASE"是记住它的口诀。
第二种写法是简单式 CASE,适合"一个表达式对号入座"的场景,比如把订单状态码翻译成中文:
-- 简单式 CASE:拿 status 与每个 WHEN 后的值做等值比较 SELECT id, status, CASE status WHEN 'paid' THEN '已支付' WHEN 'shipped' THEN '已发货' WHEN 'completed' THEN '已完成' ELSE '其他' END AS 状态中文 FROM orders LIMIT 4;
+-----+-----------+--------------+ | id | status | 状态中文 | +-----+-----------+--------------+ | 101 | paid | 已支付 | | 102 | shipped | 已发货 | | 103 | completed | 已完成 | | 104 | paid | 已支付 | +-----+-----------+--------------+
两种式子的选择标准一句话:比较对象是"区间或复杂条件"用搜索式,是"一个值的多个等值分支"用简单式。简单式做的是等值比较,前一章讲过 NULL = 任何值都得未知,所以简单式 CASE 匹配不到 NULL——想给 NULL 分支,仍要回到搜索式的 WHEN status IS NULL。
图 3-2 CASE 两种形态与执行要点
ELSE 的缺席与两个经典坑
省略 ELSE 时,所有 WHEN 都未命中的行会得到 NULL——不是空字符串,是货真价实的未知。报表里莫名出现的空白格,多半是 CASE 忘写 ELSE。反过来,写 ELSE 也要留心一个更隐蔽的坑:
-- 坑一:区间边界写重叠,靠短路侥幸正确——顺序一换就翻车 CASE WHEN price < 100 THEN '非高价' WHEN price < 50 THEN '低价' -- 永远轮不到:低价必然先命中上一条 ELSE '高价' END
-- 坑二:THEN 分支类型不一致,隐式转换悄悄发生 CASE WHEN stock < 10 THEN '紧急' ELSE 0 END -- 字符串与数字混用,0 会被转成文本 '0'
两条语句都能执行成功;坑一在调整 WHEN 顺序后档位错乱 坑二的结果列类型被统一成字符,参与数值运算时再度隐式转换
第一条的教训:区间条件的顺序就是语义的一部分,重叠边界必须依赖短路才"碰巧"正确,属于高危写法;把区间写成不重叠的递进序列才稳。第二条的教训:THEN 各分支应保持同类型,混类型时数据库会找公共类型做隐式转换,转换发生在哪一行、转成什么,都脱离了你的视线。
CASE 的三个高阶舞台
舞台一:条件聚合。 CASE 嵌进聚合函数,实现"一个 GROUP BY 出多路统计"。数每个分类下高价书与低价书各几本:
-- SUM 加 CASE:条件求和;COUNT 加 CASE:条件计数 SELECT category_id, COUNT(*) AS 总书数, SUM(CASE WHEN price >= 100 THEN 1 ELSE 0 END) AS 高价书数, SUM(CASE WHEN price < 50 THEN 1 ELSE 0 END) AS 低价书数 FROM books GROUP BY category_id;
+-------------+-----------+--------------+--------------+ | category_id | 总书数 | 高价书数 | 低价书数 | +-------------+-----------+--------------+--------------+ | 2 | 2 | 0 | 1 | | 3 | 3 | 2 | 0 | +-------------+-----------+--------------+--------------+
SUM(CASE WHEN ... THEN 1 ELSE 0 END) 的原理:每行命中条件贡献 1、否则贡献 0,求和即计数。这个惯用法是面试与实战的双料常客,第 4 章聚合、第 8 章 CTE 重构里都会反复出现。
舞台二:ORDER BY 定制排序。 想让"紧急补货"(库存小于 10)排最前,其余按价格降序:
-- CASE 出现在 ORDER BY:先按紧急程度 再按价格 SELECT title, stock, price FROM books ORDER BY CASE WHEN stock < 10 THEN 0 ELSE 1 END, -- 紧急的排前 price DESC;
+-----------------------+-------+----------+ | title | stock | price | +-----------------------+-------+----------+ | 算法导论 | 8 | 128.00 | | 操作系统导论 | 6 | 39.00 | | 数据库系统概念 | 12 | 89.00 | | SQL必知必会 | 35 | 52.00 | +-----------------------+-------+----------+
文本状态列没有自然顺序('paid'、'shipped' 按字典序毫无业务含义),CASE 把业务顺序翻译成数字顺序,是状态列排序的标准解法。
舞台三:WHERE 之外再谈分支。 CASE 不能替代 WHERE 的过滤职能,但能在 UPDATE 里做分档处理(第 2 章补货案例已见过),也能在窗口函数里做分段统计(第 7 章预告)。它像电路里的多路开关:装在哪里,哪里的行为就按行定制。
⚠️ 常见坑:把 CASE WHEN 的条件写成互相重叠又乱序的区间,测试数据一换结果就变。自查方法:把所有 WHEN 条件抄在纸上,检查任意一行数据只会命中一个分支,或按短路顺序命中的分支恰是你想要的。
💡 关键直觉:CASE 是表达式不是语句。它不"执行流程",只"算出一个值"。带着这个认知,你会自然把它嵌进 SELECT、聚合、ORDER BY、UPDATE 的任何位置,而不是纠结"SQL 里怎么写 if-else"。
本节要点回顾
- 搜索式管区间与复杂条件,简单式管等值对号入座;简单式匹配不到 NULL,NULL 分支要用搜索式的 IS NULL;
- 自上而下短路:区间条件按边界排队,顺序即语义;重叠区间靠短路侥幸正确属高危写法;
- 省略 ELSE 得 NULL:报表空格的常见来源;THEN 分支保持同类型,防隐式转换脱离视线;
- 条件聚合是第一惯用法:SUM(CASE WHEN ... THEN 1 ELSE 0 END) 实现一路分组多路统计;
- CASE 可入 ORDER BY:把业务顺序翻译成数字顺序,状态列排序的标准解;
- CASE 是表达式:凡能放值的地方都能放它,这条口诀贯穿第 4 到第 8 章。
单表表达力至此补齐。下一章视角抬升:聚合函数把成百上千行折叠成一个数,GROUP BY 决定折叠的颗粒度——SQL 思维的第一次跃迁开始了。