6.3 UNION 家族:结果集的纵向拼接
6.3 UNION 家族:结果集的纵向拼接
本节摘要:JOIN 把列横向拼宽,UNION 把行纵向摞高。UNION 会去重(隐式排序,代价不小),UNION ALL 原样拼接(快,但不去重);INTERSECT 取交集、EXCEPT 取差集,MySQL 8 尚未原生支持、需用 IN/EXISTS 改写。参与拼接的各查询必须列数相同、类型相容,排序要写在最外层。本节把这些规则连同典型场景一次讲完。
把两张表上下拼起来
书店要出一张"会员名录":正式顾客与注册未消费的访客分别存在两张结构相似的表里,报表要合在一起看。纵向拼接登场:
-- UNION:上下拼接两个查询的结果 自动去重 SELECT name, city, '正式顾客' AS 身份 FROM customers UNION SELECT name, city, '访客' AS 身份 FROM guest_users;
+--------+--------+--------------+ | name | city | 身份 | +--------+--------+--------------+ | 陈晓 | 杭州 | 正式顾客 | | 林川 | 北京 | 正式顾客 | | 周芸 | 上海 | 访客 | +--------+--------+--------------+
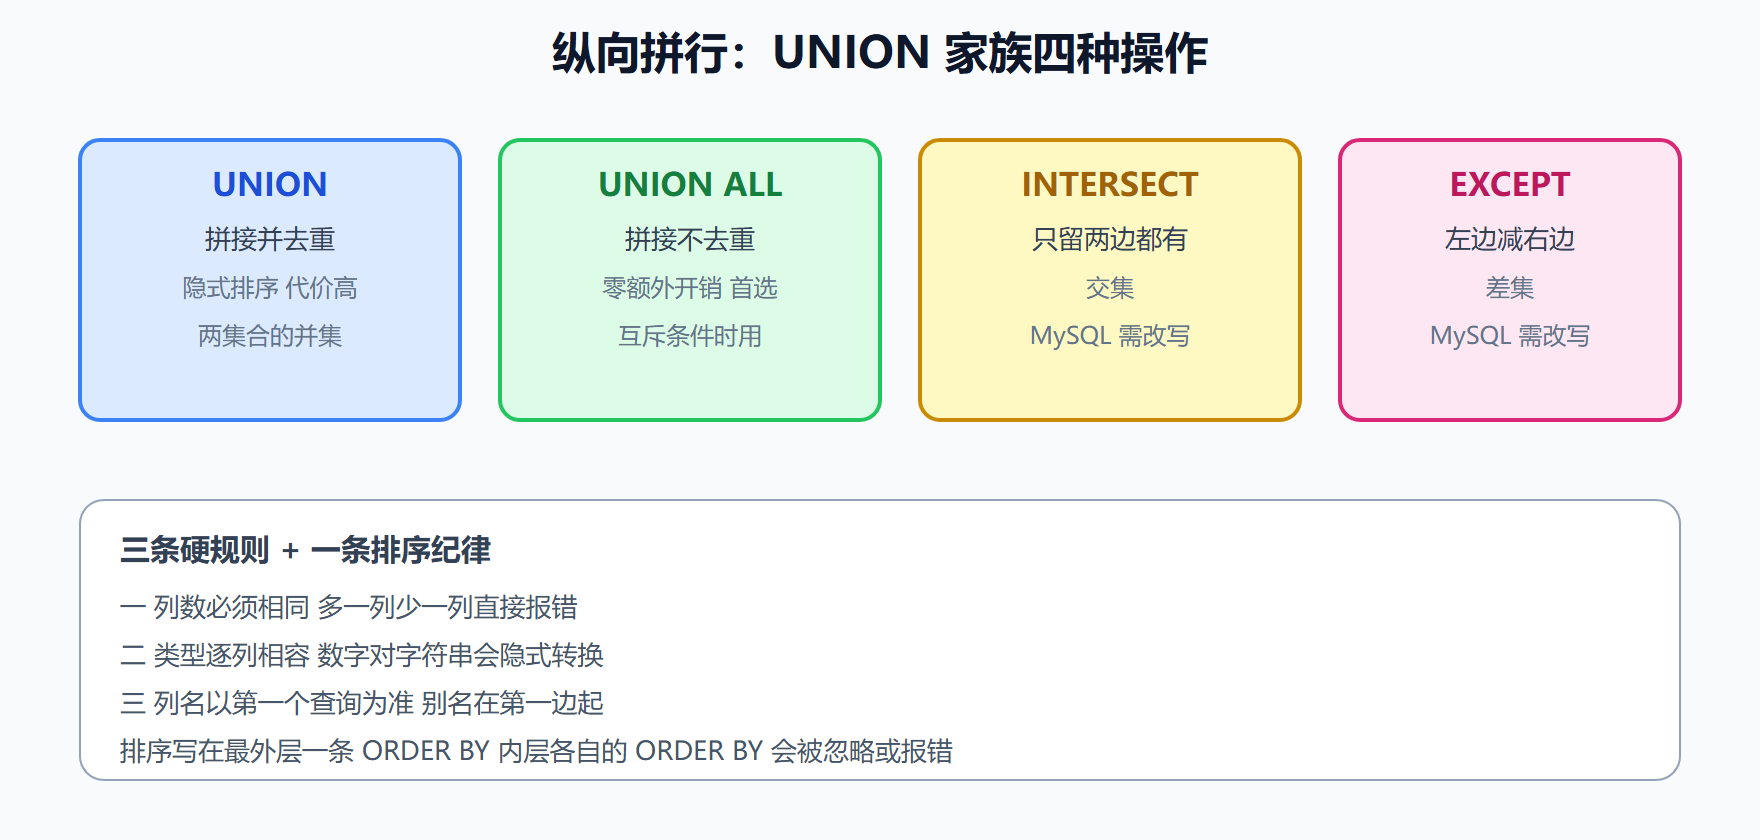
三条硬规则从这条语句里直接读出来。规则一,列数必须相同:两边的 SELECT 列表一个多一列少都直接报错。规则二,类型逐列相容:第一列是字符串,另一边第一列是数字,会走隐式转换(第 3 章 CASE 的坑在这里重演)。规则三,列名取自第一个查询:第二边写得再花哨,列名以第一边为准——所以第一边的别名要起好。
真正影响行为与性能的是 UNION 与 UNION ALL 的一字之差:
-- UNION ALL:原样拼接 不去重 SELECT name, city FROM customers WHERE city = '杭州' UNION ALL SELECT name, city FROM customers WHERE city = '北京';
+--------+--------+ | name | city | +--------+--------+ | 陈晓 | 杭州 | | 林川 | 北京 | | 陈晓 | 杭州 | ← 同一人两次下单被收进两行 ALL 保留了重复 +--------+--------+
UNION 的去重不是免费的:数据库要把拼接结果整体排序(或哈希)才能发现重复,大结果集上代价显著;UNION ALL 纯拼接、零额外开销。确知不可能重复(比如两边已按互斥条件过滤),或者业务就要保留重复,一律 UNION ALL——这是写进很多团队规范的性能条款。反过来,想验证"两个口径是否统计了同一批行",UNION 前后行数之差就是重复量,去重有时也是诊断工具。
图 6-3 UNION 家族行为一览
排序的位置与括号的误区
拼接结果要按城市排序,ORDER BY 只能写在整个 UNION 的最外层、只写一次:
-- 正确:唯一的 ORDER BY 站在队尾 管辖整个拼接结果 SELECT name, city FROM customers UNION ALL SELECT name, city FROM guest_users ORDER BY city; -- 只允许这一处
+--------+--------+ | name | city | +--------+--------+ | 林川 | 北京 | | 陈晓 | 杭州 | | 周芸 | 上海 | +--------+--------+
若在 UNION 的某一支里单独写 ORDER BY,多数数据库直接报错(MySQL 里括号包裹的子查询内排序会被保留,但那是派生表语义,不是"这一支先排好")。另一个常见误区是想用括号控制拼接顺序:UNION 家族不保证输出顺序,任何依赖"第二支一定接在第一支后面"的代码都是赌运气——顺序必须由 ORDER BY 明说,这条纪律与第 1 章"行无内在顺序"一脉相承。
EXCEPT 与 INTERSECT 在 PostgreSQL、SQL Server 里开箱即用;MySQL 8 里的等价改写用上一节的武器就能拼出来:
-- MySQL 改写 INTERSECT:AND 双 IN SELECT name FROM customers WHERE id IN (SELECT customer_id FROM orders WHERE amount > 100) AND id IN (SELECT customer_id FROM orders WHERE amount < 50); -- MySQL 改写 EXCEPT:NOT IN(记得 IS NOT NULL) SELECT name FROM customers WHERE id NOT IN ( SELECT customer_id FROM orders WHERE customer_id IS NOT NULL AND amount > 100 );
改写输出与原生 INTERSECT / EXCEPT 一致 差别只在可读性:原生语法一眼看出集合语义 改写版要读条件
场景实战:多口径合并报表
UNION 最能发挥的场景是"多个互斥口径合并成一张表"。需求:给管理层看一张"书是畅销、常销还是滞销"的三段表,各段独立统计、拼在一起:
-- 三段互斥口径 用 UNION ALL 合并 身份列标记来源 SELECT title, SUM(quantity) AS 销量, '畅销 榜前十' AS 档位 FROM 销售明细 WHERE title IN (SELECT title FROM 畅销榜 LIMIT 10) GROUP BY title UNION ALL SELECT title, SUM(quantity), '常销 月均稳定' FROM 销售明细 WHERE title NOT IN (SELECT title FROM 畅销榜 LIMIT 10) AND 月销量 BETWEEN 10 AND 100 GROUP BY title UNION ALL SELECT title, SUM(quantity), '滞销 待清仓' FROM 销售明细 WHERE 月销量 < 10 GROUP BY title ORDER BY 档位, 销量 DESC;
+-----------------------+--------+----------------+ | title | 销量 | 档位 | +-----------------------+--------+----------------+ | 算法导论 | 142 | 畅销 榜前十 | | SQL必知必会 | 118 | 畅销 榜前十 | | 计算机网络 | 43 | 常销 月均稳定 | | 操作系统导论 | 2 | 滞销 待清仓 | +-----------------------+--------+----------------+
这个模式的两处巧劲:身份列(CASE 或字面量)让拼接后的每行带着来源标签,一张表三个口径;互斥条件保证无重复,所以敢用 UNION ALL 而不付去重税。等价方案是 GROUP BY 加 CASE 一次查出(第 4 章的条件聚合),两种写法怎么选?口径简单用条件聚合,口径复杂到每段各有 WHERE 与聚合逻辑时,UNION ALL 反而更清楚——每段独立成句,改哪段都不牵动别人。
⚠️ 常见坑:UNION 两边列序错位——第一个查询 (name, city)、第二个写成 (city, name),列数相同不报错,数据却整列错位。自查法:两边的 SELECT 列表上下对齐逐列比对类型与语义,"能跑"不等于"对位"。
💡 关键直觉:JOIN 是横着拼宽(列变多),UNION 是纵着摞高(行变多)。分析需求时先问"要更多列还是更多行",横纵一定,写法就定了。
本节要点回顾
- UNION 去重要付税,UNION ALL 快而保真:互斥口径或确知无重复时一律 ALL;
- 三硬规则:列数相同、类型逐列相容、列名以第一边为准;
- ORDER BY 只写最外层一次:拼接顺序无保证,顺序必须显式声明;
- INTERSECT 与 EXCEPT:集合语义原生最清晰,MySQL 用 IN/NOT IN(加 IS NOT NULL)改写;
- 身份列加互斥条件是合并多口径报表的标准模式,与条件聚合互为备选;
- 横拼竖摞一口诀:JOIN 拼列、UNION 摞行,需求先定方向再选武器。
查询的所有"组合手段"到此齐备。下一章进入全书主峰:窗口函数——它让"聚合值与明细行同屏"成为可能,GROUP BY 留下的遗憾正式开始偿还。