5.3 TCP拥塞控制与流量控制实战
5.3 TCP拥塞控制与流量控制实战
本节摘要:流量控制用滑动窗口保护接收方不被淹没,拥塞控制用慢启动、拥塞避免、快恢复保护网络不陷入崩溃,实际发送速率取两者窗口的较小值。本节讲透两套窗口的分工与四个拥塞阶段的算法逻辑,并用一次跨洋传输"跑不满带宽"的真实案例演示诊断与调优全过程。
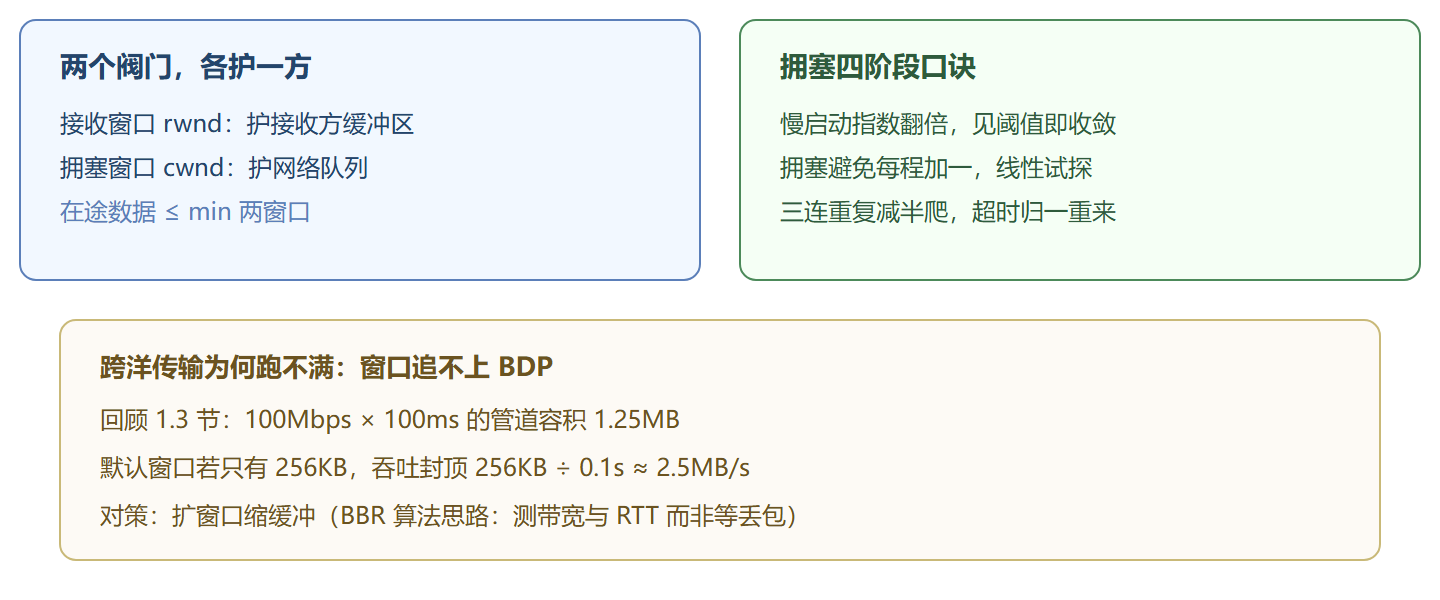
上一节建立了可靠性,这一节解决"多快发"。TCP 发送速率受两个阀门约束:接收窗口(rwnd,对方缓冲区多大)与拥塞窗口(cwnd,网络此刻能吃多少),实际在途数据不超过两者的较小值。两个窗口保护不同对象——一个护接收方,一个护网络。
一、流量控制:别撑死接收方
接收方在每个 TCP 首部里通告自己的剩余缓冲区(窗口字段),发送方保证未确认数据不超过这个值。接收方来不及消费时把窗口通告缩小甚至降为零,发送方暂停;消费完再广播新窗口,传输恢复。
滑动窗口简化推演(接收窗口 400,每次传 100): 发送方视角 [已确认 200] [在途 300] [禁止发送...] 窗口左沿:随确认前移 窗口右沿:由对方通告决定 对方通告 win=100(缓冲被应用消费慢了)→ 在途上限立即缩到 100 对方通告 win=0 → 完全停发,但会周期性发"窗口探测"包—— 否则对方腾出空间后发的"窗口更新"若丢了,双方互等成死锁 糊涂窗口综合征:接收方每次只腾出 10 字节就通告, 发送方就只发 10 字节的小包——带宽全浪费在 40 字节的 头部上。对策:接收方攒到足够大再通告(延迟通告), 发送方凑满 MSS 或对端一半窗口再发(Nagle 算法)。
二、拥塞控制:别堵死网络
接收窗口管的是终点,拥塞窗口管的是路途。路由器队列溢出导致的丢包,就是网络在喊"受不了了"。TCP 的拥塞控制是一套"加性增、乘性减"的分布式共识:每个流主动探测上限、遇拥塞立刻让路。四个阶段:
cwnd 随时间演化的四个阶段(ssthresh 为阈值): cwnd ▲ 慢启动(指数) 拥塞避免(线性) 超时:cwnd 归 1 重来 │ ╱ ╱‾\ 快恢复 │ ╱ ╱ ╲__╱‾╲__(锯齿) │ ╱ ╱ 快恢复后线性爬升 │ ╱ ╱ │ ╱ ←── ssthresh ──╱ └──────────────────────────────────────► 时间 1. 慢启动:从 1 MSS 起,每收到确认 cwnd 加 1 —— 效果是 每 RTT 翻倍(1→2→4→8…),指数增长直到 ssthresh。 "慢"指起点低,不是涨得慢。 2. 拥塞避免:过阈值后每 RTT 只加 1 MSS,线性试探。 3. 快恢复:三个重复确认触发快速重传(见 5.2)时, 判定"轻度拥塞":ssthresh 减半、cwnd 降到新阈值, 直接线性爬升(不归 1)。 4. 超时:RTO 到点说明"重度拥塞":ssthresh 减半、 cwnd 归 1,从慢启动重来。
为什么丢包要减半而不是微调?互联网没有拥塞席位告示,丢包是唯一的信号;乘性减保证所有流同时让路时总量骤降、队列迅速排空——这套 1988 年定下的机制(Jacobson 算法)被认为是互联网几次从拥塞崩溃边缘自救的关键。
图:两个阀门与四阶段曲线
三、实战:一次跨洋备份"跑不满"的完整诊断
背景:公司 nightly 把 200GB 备份传到海外节点,专线 1 Gbps、RTT 110ms,实测只有 3 MB/s(约 24 Mbps),夜班时间不够用。
第 1 步:确认不是带宽问题 $ iperf3 -c 海外节点 -t 10 → 单流 24 Mbps $ iperf3 -c 海外节点 -t 10 -P 8 → 8 并行流合计 620 Mbps 解读:并行能跑起来说明物理带宽充足, 单流被某种"每流上限"卡住——高度怀疑窗口。 第 2 步:算理论封顶 BDP = 10^9 bit/s × 0.11 s ≈ 13.75 MB 单流要打满 1Gbps,在途窗口必须 ≥ 13.75MB。 传统 TCP 首部窗口字段只有 16 位,最多标 64KB, 必须靠"窗口缩放因子"(握手时协商的移位选项)放大。 实测 3MB/s × 0.11s ≈ 330KB 在途 → 窗口被压在数百 KB。 第 3 步:定位是谁压的 发送端 sysctl 查:窗口缩放已开、缓冲上限 6MB → 不是瓶颈 中间路径丢包率 0.3% → 每次丢包触发减半, 锯齿峰值永远爬不满 BPD(见上图右半) 接收端 netstat -s:重传统计每小时数万次 → 证实 第 4 步:处置与结果 - 发送端换用 BBR 拥塞算法(基于带宽与 RTT 建模, 不靠丢包信号,锯齿大幅变平) - 接收端 TCP 缓冲上限调大到 32MB - 复测单流:210 Mbps(提升 9 倍),配合 4 并行流 打到 780 Mbps,夜班窗口从 18 小时缩到 1 小时内。 变式:同样跑不满的另两种常见病因—— 接收窗口太小(应用读得慢,rwnd 卡死)与中间设备 随机丢包非拥塞性丢包(无线链路),处置完全不同: 前者调接收端,后者换链路或上纠错。先归因,再动手。
💡 关键直觉:TCP 吞吐 ≈ 窗口 ÷ RTT。看到"带宽充足却跑不快",先背这个公式:要么窗口被谁压住(缓冲、算法),要么 RTT 太大(物理距离,靠就近部署解),要么丢包把锯齿削平。三个 suspects,逐一过堂。
常见疑问
Nagle 算法与延迟确认为什么"打架"? Nagle 让发送方攒大包再发(省头部),延迟确认让接收方攒一会再回 ACK(省包)。两者相遇时:发送方在等"攒够",接收方在等"攒够确认",互相等待最多 40~200 毫秒——低延迟场景(游戏、远程桌面)的经典延迟毛刺来源,解法是按需关闭 Nagle 或改用长连接上的批量协议。
多路 TCP 流之间会互相抢带宽吗? 会,而且 AIMD 保证了"人人平等":两条流同瓶颈竞争时趋近于各占一半(振荡收敛)。想给关键流让路,需要在队列上做区分(QoS 加权),那是网络层与设备侧的功课,不是 TCP 自己能解决的。
本节要点回顾
- 双窗口分工:rwnd 护接收方、cwnd 护网络,实际取小者
- 滑动窗口:确认推进左沿、通告决定右沿;零窗口要靠探测包防死锁
- 四阶段:慢启动指数、拥塞避免线性、快恢复减半爬、超时归一
- AIMD 精神:加性增乘性减,没有中央调度的全局共识
- 吞吐公式:窗口除以 RTT,跨洋跑不满先查窗口与丢包,再怀疑带宽
- BBR 思路:主动测带宽与 RTT 建模,替代被动等丢包
传输层到站。进程间的可靠对话已然成立,下一站回到旅程起点那一行 HTTP 文本——看应用层的语言。