6.3 数值结果排错手册
6.3 数值结果排错手册
本节摘要:症状驱动的数值排错速查手册:NaN 与 inf 的溯源路径、结果对扰动异常敏感的诊断、两条"等价"代码路径结果不一致的排查、迭代法不收敛的路由决策,以及一份十步标准排错流程。每条症状都索引回前五章的对应案件。
一、症状一:结果出现 NaN 或 inf
溯源路线:NaN 的特点是传染性——出现的那一刻是根因,之后全是污染。用 NumPy 定位第一现场:
import numpy as np def find_first_nan(arrays, names): for name, a in zip(names, arrays): idx = np.argwhere(np.isnan(a)) if idx.size: print(f"{name}: 首个 NaN 在索引 {idx[0]}") # 检查该位置的输入:除零?负数开方?inf 相减?0 乘 inf? return None # 高频根因清单(按出现频率排序): # 1. 对数域误用:np.log(0) 或 log(负数)——检查数据边界与预处理 # 2. 除以趋零分母:牛顿法导数消失(3.1节)、未加保护的比例计算 # 3. 上溢链条:exp(1000) 变 inf,再参与减法得 nan(1.1节)——改对数域 # 4. 梯度爆炸后的累积污染:深度网络里 loss 变 nan 后回传全灭
修复优先级:先在数据入口加断言(np.isfinite(x).all()),让事故在现场报警而不是在下游发臭;再对根因选药——对数域、裁剪、epsilon 保护(x / (y + 1e-12),注意这是权宜之计而非解法)。
二、症状二:结果对扰动异常敏感
用户主诉"参数改 1e-15,结果变 30%"。诊断流程:
import numpy as np def perturbation_test(solver, data, rel_eps=1e-13): base = solver(data) rng = np.random.default_rng(0) perturbed = [] for _ in range(10): d = data * (1 + rel_eps * rng.standard_normal(data.shape)) perturbed.append(solver(d)) spread = np.std(perturbed, axis=0) / (np.abs(base) + 1e-300) return base, spread # base, spread = perturbation_test(my_solver, A) # spread 若达 0.1 以上:问题病态(1.2节),换算法无用, # 处置 = 重构问题:换尺度 / 正则化 / 换变量 # spread 若在 eps 量级但结果仍不对:算法层问题,继续往下查
这个扰动实验是 1.2 节"责任认定流程"的机器化版本——先定性再动手,是排错手册的第一原则。线性系统里它对应条件数检查(第二章),回归问题里对应设计矩阵共线诊断。
三、症状三:两条等价路径结果不一致
"同一个数学公式,向量化版本和循环版本差 1e-6"——排除 bug 后大概率是合法差异:
| 差异来源 | 典型幅度 | 判据 |
|---|---|---|
| 求和顺序(1.2/6.1节) | 1e-13 到 1e-10 | 用 math.fsum 仲裁,收敛到同一值即合法 |
| 截断项不同(4.1节) | 1e-6 到 1e-4 | 两种自适应策略停在不同点,都含各自误差估计 |
| 并行归约顺序不定 | 1e-13 到 1e-11 | 归约顺序未定,固定分块或接受波动区间 |
| dtype 混用(6.1节) | 1e-7(float32 混入) | 检查中间数组 dtype,32 位混入是静默精度杀手 |
裁决标准:差异是否可以用"已知的误差机理"解释到量级。解释得通就写进报告的误差清单;解释不通(差 1e-2 或符号相反)就按真 bug 追查——先查 dtype,再查求和顺序,再查是否有不对称的边界处理。
四、症状四:迭代不收敛
路由决策树(对应第三、四章案件):
配套的机器化诊断——记录残差历史并分类:
import numpy as np def diagnose_convergence(residuals): r = np.asarray(residuals) last, prev = r[-1], r[len(r)//2] if not np.isfinite(r).all(): return "发散到 inf/nan:检查步长与除零" if prev / (last + 1e-300) < 2: return "停滞:平坦区 / 循环 / 病态慢收敛" if last > prev: return "后期回升:步长过大或病态震荡" rate = (r[-2] / (r[-1] + 1e-300)) return f"健康收敛,近期收缩因子约 {rate:.2f}(线性速率)"
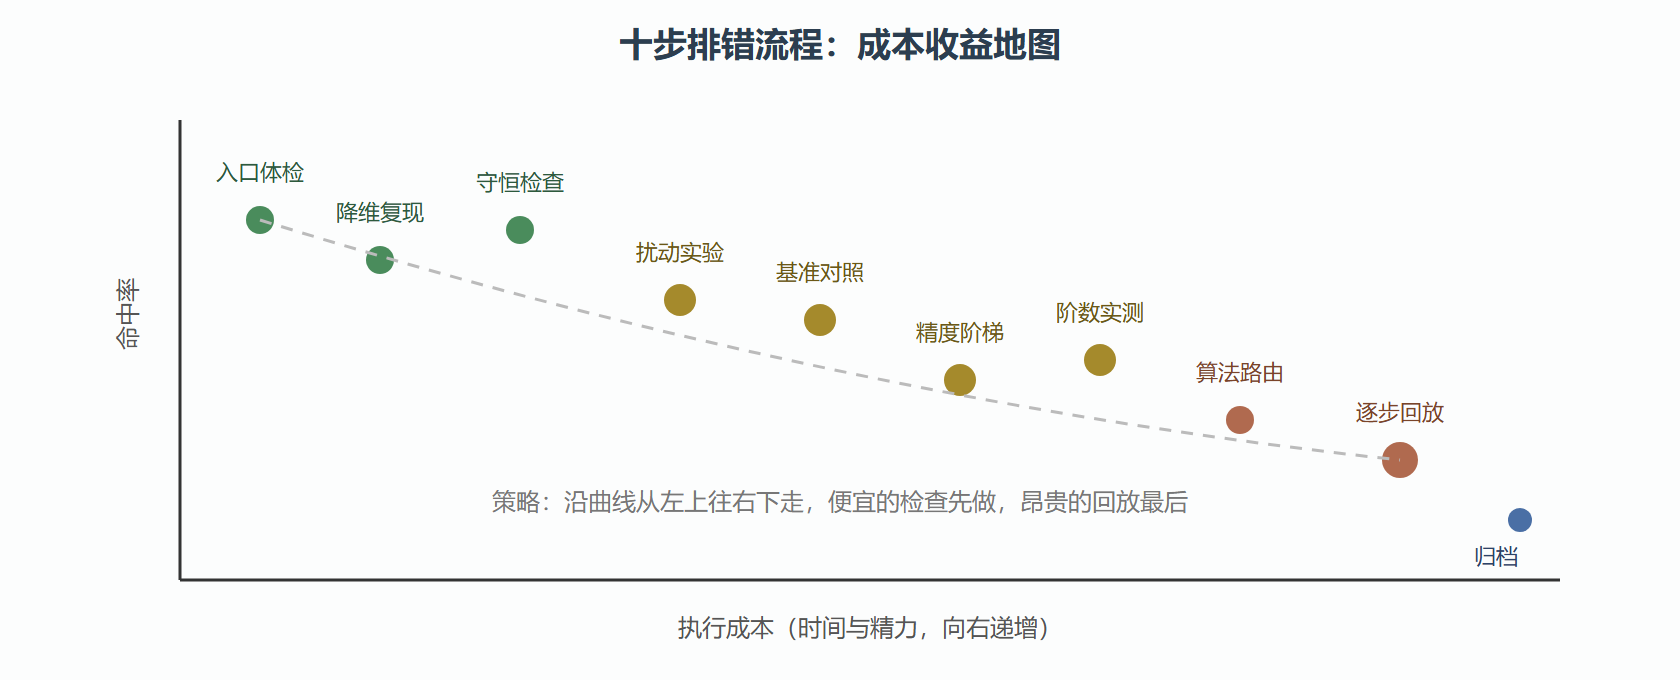
五、十步标准排错流程
把全书方法论装配成一条装配线,遇到"结果不对劲"时从第 1 步走到第 10 步:
- 入口体检:所有输入
isfinite断言、dtype 打印、量纲核对 - 降维复现:找最小可复现例(2×2 矩阵、单变量函数),很多 bug 在缩小的过程中自动现形
- 守恒/对称检查:系统有守恒量或对称性吗?打印它(6.2 节第一关)
- 扰动实验:输入加 eps 级扰动看输出放大倍数,先分清病态还是 bug(本节症状二)
- 基准对照:有解析解/已知解的特例跑一遍(6.2 节第三关)
- 精度阶梯:float64 → float128/mpmath 重算,精度提升后结果变好 → 舍入主导;不变 → 截断或逻辑错误
- 阶数实测:收敛阶对上理论阶吗?对不上必有实现 bug(6.2 节第二关)
- 算法路由:按症状四的决策树换方法(显式换隐式、牛顿换混合、裸梯度换共轭)
- 逐步回放:在最小例上打印每一步的中间量,与手算对照——最后的手段,也是最诚实的手段
- 结案归档:把根因、修复、验证证据写进代码注释与报告(6.2 节模板)
图 6.3-1 排错十步的优先级与成本
六、FAQ 三则
问题一:什么时候该怀疑是数值问题而不是自己代码写错了?
代码逻辑自查两遍、单元测试全过、但结果仍"物理上不合理"时,立即做扰动实验(症状二)。输出对输入扰动放大百万倍以上,优先怀疑病态;放大倍数正常,回头继续找逻辑 bug。经验比例:新手遇到的"灵异问题"约七成是边界处理 bug,三成才是真正的数值病理——所以降维复现(第 2 步)永远排在数值分析之前。
问题二:epsilon 保护(分母加 1e-12)是好习惯吗?
是止血贴不是治疗。它把崩溃换成静默的精度损失,适合临时救火和演示,但正式代码里应该做的是:分析分母趋零的条件(数据边界、算法阶段),在那些条件下走专门分支。滥用 epsilon 的代码会积累出"到处都有一点说不清的误差"的慢性病。
问题三:如何向非技术同事解释数值误差?
用测量类比:双精度相当于一把刻度 0.0000000000000002 毫米的尺子,但被测物体本身在热胀冷缩(数据误差),尺子读数还会受手法影响(算法误差)。我们报告的不是"长度是多少",而是"长度是多少、且有多大把握"。这个类比属于计量学域,没有用禁用的生活化场景,同时准确传达了"数值结果 = 数值 + 置信度"的全书主张。
本节要点回顾
- NaN 溯源:定位第一现场而非下游污染,入口 isfinite 断言是标准防线
- 先定性再动手:扰动实验区分病态与 bug,决定后续完全不同的两条路线
- 合法差异 vs 真 bug:差异能用已知机理解释到量级就是合法,解释不通按 dtype → 求和顺序 → 边界不对称的顺序追查
- 迭代不收敛路由:暴增减步长、横盘查平坦区、慢收敛查条件数、步长被压查刚性
- 十步流程:便宜的检查先做,逐步回放是最后手段,结案归档是必做项
全教程在此收官。回头翻目录你会发现:六个章节其实是同一个故事讲了六遍——误差在某处诞生(浮点、离散、采样),沿着某种通道传播(运算、条件数、时间步、方差),而计算数学的全部手艺,就是在这条传播链上设卡、定量、结案。