2.6 流程演练:用Python把问题情境建成对象模型
2.6 流程演练:用Python把问题情境建成对象模型
本节摘要:USIT 的分析产物散落在白板和便签上,复盘与协作都很吃力。本节用 Python 标准库把"封闭世界—把手—概念—评分"整条流水线建成一套对象模型,一次分析的全部痕迹变成可版本管理、可团队共享的数据。
为什么值得代码化
白板上的 USIT 有三个顽疾:分析痕迹会丢失(拍照归档后没人再看)、覆盖度靠感觉(算子轮询是否均匀无人核实)、跨场次难累积(上次分析的把手清单这次找不到)。把问题情境建成对象模型,三件事同时变容易——覆盖度可以计算、分析可以 diff、经验可以沉淀。而且这个模型不需要数据库,一个纯标准库脚本就能跑。
数据类设计
模型的核心是四个数据类,正好对应五步流程的四个中间产物:封闭世界(第一步)、把手清单(第二步)、概念卡片(第三步)、评分记录(第四步)。第五步验证作为概念的状态字段挂在卡片上。
from dataclasses import dataclass, field @dataclass class ObjectInWorld: name: str kind: str # 自然物 / 人造物 / 场 attributes: dict = field(default_factory=dict) # 属性名: 角色(致害/受害/可利用) @dataclass class Handle: obj_attr: str # 形如 腔内空气.压强 role: str # 致害 / 受害 / 可利用 frame: str # 所在因果链帧 @dataclass class Concept: name: str op: int # 来源算子 1-5 handle: str idea: str risks: list = field(default_factory=list) score: float = 0.0 stage: str = "已生成" # 已生成/入围/验证中/已实施/已否决 @dataclass class Analysis: title: str objects: list = field(default_factory=list) handles: list = field(default_factory=list) concepts: list = field(default_factory=list) def add_concept(self, c: Concept): self.concepts.append(c) def coverage(self): from collections import Counter return Counter(c.op for c in self.concepts), Counter(c.handle for c in self.concepts)
字段设计的两个细节值得说。Handle.frame 保留因果链帧号,是为了让第 4 步的互补组合判定可以机械化——两个入围概念帧号不同即候选组合。Concept.stage 是有限状态字段,第 5 步的门禁推进直接改这个字段,分析结束时扫一眼状态分布就知道每个概念的命运。
装载接头案例并跑通全流程
ana = Analysis(title="户外电缆接头进水导致信号劣化") ana.objects = [ ObjectInWorld("接头护套", "人造物", {"接缝间隙": "致害", "曲面几何": "可利用"}), ObjectInWorld("密封胶", "人造物", {"弹性": "可利用"}), ObjectInWorld("导体接头", "人造物", {"表面状态": "受害"}), ObjectInWorld("腔内空气", "自然物", {"压强": "致害", "热容": "可利用"}), ObjectInWorld("雨水与水汽", "自然物", {"浓度": "致害", "凝结温度": "致害"}), ] ana.handles = [ Handle("腔内空气.压强", "致害", "F2"), Handle("接头护套.接缝间隙", "致害", "F2"), Handle("腔内空气.凝结温度", "致害", "F4"), Handle("导体接头.表面状态", "受害", "F5"), ] for c in [ Concept("单向呼吸阀接头", 4, "腔内空气.压强", "接缝增设只出不进几何", ["粉尘堵阀口"]), Concept("腔体半填充固态件", 2, "腔内空气.压强", "降低腔内气体总量", ["填充件与导体绝缘配合"]), Concept("内壁疏水涂层", 2, "腔内空气.凝结温度", "破坏凝结表面条件", ["涂层老化周期未知"]), Concept("集水导流功能面", 4, "腔内空气.凝结温度", "凝结水收集并导出", ["排水通道冰冻风险"]), Concept("密封胶弹性追随", 1, "接头护套.接缝间隙", "胶形变追随缝隙变化", ["长期压缩永久变形"]), Concept("通道迷宫化", 3, "接头护套.接缝间隙", "延长渗入路径", ["装配工时增加"]), ]: ana.add_concept(c) ops, handles = ana.coverage() print("算子覆盖:", dict(sorted(ops.items()))) print("把手覆盖:", dict(handles)) stage_view = {} for c in ana.concepts: stage_view.setdefault(c.stage, []).append(c.name) print("概念状态:", stage_view)
运行后 coverage 立刻暴露一个盲区:把手"导体接头.表面状态"上没有任何概念挂载——轮询表有一行是空的。这正是 2.3 节说的"空格即盲区":受害属性也需要对策兜底(比如表面镀层作为最后防线),补上一张卡片后覆盖度才算闭合。这种机器自检,人眼扫便签墙是做不到的。
从对象模型到团队资产
一次分析跑完,Analysis 实例可以序列化存档(标准库的 pickle 或转存 JSON 均可)。存档的价值在三次复用:复盘时,重算覆盖度看当时漏了哪个算子;交接时,接手者读对象模型比读会议纪要快一个量级;积累时,跨案例统计"哪个算子在本行业命中率最高",把团队直觉变成团队数据。
需要提醒边界:这套模型管理的是分析痕迹,不管理工程数据——验证阶段的试验记录、试点的遥测数据仍属工程系统,对象模型只引用其结论,不试图吞下它们。方法工具与工程工具各守本分,是长期可维护的前提。
对象模型与五步流程的映射
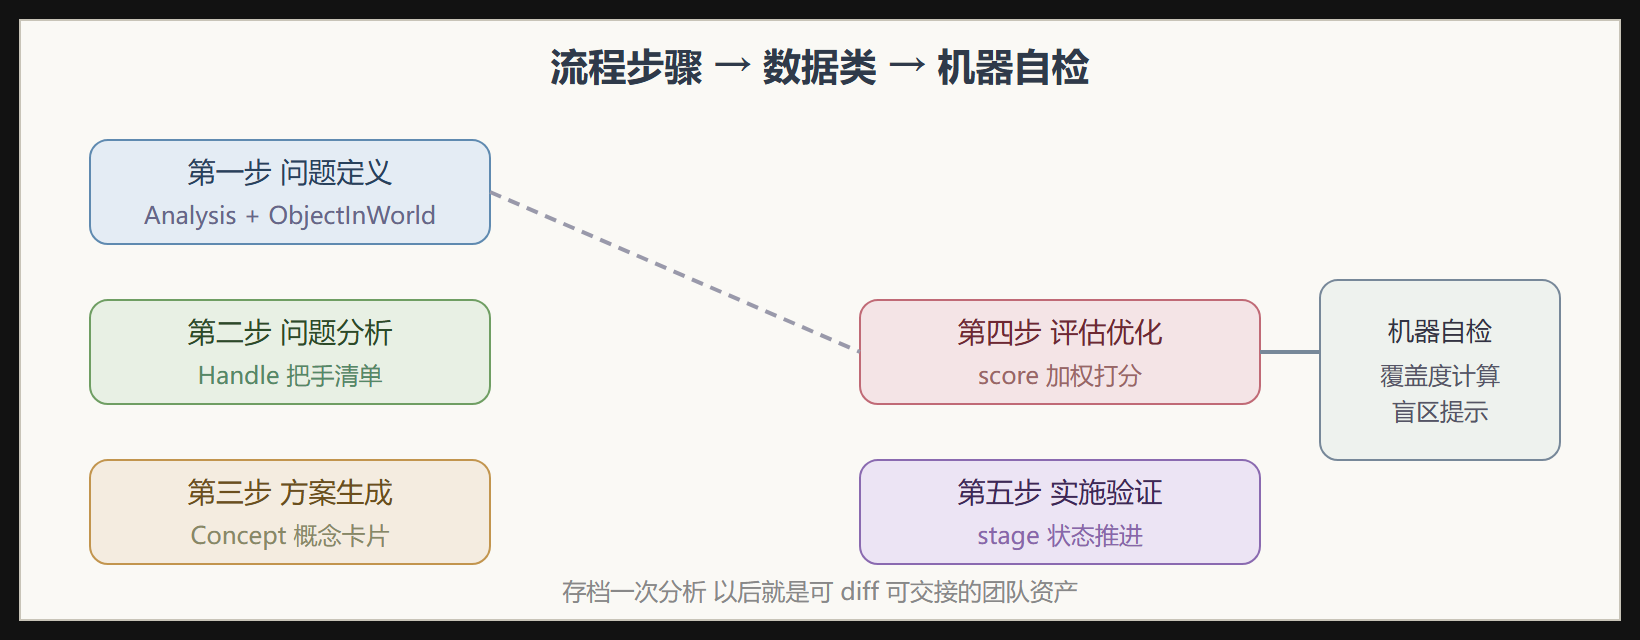
本节要点回顾
- 四个数据类:封闭世界、把手、概念卡片、评分状态——正好对应五步的中间产物
- frame 字件是组合判定钥匙:概念挂帧号,互补组合即可机械化筛查
- coverage 是盲区探测器:算子×把手的空格一眼现形,这是白板做不到的
- 存档三复用:复盘、交接、跨案例统计,把团队直觉熬成团队数据
- 边界清楚:模型管分析痕迹,工程数据留给工程系统,只引用不吞并
常见问答
这套模型能不能直接用到大语言模型辅助分析上
能,而且是一个自然接口。对象的属性字典、功能边表、算子口令都是结构化文本,可直接作为提示词的骨架:让模型对每个"算子×把手"格子生成三个候选描述,人负责筛选与物理把关。关键是保持 2.3 节的纪律——模型是轮询的加速器,评价与筛选权始终在人手里。
dataclass 为什么不用字典就够了
两三场分析用字典确实够。dataclass 的回报在规模化之后:字段拼写错误在定义时就被发现、新增字段有类型约束、跨案例统计时字段名一致才可聚合。方法资产化的前提是结构一致,字典的自由度在十场分析之后会变成统计的噩梦。
序列化用 pickle 还是 JSON
推荐 JSON:可读、可版本比对、跨语言。pickle 唯一的优势是省事,但存档文件一旦打不开,分析资产就全损。用标准库的 json 模块,配一个把 dataclass 转 dict 的小函数即可,不需要第三方库。