3.6 属性-功能矩阵生成器:把OAF分析自动化
3.6 属性-功能矩阵生成器:把OAF分析自动化
本节摘要:手工做 OAF 分析,对象一多属性清单就管不住。本节写一个可跑的属性-功能矩阵生成器:输入对象与属性清单,自动产出"属性×功能"排查底表、标注致害与可利用角色、提示空行空列代表的盲区。
矩阵为什么是正确的形状
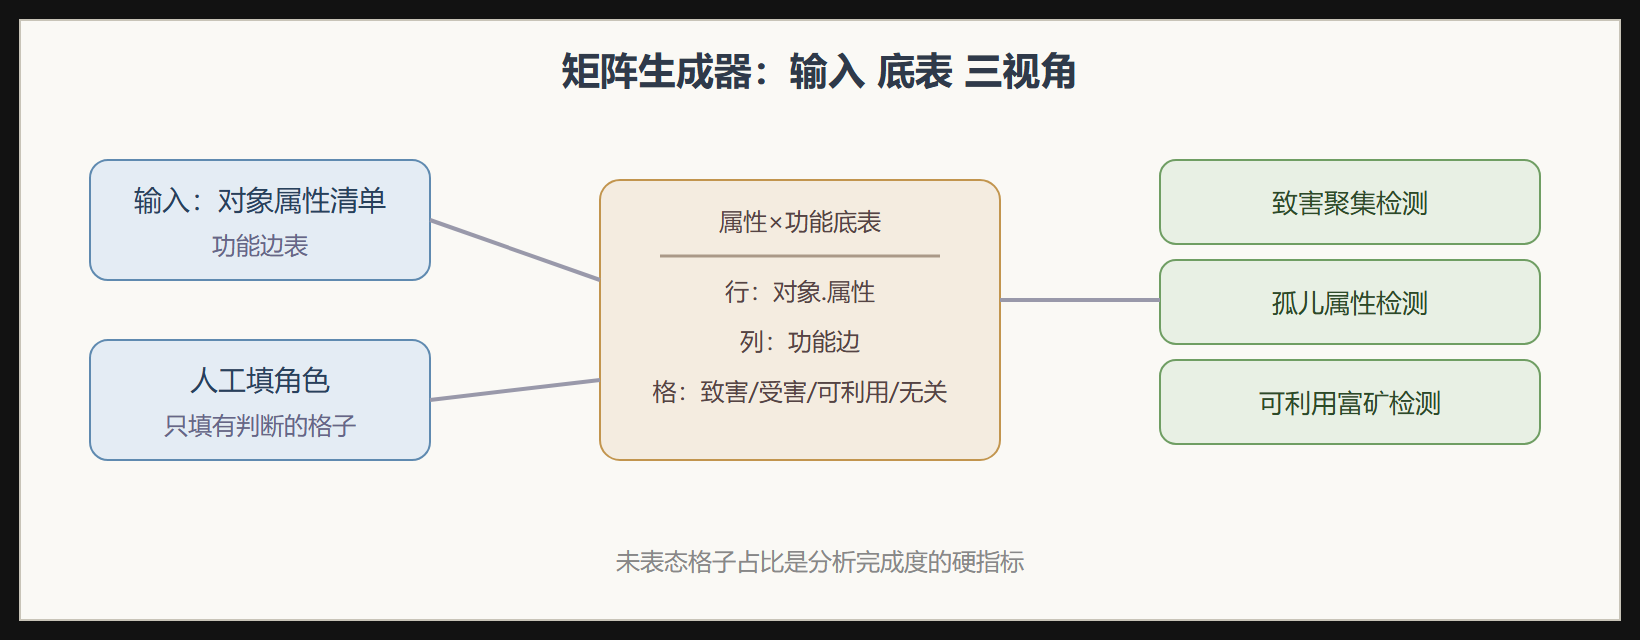
OAF 分析的本质是三层映射:对象→属性→功能。三层两两追问,最自然的容器就是矩阵。属性-功能矩阵以属性为行、功能(或作用对象)为列,格子填角色:这个属性在这个作用里是致害、受害、可利用还是无关。矩阵的三个天然优势:完备性(每个属性×功能组合都有格子,不许跳过)、可计算(空格、某类角色的聚集一眼可辨)、可交接(新成员拿到矩阵十分钟进入状态)。
手工维护矩阵的痛苦在规模:十个对象平均六个属性,就是六十行;乘上五条功能边,三百个格子要逐个表态。这正是脚本的用武之地——人只填有判断的格子,机器负责结构、查漏、统计。
生成器的完整实现
from dataclasses import dataclass, field @dataclass class AFMatrix: objects: dict = field(default_factory=dict) # 对象名 -> 属性列表 functions: list = field(default_factory=list) # (源, 动作, 目标) roles: dict = field(default_factory=dict) # (属性, 功能) -> 角色 def cell(self, attr, func): return self.roles.get((attr, func), "未表态") def fill(self, attr, func, role): assert role in ("致害", "受害", "可利用", "无关", "未表态") self.roles[(attr, func)] = role def blind_spots(self): return [(a, f) for a, _ in self.attr_rows() for f in self.functions if self.cell(a, f) == "未表态"] def attr_rows(self): return [(f"{o}.{a}", a) for o, attrs in self.objects.items() for a in attrs] m = AFMatrix( objects={"腔内空气": ["压强", "热容"], "护套": ["接缝间隙", "内壁表面能"], "密封胶": ["弹性"], "导体": ["表面状态"]}, functions=[("腔内空气", "换气", "外界"), ("护套", "阻隔", "水汽"), ("密封胶", "封堵", "接缝"), ("导体", "导通", "信号")], ) m.fill("腔内空气.压强", ("腔内空气", "换气", "外界"), "致害") m.fill("腔内空气.热容", ("腔内空气", "换气", "外界"), "可利用") m.fill("护套.接缝间隙", ("护套", "阻隔", "水汽"), "致害") m.fill("护套.内壁表面能", ("护套", "阻隔", "水汽"), "可利用") m.fill("密封胶.弹性", ("密封胶", "封堵", "接缝"), "可利用") m.fill("导体.表面状态", ("导体", "导通", "信号"), "受害") for label, a in m.attr_rows(): row = " ".join(f"{f[1]}:{m.cell(a, f)}" for f in m.functions) print(f"{label:12s} {row}") print("未表态格子:", len(m.blind_spots()))
打印出的矩阵是分析现场的作战地图:每行一个属性,每列一条功能,角色一目了然。最后一行的"未表态格子"数是质量指标——超过两成未表态说明分析没做完就散会了。
三个机器视角
矩阵填完后,脚本还提供三个人眼容易漏的视角。
视角一:角色聚集检测。 若"致害"角色在某列高度聚集,说明这条功能边是全链路的众矢之的——它就是第 4 章算子应该重点轰炸的边。统计代码一行:按列计数角色。
视角二:孤儿属性检测。 某行全是"无关",说明这个属性当初列进了清单却没有参与任何功能——要么是分析遗漏(其实参与只是没看出来),要么是冗余属性(该从清单删掉)。两种情况都值得开会说清。
视角三:可利用属性热力。 "可利用"最多的对象是解题的富矿——接头案例里密封胶与护套内壁都是双角色属性持有者,资源导向的算子 1 应该先从它们下手。
# 三个视角的最小实现 from collections import Counter col_stats = Counter() for (attr, func), role in m.roles.items(): if role == "致害": col_stats[func[1]] += 1 print("致害聚集的功能边:", col_stats.most_common()) orphan = [label for label, a in m.attr_rows() if all(m.cell(a, f) == "无关" for f in m.functions)] util = Counter() for (attr, func), role in m.roles.items(): if role == "可利用": util[attr.split(".")[0]] += 1 print("可利用富矿对象:", util.most_common())
生成器工作流
与 2.6 节对象模型的关系
2.6 节的 ObjectInWorld.attributes 字典存的是"属性名→角色",本节的矩阵把角色精确到"属性×功能"粒度。两套可以合流:把矩阵生成器的 roles 字典挂进对象模型,分析归档时一并存盘。工程上建议保持"一个分析一份模型对象"的纪律,矩阵、概念、评分全部作为它的内部结构——散落成多个文件的分析资产,三个月后没人记得怎么拼回来。
本节要点回顾
- 矩阵保证完备:属性×功能的每个格子都必须表态,跳格就是跳过线索
- 人填判断机器管结构:分工原则——人有判断力,脚本有耐心
- 未表态占比是完成度:两成以上未表态,分析不许散会
- 三视角防盲区:致害聚集、孤儿属性、可利用富矿,全是人工易漏的模式
- 与对象模型合流:矩阵作为对象模型的内部结构归档,防止分析资产碎片化
常见问答
矩阵的行列能不能反过来(功能为行属性为列)
可以,语义等价。选择原则看团队习惯:属性导向的团队(材料、工艺背景)习惯按属性扫行,功能导向的团队(设计、系统背景)习惯按功能扫行。关键是整场分析保持一种方向,中途翻转矩阵会让人晕。
"无关"和"未表态"为什么要区分
无关是判断后的结论(这个属性确实不参与该功能),未表态是没来得及想。把两者混为一谈会掩盖分析缺口。这也是生成器把"未表态"单独设为默认值的原因——完成度指标只统计未表态,无关不算缺口。
矩阵做完之后多久更新一次
每次分析会议后更新一次,与白板照片同步归档。跨场次累积的矩阵价值翻倍:第二个问题若与旧问题共享封闭世界对象,旧矩阵的角色标注可以直接继承,分析提速一半。矩阵是团队记忆的最紧凑形态。