4.6 概念筛选打分器:可跑的排名与敏感性分析
4.6 概念筛选打分器:可跑的排名与敏感性分析
本节摘要:2.4 节手工演过的加权打分,本节代码化成一个可复用的筛选打分器:冻结指标与权重、逐概念打分、输出排名,并附送两项手工难以完成的能力——权重敏感性分析(排名对权重扰动的稳健性)与并列概念的破平局规则。
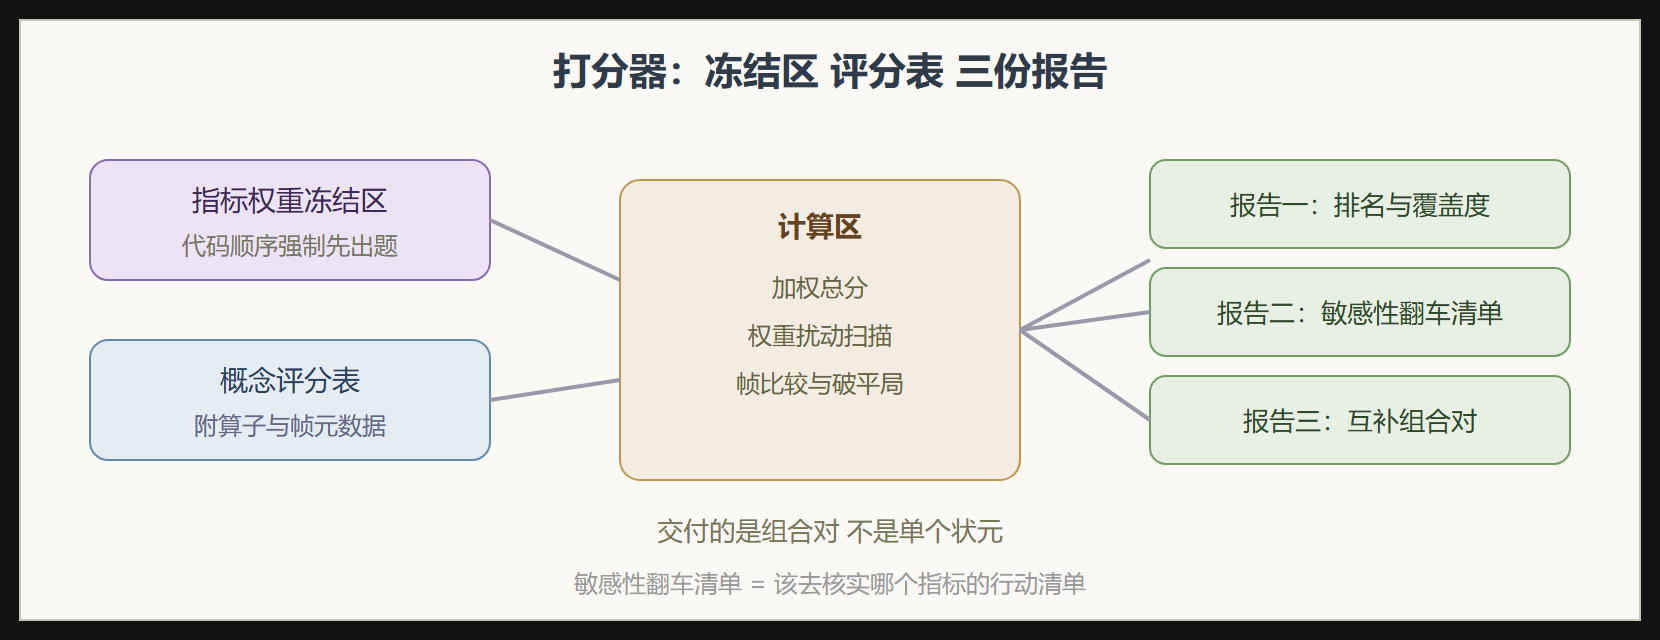
打分器的三块结构
第一块:指标与权重冻结区。 脚本开头显式声明指标字典与权重,权重合计必须为 1。冻结区放在打分数据之前,"先出题后看答案"的纪律由代码顺序强制执行——后来的维护者一眼能看到指标是否在概念清单之后被动过。
第二块:概念评分表。 每个概念一行,附"来源算子"与"作用帧"两个元数据列。来源算子用于轮询覆盖度统计,作用帧用于组合互补性判定——它们不参与打分,但决定第四步的组合决策。
第三块:输出区。 排名、覆盖度、敏感性三份报告。
from dataclasses import dataclass @dataclass class ConceptScore: name: str op: int # 来源算子 frame: str # 作用帧 scores: dict # 指标 -> 1..5 分 WEIGHTS = {"有效": .30, "实施": .25, "可靠": .20, "成本": .15, "维护": .10} assert abs(sum(WEIGHTS.values()) - 1) < 1e-9, "权重合计必须为1" pool = [ ConceptScore("单向呼吸阀接头", 4, "F2", {"有效": 5, "实施": 4, "可靠": 4, "成本": 4, "维护": 4}), ConceptScore("内壁疏水涂层", 2, "F4", {"有效": 4, "实施": 5, "可靠": 3, "成本": 4, "维护": 5}), ConceptScore("集水导流功能面", 4, "F4", {"有效": 5, "实施": 3, "可靠": 4, "成本": 3, "维护": 3}), ConceptScore("密封胶弹性追随", 1, "F2", {"有效": 3, "实施": 5, "可靠": 3, "成本": 5, "维护": 5}), ConceptScore("通道迷宫化", 3, "F2", {"有效": 4, "实施": 3, "可靠": 4, "成本": 3, "维护": 4}), ConceptScore("半填充固态件", 2, "F2", {"有效": 4, "实施": 2, "可靠": 4, "成本": 3, "维护": 3}), ] def total(c): return sum(c.scores[k] * w for k, w in WEIGHTS.items()) ranked = sorted(pool, key=lambda c: -total(c)) for c in ranked: print(f"{c.name:9s} {total(c):.2f} 算子{c.op} 帧{c.frame}")
敏感性分析:排名稳不稳
手工打分最大的隐患是"权重拍脑袋"——防潮有效占三成还是四成,往往取决于会上谁嗓门大。打分器用权重扰动法回答排名稳健性:把每个权重上下浮动十分之一(其余权重按比例归一),看排名会不会翻。翻了大说明前两名本就旗鼓相当,决策依据应该转向组合价值与风险面貌;怎么扰都不翻,排名才算立得住。
import itertools, copy def perturb(w, key, pct): w2 = dict(w); w2[key] = w[key] * (1 + pct) s = sum(w2.values()) return {k: v / s for k, v in w2.items()} def rank_under(w2): order = sorted(pool, key=lambda c: -sum(c.scores[k] * v for k, v in w2.items())) return [c.name for c in order[:2]] base = rank_under(WEIGHTS) flips = [] for k in WEIGHTS: for pct in (+0.1, -0.1): top2 = rank_under(perturb(WEIGHTS, k, pct)) if top2 != base: flips.append((k, pct, top2)) print("基准前二:", base) print("扰动翻车数:", len(flips)) for k, pct, t in flips: print(f" 权重{k}{pct:+.0%}时前二变为 {t}")
如果运行显示扰动全部不翻车,前二排名稳健,可以放心进入组合环节;若出现翻车,说明需要补数据——最常缺的是"实施"指标上那半分到底站不站得住,去现场核实它,比继续开会争论权重有效得多。敏感性分析的真正产出从来不是排名本身,而是**"哪个指标值得再花力气核实"的行动清单**。
破平局与组合
打分器附两条破平局规则,按顺序适用:规则一,帧优先——总分差在 0.3 以内视为平手时,作用帧更靠上游的概念胜出(上游杠杆率高,2.2 节结论);规则二,独立失效胜出——仍平手时,选失效模式与现有主力概念不同的那个,组合后的双保险才真的独立。
组合判定直接复用 2.4 节的帧比较:入围概念两两比对 frame 字段,跨帧组合标记为"互补",同帧标记为"冗余"。最终交付物是"主概念 + 副概念"的组合对,而非单个冠军——这是 USIT 评估阶段与普通评分表的又一处差别:它选的是组合,不是状元。
打分器数据流
本节要点回顾
- 冻结区写在评分表前:代码顺序强制"先出题后看答案"
- 元数据两列:来源算子供覆盖度统计、作用帧供组合判定,均不参与打分
- 扰动法测稳健:权重上下浮一成看翻不翻车,翻车清单就是核实行动清单
- 破平局两规则:帧靠上游优先、失效模式独立优先
- 选组合不选状元:主概念加副概念的双保险结构才是最终交付物
常见问答
打分用五档还是百分制
五档。百分制的假精度诱导团队在八十二分和八十五分之间争论,那三分差没有任何信息量。五档强制每档有明确语义(一很差、三中性、五优秀),分数的粒度与人判断的粒度匹配。
敏感性分析做多深合适
单权重扰动(每个权重正负一成)是最低配置,够用且便宜。更深的双权重联合扰动只在两个权重强相关(比如有效与可靠)时补做。别把敏感性做成蒙特卡洛大工程——它的目的是找翻车点,不是统计置信区间。
打分器能不能外包给不懂业务的同事代跑
不建议。打分的价值一半在分数,一半在"说出理由"的过程——逼出每个人对概念的隐含假设。代跑省下的两小时,会在概念落地后以误解的形式加倍偿还。打分器是讨论的扳机,不是自动裁决机。