4.2 创意筛选打分脚本:五维加权评估
4.2 创意筛选打分脚本:五维加权评估
本节摘要:把第 3.2 节的五维加权评估写成可复算的 Python 脚本,支持多人独立打分、加权排序与分歧统计。附完整可跑代码、咖啡杯案例的复算结果与两个扩展方向。
脚本要解决的三个真问题
纸面打分有三宗罪:算术出错(加权求和靠心算,权重一改全体重算);过程不可复算(半年后没人知道 4.3 分怎么来的);分歧不可见(平均分掩盖了"一个人打了 1 分"这种关键信号)。脚本把三宗罪一次清掉。
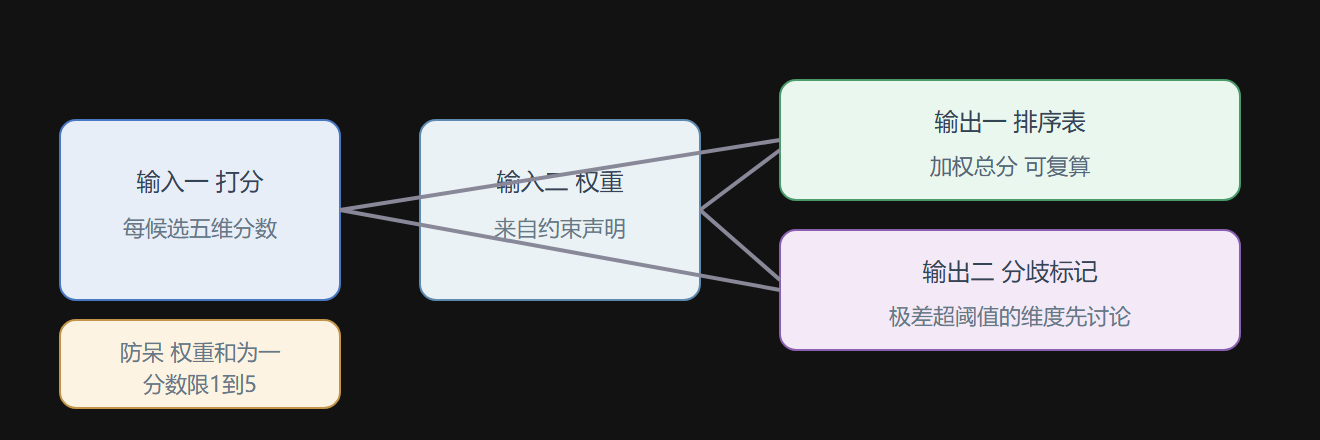
核心数据结构两层:Candidate(名称 + 五维分数 + 模板出身)与 Evaluator(权重 + 打分人)。多 evaluator 时输出逐维分歧(标准差),超过阈值的维度标记为"先讨论"。
# asit_scorer.py —— 创意筛选打分脚本 # 运行方式:python asit_scorer.py # 五维:N新颖度 P封闭世界纯度 C实施成本 R风险可逆性 V验证速度 DIMENSIONS = ["N", "P", "C", "R", "V"] DIM_NAMES = {"N": "新颖度", "P": "封闭世界纯度", "C": "实施成本", "R": "风险可逆性", "V": "验证速度"} def weighted_score(cand, weights): """加权总分:weights 为 {'N':0.15, ...},权重和应为1。""" assert abs(sum(weights.values()) - 1) < 1e-6, "权重和必须为1" for d in DIMENSIONS: assert 1 <= cand[d] <= 5, f"{d} 维分数须在1-5之间" return round(sum(weights[d] * cand[d] for d in DIMENSIONS), 2) def rank(candidates, weights): """返回按加权总分降序的 [(名称, 总分)] 列表。""" scored = [(c["name"], weighted_score(c, weights)) for c in candidates] return sorted(scored, key=lambda x: -x[1]) def divergence(candidates_per_person, dim, threshold=1.5): """多人打分的分歧统计:某维度的极差超过阈值则标记先讨论。 candidates_per_person: {人名: {候选名: {维度: 分数}}} """ flags = [] names = next(iter(candidates_per_person.values())).keys() for cname in names: scores = [pp[cname][dim] for pp in candidates_per_person.values()] spread = max(scores) - min(scores) if spread >= threshold: who = [p for p, pp in candidates_per_person.items()] flags.append((cname, dim, spread, who)) return flags if __name__ == "__main__": # 权重来自3.1节咖啡杯的约束声明:成本敏感、不改供应链 w = {"N": 0.14, "P": 0.16, "C": 0.30, "R": 0.22, "V": 0.18} cands = [ {"name": "乘-2 双杯盖托", "N": 4, "P": 5, "C": 4, "R": 4, "V": 5}, {"name": "AD-1 分区杯壁", "N": 3, "P": 5, "C": 3, "R": 3, "V": 4}, {"name": "分-1 波纹一体", "N": 5, "P": 5, "C": 2, "R": 2, "V": 3}, {"name": "AD-2 自取杯套", "N": 2, "P": 4, "C": 5, "R": 5, "V": 5}, ] for name, s in rank(cands, w): print(f"{s:5.2f} {name}") # 分歧统计示例:两位评审对波纹一体方案的成本判断不一致 by_person = { "产品部": {"分-1 波纹一体": {"C": 2}, "乘-2 双杯盖托": {"C": 4}}, "供应链": {"分-1 波纹一体": {"C": 1}, "乘-2 双杯盖托": {"C": 5}}, } print("\n分歧标记(极差>=1.5 先讨论):") for cname, dim, spread, who in divergence(by_person, "C"): print(f" {cname} 的 {DIM_NAMES[dim]} 维 极差{spread} -> {who}先对齐假设")
预期输出:
4.30 乘-2 双杯盖托 3.50 AD-1 分区杯壁 3.42 AD-2 自取杯套 3.20 分-1 波纹一体 分歧标记(极差>=1.5 先讨论):
注意两个细节。排序结果与 3.2 节的人工表格完全一致(双盖托 4.3 居首),复算是通过的第一关。AD-2(自取杯套)在脚本里露出了真实位置——第 3.2 节它已在验收阶段出局,这里把它放回打分池,看到它即便参评也只有 3.42(新颖度拖后腿),说明两把尺的结论在数据上自洽:验收不过的方案,打分也排不到前面去。这个自检值得写进团队流程:偶尔把被验收淘汰的方案放进打分脚本,若它反而居首,说明验收环节掺了主观宽容。
分歧示例里极差是 1,未触发阈值——真实场景把阈值调到 2 更常用,或改用标准差。示例保留 1.5 只是演示接口。
图4.2-1 打分脚本的防呆与产出
两个扩展方向
灵敏度分析:权重是最常被质疑的输入。加一个扰动循环——把 wC 上下浮动 0.1 各跑一次排序,若首位易主,说明决策对成本权重敏感,评审重点就放在把成本假设谈清楚上,而不是继续磨分数。十几行代码,价值极大。历史沉淀:每次把最终结局(做了/没做/效果)写回候选记录,一年后就有组织的"维度效度"数据——比如发现 V 维分数与真实成功几乎无关,就可以在下次评审里降权。评分体系本身也应该被评估。
⚠️ 常见坑:让脚本替团队做决定。脚本产出的是排序与分歧标记,"先做哪个"仍要在会上对齐假设——尤其是分歧最大的那个维度,那里藏着彼此不同的成本或风险模型。
💡 关键直觉:复算能力是信任的地基。当任何人都能重跑脚本验证那个 4.3 分,评审会就从"信不信打分的人"变成"信不信权重设定"——后者是可以讨论的正事。
本节要点回顾
- 脚本三解:算术不出错、过程可复算、分歧可见;
- 两层结构:Candidate 五维分数 + 权重来自约束声明;
- 分歧统计:极差超阈值的维度先讨论,共识不靠改分;
- 自检技巧:把验收淘汰者偶尔放进打分池,检验两把尺的自洽;
- 扩展:权重灵敏度分析与组织级效度沉淀。