2.3 网格解剖:顶点索引与包围盒
2.3 网格解剖:顶点索引与包围盒
本节摘要:网格是绘制流水线的基本单位,由顶点缓冲、索引缓冲与包围盒三件数据结构构成。顶点缓冲是逐顶点的属性表,索引缓冲把顶点拼成三角形,包围盒则是剔除站点的判据。本节用代码把这三件结构逐一拆开验证,为第3章的材质绑定与第5章的绘制调用优化建立数据层面的直觉。
网格是什么
剥掉"3D 物体"的直观外衣,网格就是三块数据的打包:一张逐顶点的属性表、一份把顶点连成三角形的索引清单、一个能快速回答"我大概占多大地方"的盒子。GPU 画三角形,CPU 判断要不要画,三块数据分别服务两端。先建立这个认知,后面所有优化手段——合并、实例化、减面——都只是在动这三块数据的组织方式。
第一块,顶点缓冲。每个顶点带一组属性:位置是三元数组,法线是记录朝向的三元单位向量,还有二维的纹理坐标。属性表按顶点逐行排布:
图 2-3 顶点缓冲与索引缓冲的内存布局
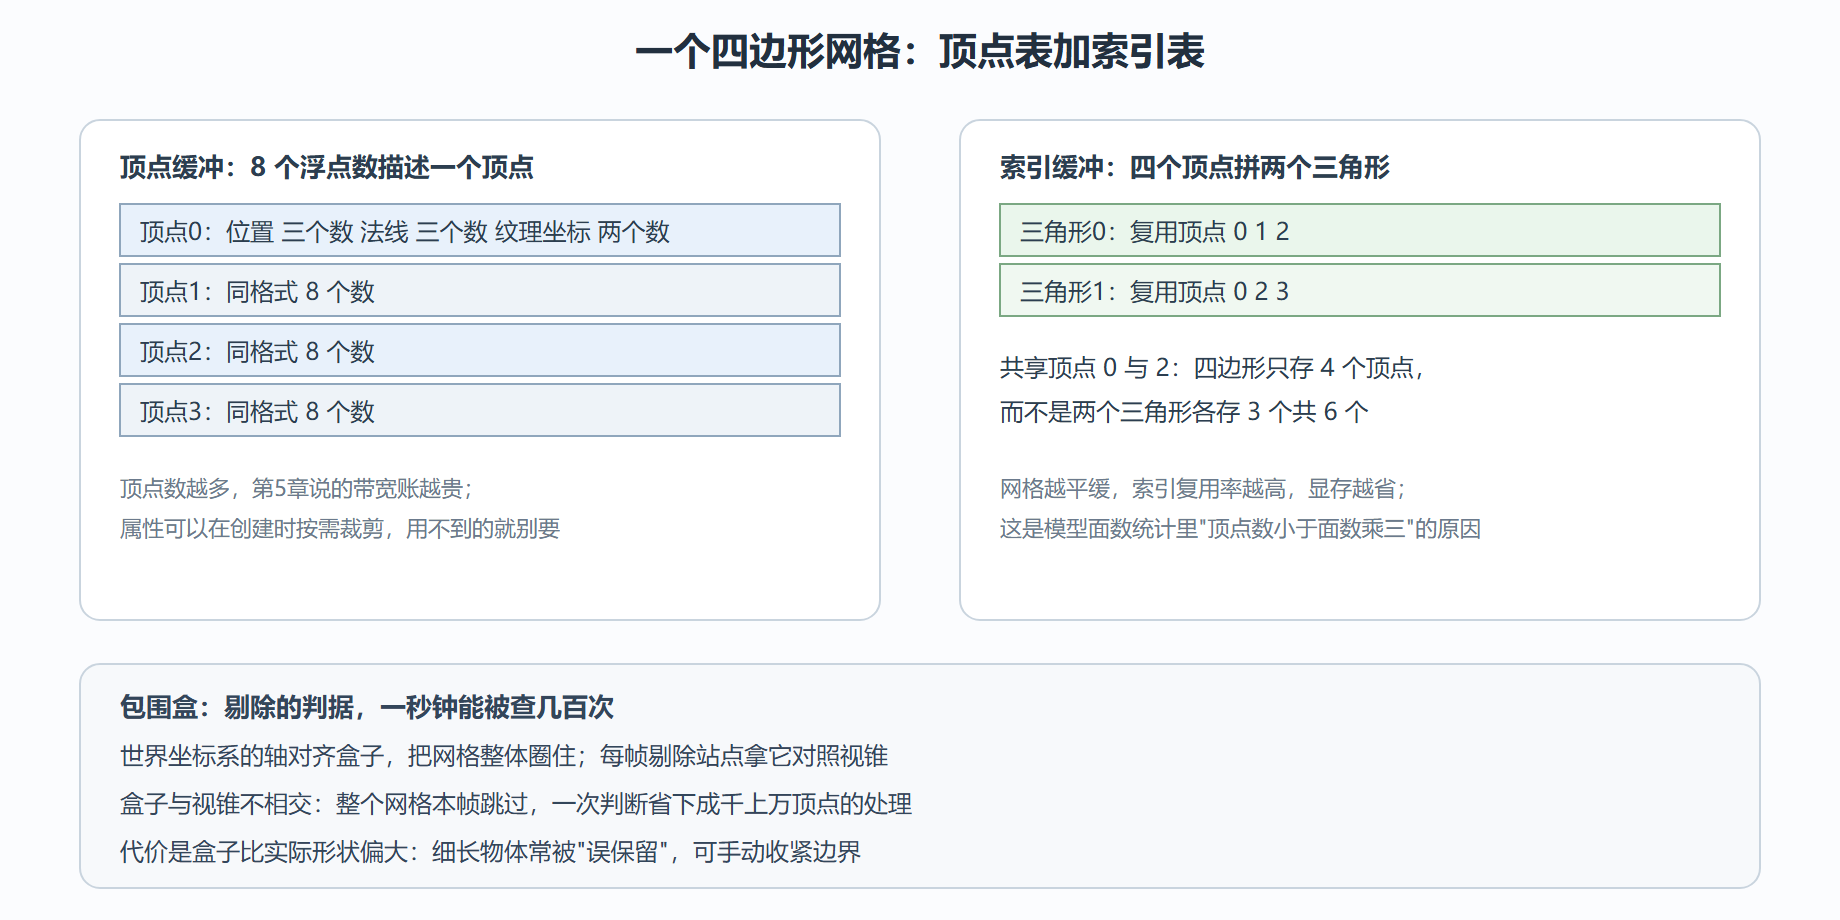
第二块,索引缓冲。GPU 只会画三角形,索引表声明"哪三个顶点组成一个三角形"。共享顶点让数据量显著下降——平缓模型里一个顶点平均被三四个三角形共用。
第三块,包围盒。它是网格在世界里的轴对齐外接盒,每帧第3站拿它对照 2.2 节的视锥,整盒在外就整网格跳过。这是引擎性价比最高的一笔交易:一次盒锥求交,省掉一整个网格的顶点处理与着色。
动手读出网格的底细
用引擎的读取接口给网格做体检,这三个数字在第5章优化前必须先知道:
// 网格体检:顶点数、三角形数、包围盒尺寸 const ball = BABYLON.MeshBuilder.CreateSphere("ball", { diameter: 2, segments: 16 }, scene); const pos = ball.getVerticesData(BABYLON.VertexBuffer.PositionKind); // 位置数组,三个数一顶点 const idx = ball.getIndices(); // 索引数组,三个数一三角形 console.log(`顶点数 ${pos.length / 3}`); console.log(`三角形数 ${idx.length / 3}`); const bb = ball.getBoundingInfo().boundingBox; console.log("包围盒最小角", bb.minimumWorld, "最大角", bb.maximumWorld);
自建顶点数据更能说明"网格就是数据"。手动攒一个贴地四边形:
// 手工构建一个地面四边形:四个顶点、两个三角形 const ground = new BABYLON.Mesh("ground", scene); const positions = [ -2, 0, -2, // 顶点0 左前 2, 0, -2, // 顶点1 右前 2, 0, 2, // 顶点2 右后 -2, 0, 2, // 顶点3 左后 ]; const normals = [ 0, 1, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0 ]; // 朝上的法线:能被顶光照亮 const uvs = [ 0,0, 1,0, 1,1, 0,1 ]; // 纹理坐标铺满整张贴图 const indices = [ 0, 2, 1, 0, 3, 2 ]; // 两个三角形逆时针绕向 ground.setVerticesData(BABYLON.VertexBuffer.PositionKind, positions); ground.setVerticesData(BABYLON.VertexBuffer.NormalKind, normals); ground.setVerticesData(BABYLON.VertexBuffer.UVKind, uvs); ground.setIndices(indices);
绕向(逆时针为正面)写反了,四边形就从上方看不见、从下方才看得见——这是自定义几何第一大坑。法线写错了更隐蔽:几何正确但一片漆黑或亮得诡异,因为光照计算拿法线当反射方向的依据。第3章讲材质时还会回到这两个属性。
包围盒的脾气与治理
包围盒在多数时候是省钱的功臣,但它有自己的脾气。细长物体(旗杆、管道)的盒子比实物肥一圈,斜着看时"盒子进了视锥、实物还在外面",白画一场;美术模型有时自带异常顶点(建模残渣),把盒子撑得巨大,导致永远剔不掉。治理手段是手动收紧边界:
// 收紧被建模残渣撑大的包围盒 pole.refreshBoundingInfo(true); // 先按现有数据重算 const info = pole.getBoundingInfo(); info.boundingBox.reConstruct( info.boundingBox.minimum.scale(0.98), // 各方向内缩百分二,按需调整 info.boundingBox.maximum.scale(0.98) );
剔除失效排查一例
背景:厂房巡检场景三千多台设备,镜头只对着一面墙,帧耗时仍要 12 毫秒——视锥剔除像没生效。操作:第一步用 5.4 节的层视图查可见集,墙后整排设备都标着可见;第二步读包围盒,两台设备的盒子对角线长达四十米,把半个厂房圈了进去;第三步追源头,是建模残渣顶点漂在模型之外把盒子撑大。结果:重算并收紧这两台的包围盒后,同视角帧耗时从 12 毫秒落到 7 毫秒。解读:剔除失效极少是剔除算法的错,九成是判据数据失真——包围盒肥了,引擎按"可能可见"处理反而是正确行为。变式:细长管道密集的场景轴对齐盒天生不合身,更治本的办法是在数据源端按段拆分管道让每段盒子变小,比在引擎里逐个修盒划算。
顺带一个高频小问:顶点数怎么读?位置数组长度除以三;三角形数是索引长度除以三。两个数字的比值(面数除以顶点数)还能看出模型省不省——接近 2 说明顶点复用充分,接近 1 说明几乎没复用,后续合并与减面的空间就藏在这个比值里。
带走三件事
- 网格是三块数据:顶点属性表、三角形索引、轴对齐包围盒,别把它当"物体"看
- 索引复用是省显存的第一杠杆:顶点数小于面数乘三是常态
- 包围盒是剔除的判据:细长物体与残渣顶点是它失准的两类源头,可手动收紧
数据结构清楚了,接下来处理"进货"问题——成千上万个顶点的模型文件如何进场景,以及进场景之后该合并、该实例化还是该克隆。下一节给出选型结论。