4.3 召回验收:命中测试与引用核对
4.3 召回验收:命中测试与引用核对
召回验收的方法论:先造一批"知道正确答案在哪一段"的测试问题,再用命中测试面板逐题核对"命中的分段对不对",用引用正确率代替主观的"答案像不像"。检索层问题调 4.2 的旋钮,生成层问题改提示词——分流诊断是本节的核心手艺。
建库与配检索都完成了(4.1、4.2),本节回答那个绕不开的问题:你怎么知道它好不好?这一节是知识库主线的收口,也是之后每次改动后的回归工具。
背景:一次没有数据的争论
小艺接上知识库后第一周,客服团队内部吵起来了。有人说"答得挺好的",有人说"经常答非所问",谁也说服不了谁——因为双方说的都是自己的个案印象。这种争论在没有测量之前不会有结论,工程的做法是把它变成一个数:引用正确率。
定义先行:对每个测试问题,预先标注"正确答案所在的那一段";跑检索后,若命中分段包含正确段则记命中,否则记失手。一百个问题的命中比例,就是引用正确率。这个指标只衡量检索层,不受模型发挥干扰——这正是它比"看答案"高级的地方。
操作:造题、跑测、看板三步
**第一步,造测试集。**从真实客服记录里挑问题的效率远高于自己编。规则:三十到五十题,覆盖三类——政策主问题(十题)、口语化改写("东西不想要了咋办")、硬词问题(型号、条款号)。每题标注正确分段编号。造完存进团队文档,它将伴随知识库整个生命周期:
召回测试集 v1(节选) Q03 七天无理由退货要什么条件 → 政策总则·第七条 Q11 东西不想要了咋整 → 政策总则·第七条(口语改写) Q17 YY-33 电磁炉能退吗 → FAQ·型号专区第 12 条 Q24 发票丢了还能开吗 → FAQ·发票第 3 条 Q29 你们 CEO 是谁 → 无对应分段(库外题,测阈值拦截)
Q29 这类"库外题"专测相似度阈值:期望结果是"无命中",触发兜底话术转人工,而不是硬凑三条。
**第二步,跑命中测试。**知识库页的"命中测试"输入测试问题,面板直接显示命中的分段、相关性与得分。逐题核对,记录失手题号。这里看的是命中层,与模型无关。
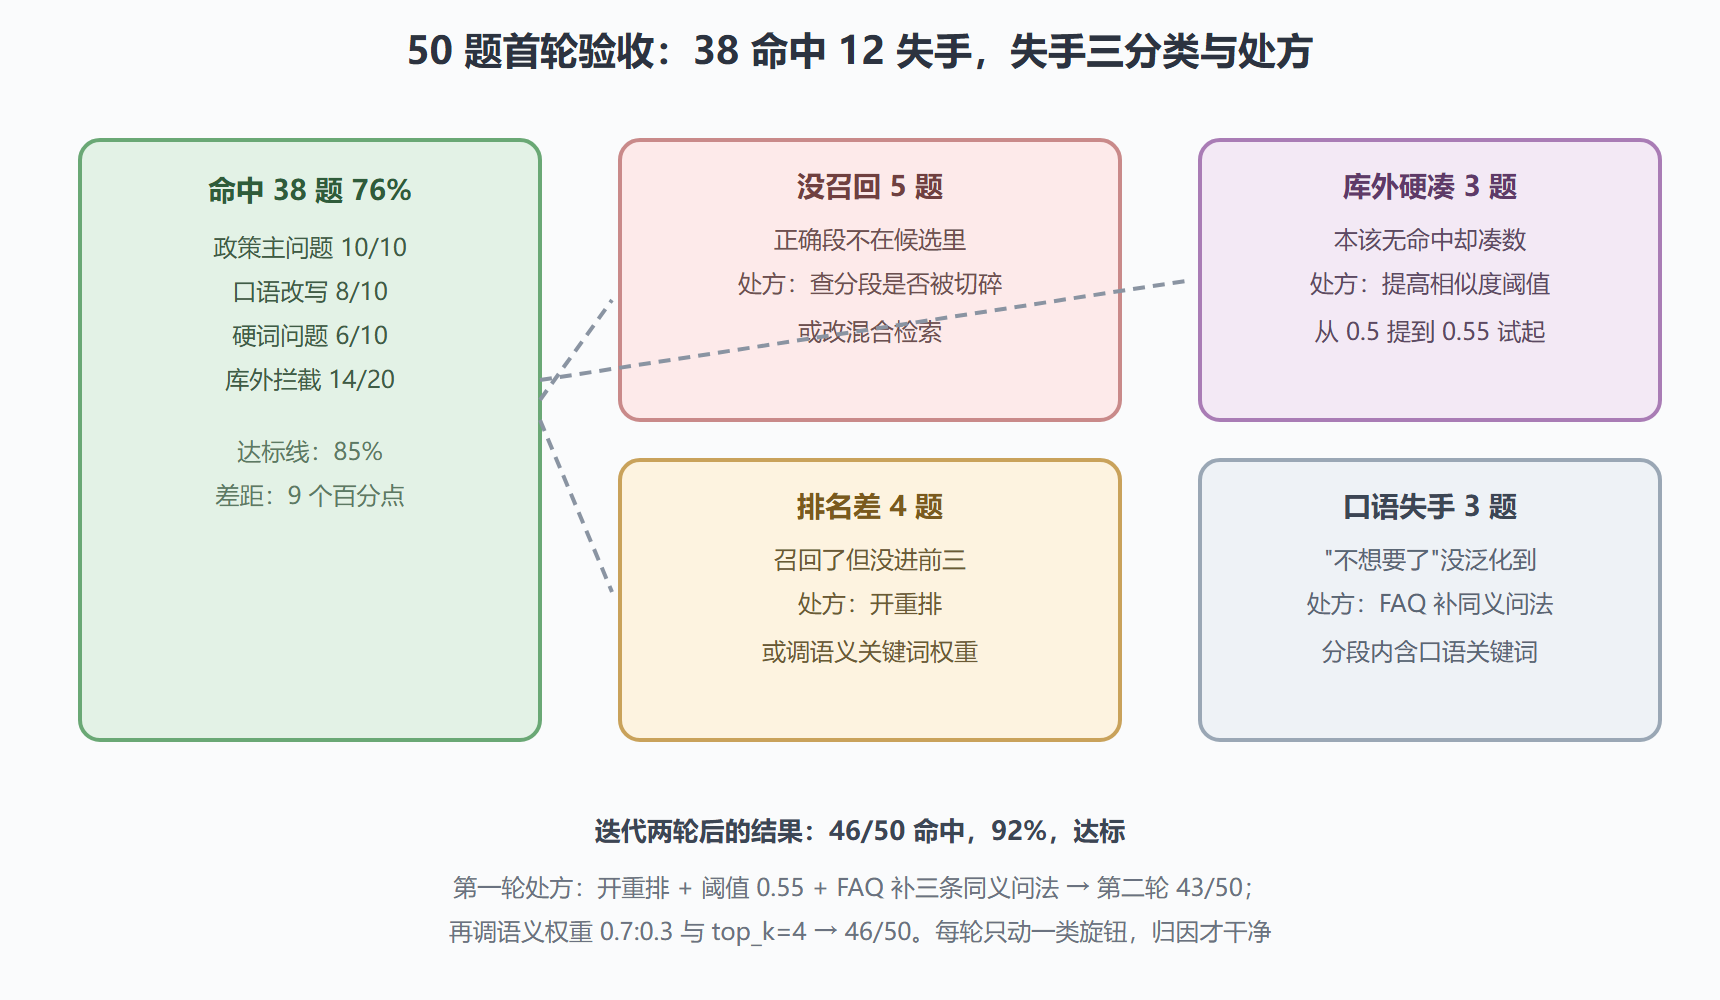
**第三步,看板汇总。**把逐题结果汇成一张三列看板:题号、命中与否、失手原因初判。原因只有三类可选——没召回(正确段不在 top_k 里)、排名差(召回了但没进最终前三)、库外硬凑(本该无命中却凑了三条)。
图 4-2:第一轮验收看板与分流诊断
结果与解读
首轮 76%,两轮迭代后 92%(过程见图下方注记)。解读三个要点:其一,重排贡献最大(四题排名差全部修复),因为它专门解决"召回了但排序不对";其二,阈值修复了硬凑,库外题的拦截从 14/20 升到 18/20,代价是两题原本能命中的被拦——阈值永远在"拦硬凑"与"误杀"之间走钢丝,0.5 到 0.6 之间微调;其三,FAQ 补同义问法比调任何参数都灵——口语失手的三题里两题靠加了两行"不想要了/退掉"的同义问答就修复了。数据之外还有个教训:每轮只动一类旋钮,否则命中率涨了也不知道是谁的功劳。
变式:三类常见变奏
**变式一,答案对但引用空。**命中正常、模型却不用引用——生成层问题,去 3.2 节的说明书里加引用规则("回答政策时必须依据下面的参考资料"),一轮即愈。**变式二,长尾问题整体失手。**如果失手集中在某主题(比如运费险),别调检索,先补文档——库里没有的知识,任何参数都救不回来。**变式三,库越长越差。**文档从 30 页涨到 300 页后正确率下滑,通常是分段子库之间抢排名:给不同文档分库(政策库、FAQ 库),应用里按问题类型路由到不同库——这就摸到了第 5 章工作流的门槛。
验收节奏:一次性的还是持续的?
一次性验收发版前做,持续验收才是长期质量的护城河。小艺团队定的节奏供参考:
持续验收节奏 每次知识库变更后:跑全量测试集(50 题,约 15 分钟) 每周运营例会前: 抽 20 题复跑,对比上周正确率 每月固定动作: 测试集扩题 5-10 道(从当月真实日志里挑) 触发式扩题: 线上出现"引用了但答错"的个案,当天变新题入库
测试集的维护权归运营(他们最接近真实用户),版本随知识库一起进 DSL 版本库管理。这套节奏跑两个月后你会得到一个副产品:一份随业务长大的"问题-正确分段"对照表——它既是验收资产,也是新人培训材料,还是第 5 章问题分类器的类别设计输入。一份测试集,三处复用。
问题:正确率是不是越高越好,要不要冲 100%?
不要。测试集 50 题的 100% 很可能是过拟合(4.3 开头提过的陷阱),更健康的信号是"测试集正确率稳定、线上抽查正确率与之接近"。两者差距大说明测试集已偏离真实分布,扩题比调参紧迫。我把小艺的运营目标定在"测试集 90% 上下、线上抽查不低于 85%",为剩余 10% 留出的是"转人工兜底"的合理空间——一个诚实的 90% 比一个虚的 100% 值钱得多。
问题:验收要几个人做,运营能上手吗?
一个人加两小时就能启动,但长期最好双角色分工。造题必须贴近真实用户,客服运营是天然人选(他们脑子里全是用户原话);标注正确分段需要通读文档,搭建者做更高效。我推荐的分工:运营出题,搭建者标注,互相抽查十题校准标注口径。两轮之后标注规则就稳定了——之后运营可以独立扩题,只在拿不准的题上找搭建者确认。验收工具本身没有学习成本,难的是口径一致,而这恰恰只能靠协作练出来。
⚠️ 常见坑:拿测试集调参调到 100% 命中。测试集只有五十题,过拟合它毫无意义——真实流量里的问题分布每天在变。达标线(85%)过了就停手,把精力放到扩大测试集上,让数字持续可信。
💡 关键直觉:验收的本质是把主观争论变成可复现实验。"答得好不好"吵不出结果,"五十题命中四十六"可以指导下一次迭代。
本节要点回顾
- 一个指标:引用正确率 = 命中正确段的题数除以总题数,只测检索层;
- 测试集三覆盖:主问题、口语改写、硬词,加库外题专测阈值拦截;
- 失手三分类:没召回、排名差、库外硬凑,各有专属处方;
- 每轮只动一类旋钮:归因干净比涨得快重要;
- 文档补丁优于参数玄学:同义问法与缺失文档是最高性价比修复;
- 过拟合测试集是隐形陷阱:达标即停,转向扩题。
知识库主线收口:小艺从"凭本能编"进化到"照文档答,句句有出处"。第 5 章换一个维度增强它——确定性流程,工单分类流水线在画布上等着。