4.5 资源配额:泊位吨位与吊装限重
4.5 资源配额:泊位吨位与吊装限重
本节摘要:值班手册最后一页——给每只箱子核定载重。内存与 CPU 配额的参数体系、超限行为的实验验证、配额与重启策略的联动。没有配额的共船环境里,一只失控箱子能拖垮整条业务,这一节是玩具与生产的分水岭。
一只箱子压垮整条船
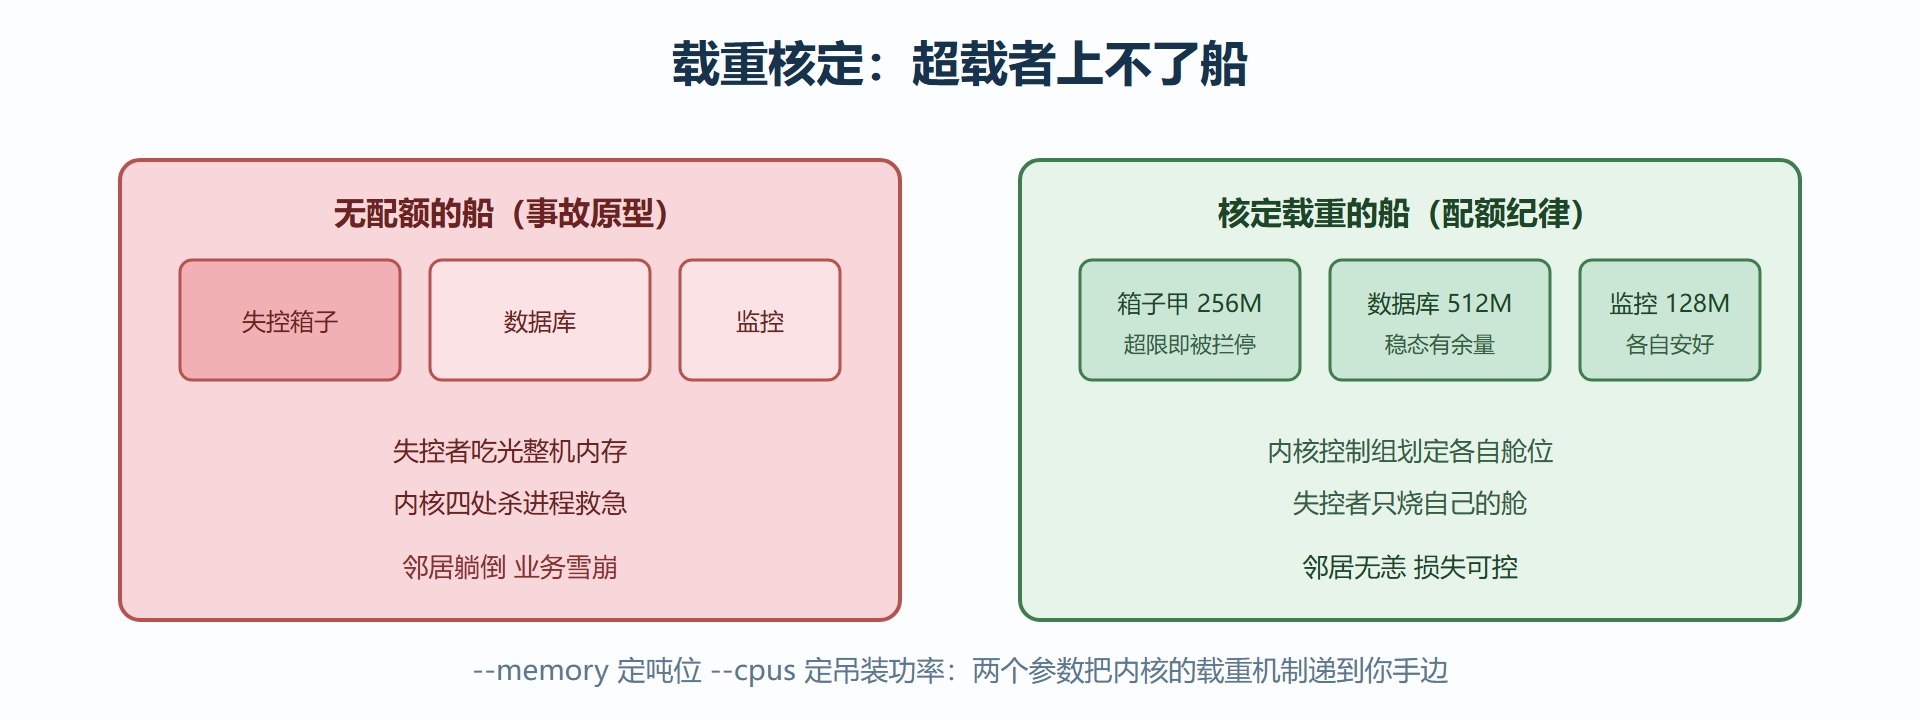
上一节你在 stats 里学会了看体征,本节回答值班手册的最后一问:体征超标之前能不能预防。先看事故原型:凌晨的促销流量让某个应用的内存曲线陡涨——它没配内存上限,内核内存回收又救不了它,宿主机内存被吃穿,内核开始到处杀进程救急;被杀的未必是肇事者,同机的数据库、监控、日志服务纷纷躺下,整条业务链雪崩。事故复盘结论只有一行:所有容器都没配资源上限。
码头的解法老而有效:泊位有吨位上限,吊装有限重,超载的箱子根本上不了船。容器世界对应物是内核的控制组机制——Docker 用两个参数把它递到你手边。先看这两个参数怎么用:
图 4-3:载重核定——配额如何保护整条船
# 起一只核定载重的箱子:内存上限 256MB,可用的 CPU 份额为 1.5 核 docker run -d --name quota-demo \ --memory 256m \ --memory-swap 256m \ --cpus 1.5 \ nginx:1.25-alpine # 核验配额已生效 docker stats --no-stream quota-demo # NAME CPU % MEM USAGE / LIMIT MEM % # quota-demo 0.08% 5.8MiB / 256MiB 2.3% # ^^^^^^^^^^^^ 上限已按核定值显示
内存配额:上限、交换与 OOM
内存参数有两个,语义要分清:--memory 是物理内存上限;--memory-swap 是物理内存加交换空间的总上限。把两者设成相等(如上例都是 256m),意味着禁止用交换——超了就直接终结,绝不用慢速交换拖着。生产服务的常见选择正是这个组合,因为内存型服务一旦落入交换,延迟劣化比重启更伤业务。
超限行为做实验验证。造一个内存怪兽:
# 用一个 Python 小脚本在容器里吃内存(每秒多占 64MB) docker run --rm --name oom-lab --memory 100m --memory-swap 100m \ python:3.12-slim python -c " import time, sys chunks = [] while True: chunks.append(' ' * (64 * 1024 * 1024)) # 每轮多吃 64MB time.sleep(1) " # 容器很快死亡。查它的退出码: docker ps -a --filter name=oom-lab --format "{{.Status}}" # Exited (137) # 137 = 128 + 9:主进程被内核的强制信号终结——OOM 超限的标准遗言 # 引擎记录了详细死因(末尾 OOMKilled 字段为 true) docker inspect oom-lab --format "OOMKilled: {{.State.OOMKilled}} ExitCode: {{.State.ExitCode}}" # OOMKilled: true ExitCode: 137
上一节说"退出码 137 先查内存",来源就在这里。配额加重启策略是标准联动:--memory 核定载重,--restart on-failure 让被 OOM 终结的箱子自动重吊(限次数防连环雪崩),两行参数合起来才是生产姿势。
配多少合适?经验起点:上限设为应用稳态峰值的 1.5 倍左右,留出突发余量又不纵容泄漏。长期逼近上限的箱子(stats 里的 MEM 百分比持续超过八成)要么加额要么查泄漏,放任不管就是等待 OOM 随机应验。
CPU 配额:份额、上限与邻居效应
CPU 侧两个维度:上限(--cpus,硬顶,如 1.5 表示最多用 1.5 个核的算力)与份额(--cpu-shares,软权重,争抢时按比例分配,空闲时 others 可借用)。日常生产主要用 --cpus 硬顶,简单可控:
# 压测对比:无限额 vs 限额 docker run --rm --name cpu-full python:3.12-slim python -c " import time start = time.time() while time.time() - start < 3: pass" & # 空转三秒吃满所有核 # 给 0.5 个核的上限再跑同样的活 docker run --rm --name cpu-half --cpus 0.5 python:3.12-slim python -c " import time start = time.time() while time.time() - start < 3: pass"
用 stats 观察两者的 CPU%:无限额的能冲到宿主机核数乘以百,限额的被死死按在 50% 附近。邻居效应是 CPU 配额存在的核心理由——多租户同机时,未限额的任务在高峰期会挤压邻居,限额保证每家按核定份额吞吐,谁也别想抢跑。
最后给一份值班员配额清单:每只常驻箱子必配内存上限(并设交换等于上限);CPU 上限按业务压测核定而非拍脑袋;配额与重启策略联动(on-failure 限次);stats 百分比纳入监控告警(八成预警);配额变更用 update 热调不必重建:
# 在线调整运行中容器的配额 docker update --memory 512m --memory-swap 512m --cpus 2 quota-demo docker stats --no-stream quota-demo # LIMIT 列已变为 512MiB —— 换档完成,无需断航
清单之外再交代一个高频疑问:配了配额的容器里看 free 命令,内存显示的是宿主机的总量,不是配额值——free 看不到配额,容器并没有被塞一个假的 /proc。正确姿势是永远用 docker stats 看限额与用量,这也是把"体征观察统一到引擎视角"的一个小注脚。同理,容器内看 CPU 核数的一些工具也会报告宿主机核数,个别按核数自旋的并发程序会因此误判并行度——遇到"配了 1 核却开出几十个线程"的应用,就在应用配置里显式指定并发数,别让程序自己猜。
本节要点回顾
- 未配额的共船环境是雪崩温床:一只失控箱子能拖垮同机全部业务。
- 内存上限 --memory,交换总上限 --memory-swap;两者相等即禁交换,生产首选。
- 超限即 OOM:退出码 137、inspect 的 OOMKilled 为 true;配额加限次重启策略是标准联动。
- CPU 配额用 --cpus 硬顶防邻居效应;份额 --cpu-shares 是进阶软调控。
- 经验值:内存设稳态峰值 1.5 倍;八成占用预警;docker update 在线换档。
本章值班手册完结。下一章解决两只箱子怎么互相找到、贵重货怎么不随箱沉没——航道与堆场。