1.3 四大关系库选型对比:SQL Server 与 Oracle、PostgreSQL、MySQL
1.3 四大关系库选型对比:SQL Server 与 Oracle、PostgreSQL、MySQL
本节摘要:选型不是给功能清单打钩,而是把负载特征、预算结构、团队能力与生态绑定放到一起算总账。本节把 SQL Server 与 Oracle、PostgreSQL、MySQL 四款主流关系库在许可成本、生态绑定、高可用体系、方言与工具链五个维度上正面对比,给出典型场景的落点建议,并交代三种最常见的选错型开局。读完后你应能写出一份经得起评审的选型论证。
一个反例开场:省掉的钱,后来加倍还了
某电商创业公司在 2018 年选型时为了省钱选了某开源库,团队没人深用过,凭文档搭了个主从架构。两年后业务进入大促节奏,主从延迟让订单查询反复读到旧数据,DBA 被迫上线各种补偿逻辑,比当初省下的 License 费贵出十倍不止。复盘结论里有一条值得所有人记住:选型的第一输入不是价格,是团队已经有能力把哪款库运维到生产水准。一个被团队熟练驾驭的"次优"数据库,几乎总是优于一个无人精通的"最优"数据库。
五个维度的正面对比
许可与总成本。Oracle 按核计价最贵,附加功能(分区、高级压缩、RAC)逐项另购,总拥有成本常远超预算直觉;SQL Server 也是商业许可,但同档价格通常低于 Oracle,且 Azure Hybrid Benefit 与标准版下沉提供了降本空间;PostgreSQL 与 MySQL 社区版零许可费,成本转移到人力与商业支持订阅上。生态绑定。SQL Server 与微软技术栈(.NET、Windows 域、Power BI、Dynamics)有天然咬合:AD 认证免配置、C Sharp 驱动一等公民、报表直连;Oracle 在大型金融核心与既有存量上无可替代;PostgreSQL 的扩展生态(PostGIS、时序插件、JSON 能力)是它最大的长板;MySQL 占据互联网 Web 场景的存量大头。高可用体系。SQL Server 的 Always On 可用性组与 Oracle RAC 是两套哲学——前者存储共享或分布式副本皆可、故障切换面向数据库组,后者多实例共享存储、读写都横向扩;PostgreSQL 靠流复制加 Patroni 之类的编排件,MySQL 靠主从复制或 InnoDB 集群,两者都需要自己把故障切换的可靠性调到生产级。方言与开发体验。T-SQL 的过程化能力、公用表表达式递归、窗口函数都成熟,SSMS 是公认高效的图形工具;PL/SQL 生态里存量代码深厚;PL/pgSQL 与 MySQL 的 SQL 方言各有取舍,迁移从来不是"改改连接串",方言差异(分页写法、自增列、类型系统、存储过程语法)才是迁移工程量的主体。分析能力。列存储索引让 SQL Server 具备了库内 HTAP 的资本,Oracle 有混合列压缩,PostgreSQL 借助插件与并行查询追赶,MySQL 在纯分析负载上仍是短板。
一张矩阵收拢结论:
| 维度 | SQL Server | Oracle | PostgreSQL | MySQL |
|---|---|---|---|---|
| 许可成本 | 中高,有降本通道 | 最高,按项加购 | 免费,成本在人力 | 免费,成本在人力 |
| 微软栈绑定 | 深度咬合 | 无 | 无 | 无 |
| 高可用成熟度 | Always On 开箱 | RAC 顶级但昂贵 | 需编排件自建 | 主从成熟、集群需投入 |
| 分析负载 | 列存储,库内 HTAP | 强 | 中,靠插件 | 弱 |
| 工具与可运维性 | SSMS 高效统一 | 强大但复杂 | 工具分散 | 工具轻量 |
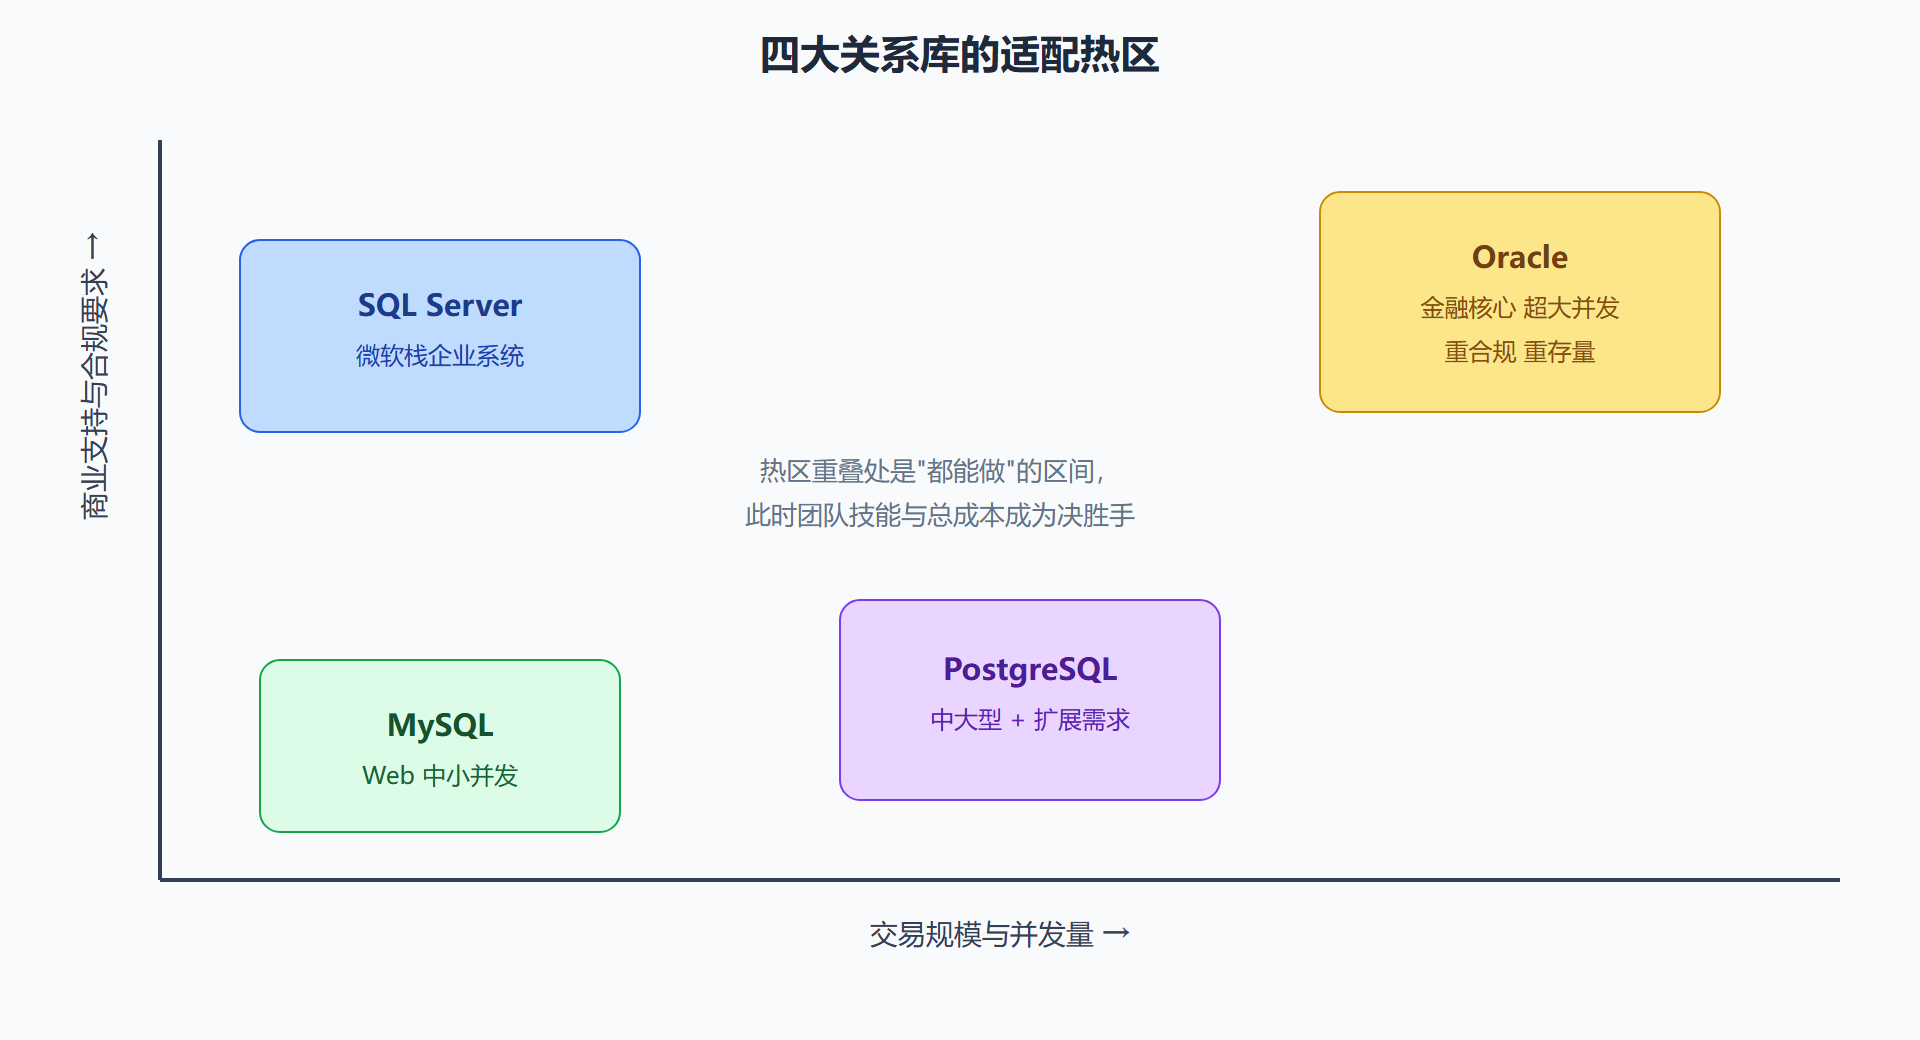
| 典型落点 | 企业 ERP、微软栈业务系统 | 金融核心、超大型 OLTP | 新兴平台、地理与时序 | 互联网 Web、读多写少 |
图 1-3 选型决策矩阵:四库适配热区
从应用场景倒推:三类典型落点
把对比翻译成场景语言。企业内部系统与微软栈业务(ERP、OA、医疗 HIS、制造 MES):SQL Server 是默认正解——域认证、.NET 驱动、SSMS 运维、Power BI 报表形成一条无接缝链路,团队学一套生态就能覆盖全栈。金融核心与超大型交易系统:存量几乎一定是 Oracle,新建系统也常在 Oracle 与分布式中间件之间权衡,SQL Server 在这个区间的竞争力来自 Enterprise 版加 Always On 的性价比组合。互联网 Web 与读多写少的平台:MySQL 与 PostgreSQL 各有天下;若业务带地理信息、时序或复杂 JSON 需求,PostgreSQL 的扩展生态优势明显。混合负载(白天交易、夜里跑批、实时大屏)是 SQL Server 列存储加内存优化的主场,第 9 章会展开 HTAP 的具体玩法。
方言差异用一段代码体会最直接——同样是"存在则更新、不存在则插入":
-- SQL Server:MERGE 或 UPDATE 后判断行数 UPDATE t SET qty = qty + @inc WHERE sku = @sku; IF @@ROWCOUNT = 0 INSERT INTO t (sku, qty) VALUES (@sku, @inc); -- PostgreSQL:一句 upsert -- INSERT INTO t (sku, qty) VALUES (@sku, @inc) -- ON CONFLICT (sku) DO UPDATE SET qty = t.qty + @inc; -- MySQL:一句 replace 语义(注意会重建行) -- REPLACE INTO t (sku, qty) VALUES (@sku, @inc);
三行代码三种语义,迁移工具能改语法,改不了语义——这就是"迁移工程量在方言"的实证。
本节要点回顾
- 选型第一输入是团队驾驭能力:无人精通的"最优"库,生产表现常常不如熟练驾驭的次优库;
- 五个维度算总账:许可成本、生态绑定、高可用体系、方言迁移、分析能力,缺一个维度都可能翻车;
- 三种典型落点:微软栈与企业系统选 SQL Server,金融超大核心多在 Oracle,互联网 Web 在 MySQL 与 PostgreSQL 间权衡;
- 方言是迁移工程主体:upsert 三种写法语义不同,工具改得了语法改不了行为;
- 混合负载是 SQL Server 强区:列存储加内存优化支撑库内 HTAP,白天交易夜里分析不必分家。
选型到此收口。接下来换个视角:不再从外部看产品,而是打开引擎盖——第 2 章钻进实例内部,看架构与资源管理如何决定这台机器的脾气。