5.3 内联汇编与编译器输出的对照实验
5.3 内联汇编与编译器输出的对照实验
本节摘要:当 C 的表达力确实不够时,内联汇编是受控插手的合法通道——但它的语法(输入输出操作数、clobber 声明)处处体现"与编译器合作"的纪律,写错一处就静默出错。本节先讲内联汇编的正确姿势,再设计一组对照实验:同一任务分别用纯 C、内联汇编、手写汇编实现,与编译器 -O2 产物互相比对。读完你能写出不破坏编译器假设的内联汇编,也能用数据回答"这段代码到底值不值得手写"。
实验设计:同一件事的两种写法
先立一个贯穿本节的判断框架。手写汇编的理由清单上,站得住的其实只有三条:编译器真的不会写(特权指令、特殊同步原语)、编译器做得不够好(经过实测的极热点循环)、需要精确控制指令与时序(密码学的常量时间代码)。除此之外的场景,现代编译器在 -O2 的产物已经难被手写击败——这不是信仰,是可以实验验证的命题。本节就用一组对照实验验证它,实验对象选一个"看起来很适合手写"的任务:把 64 位整数按位反转。
// rev.c —— 位反转的朴素 C 版本 uint64_t rev_naive(uint64_t x) { uint64_t r = 0; for (int i = 0; i < 64; i++) { r = (r << 1) | (x & 1); x >>= 1; } return r; }
一、内联汇编的正确姿势
GCC 扩展的内联汇编分基本式与扩展式,工程上只用扩展式——因为它显式声明了与编译器的交接面。先看一个必要场景:读取时间戳计数器(3.3 节的自助清单成员):
static inline uint64_t rdtsc(void) { uint32_t lo, hi; __asm__ volatile ( "rdtsc" : "=a"(lo), "=d"(hi) // 输出:rax 进 lo,rdx 进 hi : : ); // 无输入,无额外破坏 return ((uint64_t)hi << 32) | lo; }
这个例子虽短,扩展语法的全部要素都在:冒号分出的三个区依次是输出操作数、输入操作数、clobber 声明;=a 的 a 表示绑定 rax 寄存器,引号里的 lo 表示"把 rax 的值交给 C 变量 lo"。clobber 声明是纪律的核心:你的汇编代码破坏了哪些寄存器(没通过输出区登记的),必须在第三区如实申报,否则编译器可能正把重要变量放在那里面——破坏而不申报,症状是程序隔三差五算错,且极难复现排查。volatile 修饰则告诉编译器"这段有副作用,不许删、不许挪"。
常见错误清单值得预演一遍:忘了申报 clobber(静默出错)、把输入寄存器当输出用(应写成读写约束 "+r")、在内联汇编里假设某个固定寄存器空闲(rbx 一类非易失寄存器由编译器调度,要用必须申报)。内联汇编的每条语法都有它的"为什么",而"为什么"全部指向同一句话:你在别人的地盘上施工,动过的东西要登记。
二、对照实验:三种写法,三个产物
回到位反转任务,用三种写法各走一遍。写法一,上面的朴素 C;写法二,内联汇编逐位循环(比 C 版多不了什么好处,主要演示写法);写法三,查指令手册后的"作弊"——x86 有专门的位反转指令 ror 配合 movbe?其实没有直接的单条位反转,但编译器知道一个经典技巧:位分治交换(先交换相邻位、再交换相邻 2 位、依次类推,五步完成 64 位反转)。不用手写,先看 -O2 产物里 rev_naive 被编译器改写成了什么:
$ gcc -O2 -S -masm=intel rev.c rev_naive: mov rax, rdi mov r9, 0x5555555555555555 ; 掩码 0101... mov r8, 0x3333333333333333 ; 掩码 0011... ...(省略若干行) ; 编译器把 64 次循环整体替换成 5 步位分治: ; 相邻位交换 -> 相邻2位 -> 相邻4位 -> 相邻8位 -> ... ret
产物令人服气:编译器识别出"逐位反转"这个高级语义,直接把 64 次迭代的循环替换成固定五步的位分治——循环彻底消失。手写汇编想赢它,唯一的路是你恰好知道同一个位分治算法并写出等价代码;而"知道算法"这件事 C 版本同样受益:把位分治直接写成 C,产物同样最优。三种写法的对照结果汇总:
| 实现方式 | 产物形态 | 结论 |
|---|---|---|
| 朴素 C,-O0 | 64 次循环直译 | 基准,慢 |
| 朴素 C,-O2 | 5 步位分治,无循环 | 编译器已替你手写完毕 |
| 内联汇编位循环 | 你写的 64 次循环原样保留 | 比编译器慢——它不许被优化 |
第三行的结论最扎心也最有教育意义:内联汇编对编译器是黑盒,编译器的一切本领(寄存器分配、指令选择、向量化)对它全部失效。你写内联汇编,等于主动放弃优化。所以正确顺序永远是:先写 C 看产物,产物不满意再查是否用了编译器不认识的算法,最后才考虑手写——而且手写的对象应该是"更聪明的算法",而不是"更用力的循环"。
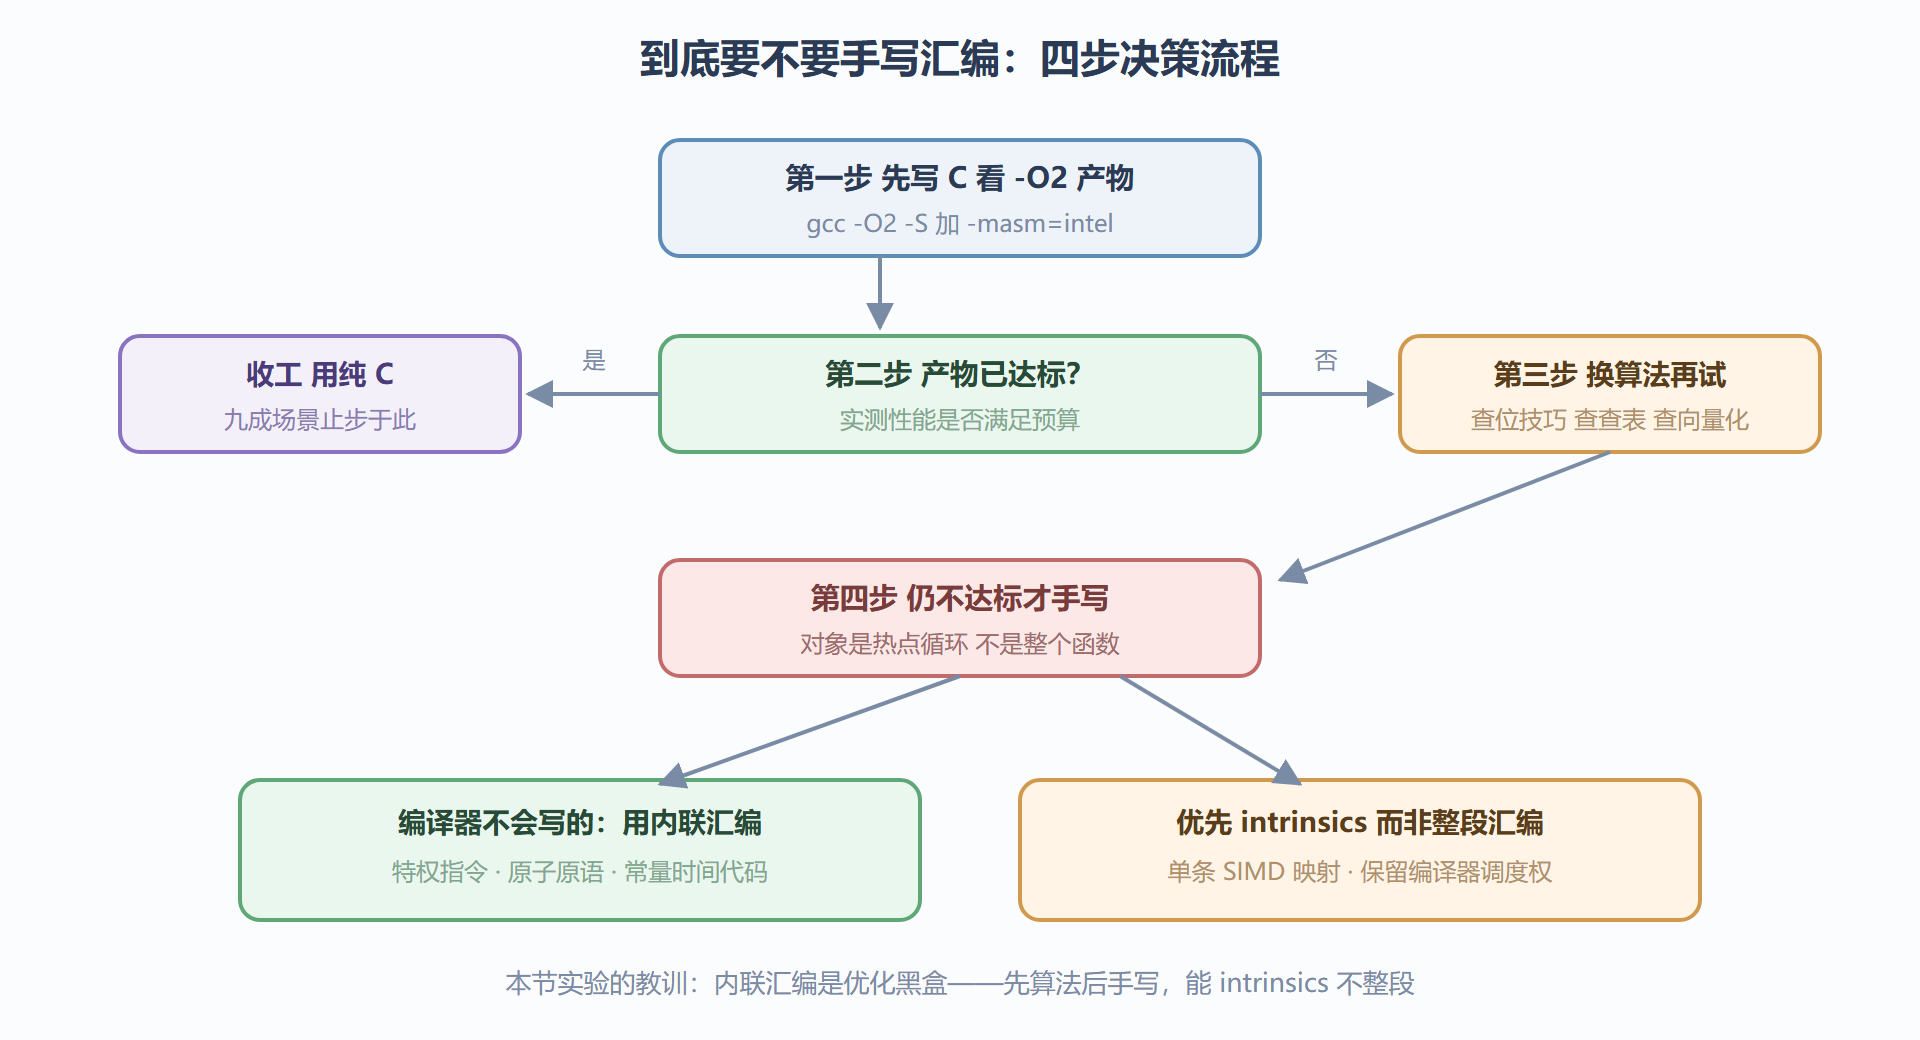
图 5-2:手写决策的对照流程
三、内联汇编的正当阵地
把"什么时候真的该写"说透。第一类,编译器无法表达的指令:cpuid、rdtsc、栅栏、原子原语的历史写法——这些在 intrinsics 普及前只能内联汇编,如今多数有了编译器内建函数,但读老代码必须认识。第二类,常量时间要求:密码学代码必须保证执行路径与数据无关,编译器的分支优化恰恰会破坏这一点(它爱把分支变条件传送或反过来),关键路径上手写汇编是精确控制的手段。第三类,教学与逆向验证:想知道"某段逻辑最短能写几条指令"时,内联汇编是最快的实验台。
第一类之外的共同底色是"少写":内联汇编块每多一行,可移植性、可读性、可优化性各掉一档。工程实践里它应当像辣椒——提味即可,不能当主菜。
⚠️ 常见坑:以为加了 volatile 与 memory clobber 就万事大吉。memory clobber 声明"内存可能被改动",能让编译器放弃跨语句的内存缓存,但代价是大范围优化失效——它是原子操作的必需品,也是滥用者手里的大杀器。申报范围与实际破坏范围严格对齐,才不伤及无辜优化。
💡 关键直觉:内联汇编不是"用汇编语言写 C",而是"向编译器精确申报一段它不理解的黑盒"。申报得越完整(输入、输出、破坏清单),编译器越能在黑盒周围正常工作;申报偷懒,出的是最难查的静默错。
本节要点回顾
- 扩展式内联汇编三区:输出、输入、clobber,clobber 申报是与编译器合作的纪律底线。
- 内联汇编是优化黑盒:编译器的一切本领对它失效,手写前先确认编译器真的不行。
- 决策四步:看产物、验性能、换算法、最后才手写;能 intrinsics 不整段。
- 正当阵地:编译器不认识的指令、常量时间代码、教学实验——之外的场景优先纯 C。
三个视角的对照训练完成:读产物、懂契约、会插手。下一章把这些能力投进真实战场——性能、调试与系统边界的现场。