1.3 一条指令的一生:从取指到写回
1.3 一条指令的一生:从取指到写回
本节摘要:以一条加法指令为主角,完整追踪它从内存进入处理器、经过取指、译码、执行、访存、写回五级通路的全程,并顺路交代访存指令与分支指令各自在哪里偏离这条"标准路径"。这一节建立的心智模型,是第六章流水线与冒险分析的底图。
在调试器里停下来的一瞬
设想你正盯着调试器单步调试一段汇编:屏幕上高亮着一条 add 指令,寄存器窗口里 a0 的值即将改变。你按下单步键的瞬间,芯片内部其实有一整条流水线的工人同时开工——你现在看到的这条 add 正在执行级,它前面还有几条指令在译码和取指,后面刚写回的结果正流回寄存器堆。要把这套并发的图景在脑子里装起来,最好的办法就是跟着一条指令,把它的一生完整走一遍。本节就做这件事:以 RV32I 的 add 为干线,途中在访存指令和分支指令两个岔路上各绕行一次。
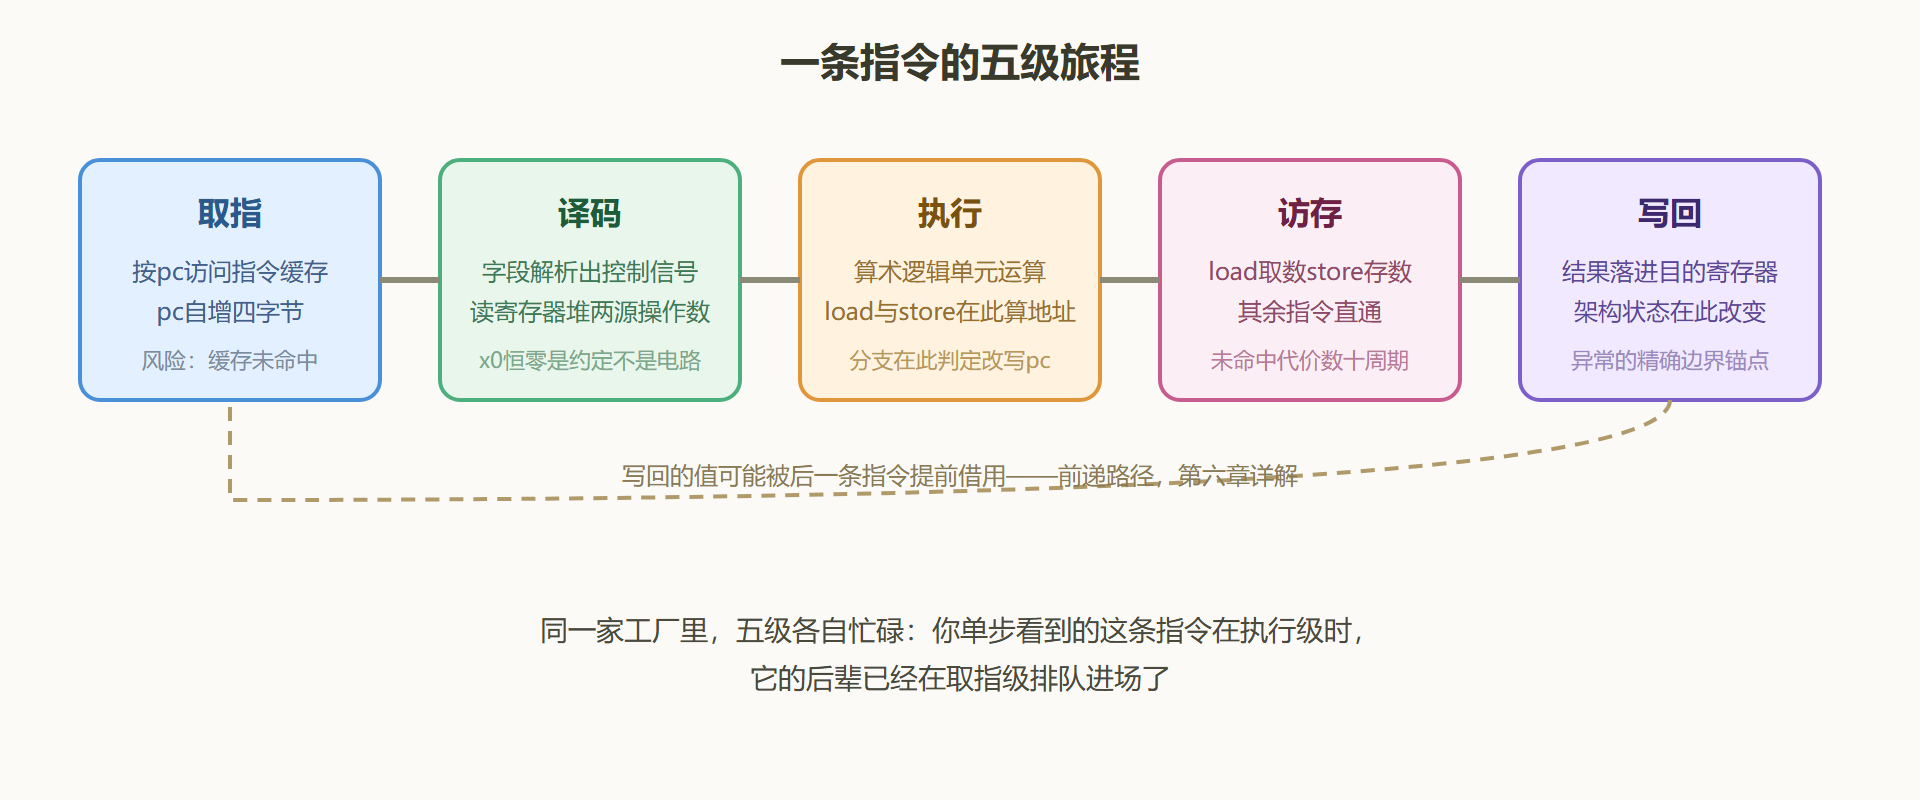
取指:一切从地址开始
处理器里有个叫程序计数器的寄存器(RISC-V 里叫 pc),它保存着下一条待取指令的地址。取指级做的事只有一件:拿着这个地址去指令存储器(通常是指令缓存)里把三十二个比特读回来,同时把 pc 加四指向下一条。定长编码的好处在这里兑现——取指器不用猜测边界,pc 加四永远正确,除非这条指令是分支或跳转。如果指令缓存未命中,请求会落到下一级存储,等待周期以十为单位计,流水线前端随之停摆;这就是为什么指令缓存的命中率对性能如此敏感。
RISC-V 规范在这里有一个容易忽略的细节:pc 的最低两位恒为零,因为指令必须按四字节对齐;启用 C 压缩扩展后对齐要求放宽到两字节,但 spec 仍然要求短指令可以按两字节边界自由混排,硬件在取指时用半字对齐的方式抓回一组比特,再由译码器判断第一个指令是十六位还是三十二位。这个设计让编译器不用插入填充字节,密度与简单性两头都占了。
译码与读寄存器:比特如何变成控制信号
取回的三十二个比特是死的,译码级把它们翻译成活的控制信号。RISC-V 的六种指令格式(第二章会逐位拆解)在字段排布上做了精心的对齐设计:无论哪种格式,源寄存器字段总是固定在相同的比特位置。这让译码器不用等格式判断完成就能提前把寄存器编号抽出来,寄存器堆的读操作因此可以与译码并行,省出一个关键路径周期。
对 add 这条指令,译码器解析出:操作类型是寄存器加法,源寄存器是 rs1 与 rs2 编号指向的两个单元,目的寄存器是 rd 编号。随后寄存器堆被读出两个三十二位的值。顺带一提 x0 这个特殊单元:规范规定它永远读出零、写入被丢弃,于是"清零"这个高频操作不需要任何专用电路,把它当成普通加法即可——add 的目的寄存器写 x0,等价于一条 nop。这种"用约定消灭电路"的思路贯穿整个 RISC-V 设计。
执行与访存:岔路在这里分开
执行级是算术逻辑单元的主场。add 在这里完成两个操作数的加法,一个周期出结果。但如果你追踪的是 lw(从内存加载一个字)指令,执行级的任务就变成了地址计算——把基址寄存器与指令里的立即数偏移相加,得到有效地址;真正去数据存储器取数是下一级的事。如果是 beq(相等则分支)这类指令,执行级比较两个操作数,决定分支是否成立;一旦成立,pc 要被改写为分支目标,此前顺着旧 pc 取进流水线的后续指令全部作废——这就是分支冲刷,它让分支指令的"实际代价"从一级膨胀到十几级(取决于流水线深度与预测机制),第六章会专门算这笔账。
访存级只对 load 与 store 有意义:lw 拿着执行级算好的地址访问数据缓存,命中的话一个周期拿到数据;未命中则要穿透整个存储层级,等待时间从十几个周期到几百个周期不等,此时整条流水线通常都要为它让路。store 指令反向操作,把寄存器的值写进缓存。非访存指令在这一级直接直通,什么也不做。
写回与退役:结果落袋为安
最后一级把执行结果(或访存级取回的数据)写回寄存器堆的目标单元。到这里,一条 add 才算真正"发生"——在写回完成之前,架构状态(程序员可见的寄存器与内存)没有任何改变。这个细节在异常处理里极为重要:如果一条指令在执行中途遇到中断,处理器必须保证它要么完整执行完,要么看起来从未开始,不能留半个结果悬在半空。精确定义"指令何时生效",正是第三章陷入机制的基石。
图 1-4 五级数据通路标注图
工程现场:一条循环的全程追踪
背景:下面这段 RISC-V 汇编来自一个数组求和循环的内层,我们用它演练五级模型的用法。
# a0 指向数组首元素, a1 为剩余元素个数, t0 累加器 loop: lw t1, 0(a0) # 从内存取一个字 add t0, t0, t1 # 累加 addi a0, a0, 4 # 指针前进一个字 addi a1, a1, -1 # 计数器递减 bnez a1, loop # 未完则回到 loop
操作:在纸上(或用教学模拟器)逐周期排布这五条指令进入流水线的次序,标注每条指令在各周期所处的级。你会看到第三周期起,五条指令同时分布在五级里;随后立即撞上第一个问题:add 需要 t1,而 t1 要等 lw 走完访存级才有值。
结果:流水线必须在前递通路就位时把访存结果直接从访存级转交给执行级,否则插入一个周期的停顿。分支 bnez 则在执行级才揭晓方向,揭晓前的两条新取指指令若猜错方向就要作废。
解读:这个小实验揭示了真实处理器性能的两大来源:数据冒险靠前递电路消化,控制冒险靠分支预测消化——两者都不改变"指令何时生效"的架构语义,只是把等待时间藏进硬件。这也解释了为什么同一份代码在不同微架构上跑出不同速度,而结果完全一致:契约只约束结果,不约束过程。
变式:把 lw 换成 sw(存储),追踪它在访存级的行为差异——它带进去的是寄存器值而非取回数据;再把循环体放大到访存模式不连续的场景,观察缓存未命中如何让访存级成为瓶颈。这两个变式分别通往第四章的存储层级与第六章的微架构优化。
本节要点回顾
- 取指级:pc 驱动、定长编码让 pc 加四恒真,压缩扩展只把对齐放宽到两字节;
- 译码级:字段位置跨格式对齐,寄存器读取可与译码并行;x0 恒零是靠约定省电路的典范;
- 执行级:算术在此完成,访存指令在此算地址,分支在此裁决方向并可能引发冲刷;
- 访存级:只有 load 与 store 停留,缓存未命中的代价从十几到几百周期,是性能的头号变量;
- 写回级:架构状态在此刻才改变,这个精确边界是理解异常与中断语义的钥匙。
五级通路是第一张底图。下一章我们回到规范文本,把这张底图上流动的东西——寄存器与指令编码——逐位拆开看清楚。