4.4 一次启动链路雪崩的复盘
4.4 一次启动链路雪崩的复盘
本节摘要:这是本章的实战收束:一次真实的启动链路雪崩——起因是一个参数名拼错,表象却是"导航整体瘫痪",中间还夹着静默降级与误导性日志。本节按背景、操作、结果、解读、变式完整复盘,把 4.1 的生命周期、4.2 的组合形态、4.3 的 Launch 事件放进同一个排障现场。读完它,你应当能把"系统起不来"这类问题的排查时间从小时级压到分钟级。
为什么启动故障最消耗士气
单节点故障症状集中,好查;启动故障恰好相反——它的表象在下游,病灶在上游,中间隔着整条链路的时序与依赖。更要命的是启动故障高发于演示与交付前夕,心理压力放大每一个误判。本节案例就是一次交付前夜的雪崩,复盘它比多看十个 happy path 更有价值。
一、背景:交付前夜的"导航瘫痪"
现场是仓储物流机器人交付的前一晚。改动只有一处:把识别节点的置信度阈值从参数文件里的 confidence 改名为 min_conf(觉得原名太长)。改完重新启动 bringup,现象如下:RViz 里地图正常、机器人位姿正常,但点不到导航目标——点击后机器人毫无反应;终端里 planner_server 偶尔打印"等待代价地图更新";控制节点安静得反常。团队的第一反应是导航栈被那次"无害改名"弄坏了什么,开始回滚代码。
回滚是这起事故里最大的时间黑洞。改名确实无害,问题出在另一处连锁反应上。复盘如下。
二、操作:沿依赖图从断点向上游排查
第一步,确认故障边界:什么活着,什么死了。 打开终端批量查询生命周期状态——这一步的前提是系统用了 4.1 的生命周期语义,否则"活着"与"就绪"根本无法区分:
for n in map_server amcl planner_server controller_server bt_navigator; do echo -n "$n: "; ros2 lifecycle get /$n done # map_server: active # amcl: active # planner_server: inactive ← 断点显形 # controller_server: inactive # bt_navigator: inactive
地图与定位活着,规划之后的整段不活动。断点在 planner_server 附近,但它自己为什么不活动,还要继续问。
第二步,看编排者的日志,而不是看业务节点。 lifecycle_manager 的日志是这次排查的关键证据:
[lifecycle_manager]: Managed nodes are ready... 1/5 [lifecycle_manager]: Failed to change state for node: planner_server [lifecycle_manager]: configure of planner_server timed out after 20 sec
管理器明说了:planner_server 的 configure 迁移超时。对照 4.1 节的语义——configure 超时说明 on_configure 回调没有返回,节点卡在了配置阶段。
第三步,单独拉起 planner_server 复现,缩小输入变量。 脱离整个 bringup,只起 planner_server 与它的参数文件:
ros2 run nav2_planner planner_server --ros-args \ --params-file nav2_params.yaml # 日志 # [planner_server]: Configuring # [planner_server]: Parameter not declared: min_conf # 之后卡住,不再输出
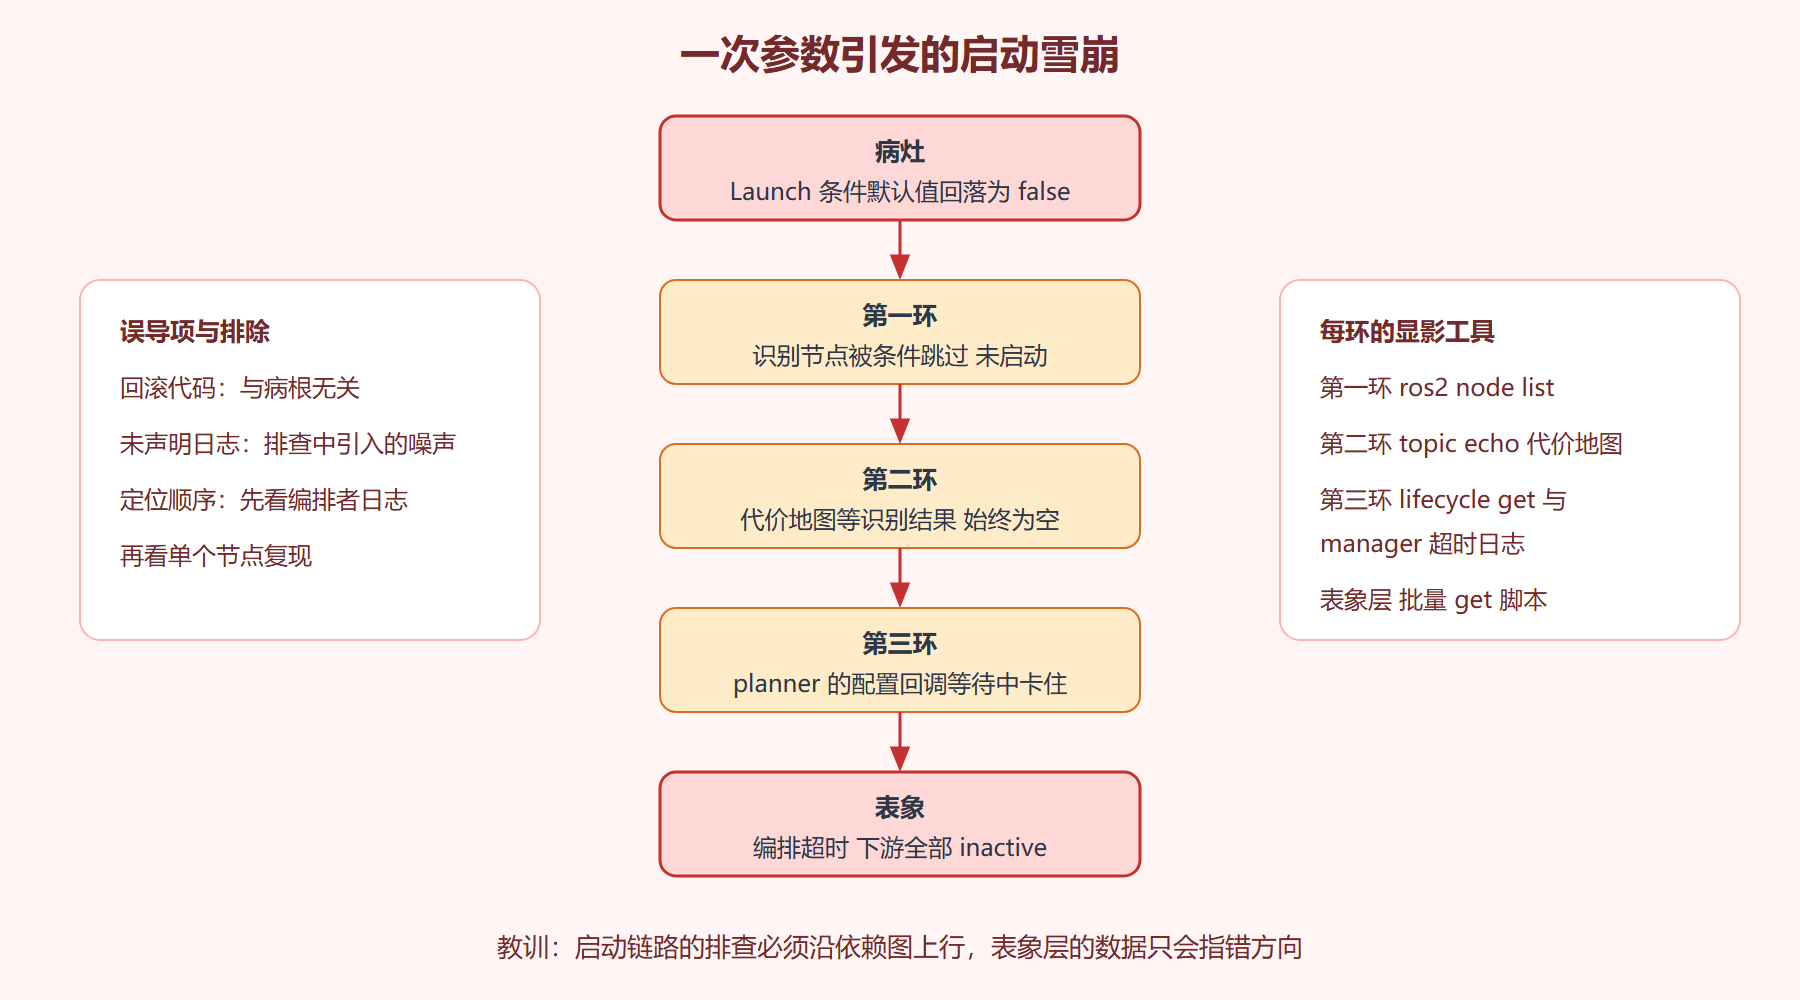
有意思的误导出现了:日志里那句"Parameter not declared: min_conf"其实不是病根——那是我自己排查时随手加的一个参数,它只是被拒绝而已。真正卡住的原因要往下挖:planner_server 的 on_configure 里有一个"等待上游代价地图话题首帧"的逻辑,而代价地图的配置引用了识别节点的输出话题,识别节点根本没被拉起来——它在 Launch 的条件判断里被跳过了。
第四步,回到 Launch 文件,真相大白。 交接的同事为了"先跑通导航",把识别节点的启动包在了一个 IfCondition 里,条件变量的默认值是 false;此前有人把默认值临时改成了 true,而我前一天整理 Launch 文件时"清理"了这行DeclareLaunchArgument,条件求值回落到 false。识别节点静默地没启动,代价地图永远等不到识别结果,planner_server 的 configure 永远等不到代价地图,编排者在 20 秒超时后放弃,下游全部停在 inactive。
图 4-3:雪崩链路与断点定位
三、结果与解读
修复动作本身只要一行:把 DeclareLaunchArgument 加回去、默认值定为 true,并在交付检查单里补上"Launch 变更必须在仿真里过一遍全链路启动"。整个排障耗时约五十分钟,其中四十分钟花在最初十分钟错误的回滚方向上。
解读这笔账,三条经验可以直接迁移。第一,先画依赖图再动手查。 这条链路的依赖是"识别输出、代价地图、规划器、控制器"的串行链,批量 lifecycle get 一打出来,断点位置一眼可见;没有依赖图时,人天然地从表象最近的地方开始瞎摸。第二,编排者的日志优先于业务节点的日志。 lifecycle_manager 的超时信息直接告诉你"哪个迁移没完成",比在十几个节点的输出里大海捞针快得多——这是生命周期语义送给排障者的礼物,普通节点连"卡在配置阶段"这个概念都无法表达。第三,静默跳过是最危险的启动行为。 IfCondition 跳过一个节点不产生任何日志,事后也没有任何机制提醒你少了谁。对策是给关键节点加存在性检查:编排脚本或 Launch 事件里,对"系统不可缺席"的节点清单做 node list 核对,缺席即报警。
四、变式:雪崩的另外三种起法
变式一:硬件型雪崩。 传感器驱动 configure 时硬件自检失败(线松了、供电不足),同一条链路同样断在 configure。鉴别点在驱动的 on_configure 日志——硬件型故障在那里会留下明确证据。预防靠 4.1 说的重试策略。
变式二:时序型雪崩。 某节点不用生命周期,启动后前几秒"数据还没准备好"就开始消费,拿到空数据做出错误决策。它不表现为起不来,而表现为"刚启动那几分钟行为诡异"。解法是把这个节点纳入生命周期管理,或订阅端用 deadline 检测数据健康。
变式三:资源型雪崩。 组合容器里某个组件初始化吃掉过多内存,同容器的其他组件初始化失败,表象是"随机某个节点 configure 失败"——每次还不同。多发生在内存紧张的嵌入式板子上。鉴别手段是把组件拆出容器单独跑;若单独跑正常,组合容器本身就是嫌疑人。
💡 关键直觉:启动故障排查的第一问永远是"断点在哪一环",而不是"谁写错了代码"。断点找到,病因通常自己浮出来;跳过断点直接猜代码,每一次猜测都是新的歧途。
本节要点回顾
- 沿依赖图上行排查:批量查生命周期状态先找断点,再向上游找病因;
- 编排者日志是第一证据:lifecycle_manager 的超时记录直接指认卡住的迁移;
- 静默跳过要设防:条件启动的关键节点需要存在性检查兜底;
- 生命周期语义把"卡在配置"变成可观测事件,这是采用它的排障红利;
- 三类常见雪崩:硬件型、时序型、资源型,鉴别入口都在 configure 阶段的日志。
启动的问题到此收束。下一章转向机器人的空间认知:模型怎么建、坐标怎么对齐——那是另一类经典事故的舞台。