4.4 动手实验:SystemVerilog搭一颗最小SoC
4.4 动手实验:SystemVerilog 搭一颗最小 SoC
前三节讲的是"项目怎么跑",本节亲手跑一遍。实验目标只有一个:用两百行左右的 SystemVerilog,从空目录搭出一颗有处理器桩、总线、存储、串口的最小 SoC,让它在仿真器里向控制台打出字符。这个实验是 CK770 台账的微缩模型——2.1 节的核与加速器、2.2 节的存储、2.3 节的互连事务,都会在这两百行里现出雏形。任何一个开源仿真器都能跑通本节全部代码。
实验目标:让一根 LED 在仿真里亮起来
真实 SoC 的"点亮"标志是串口打出第一行字,实验照搬这个仪式:处理器桩从指令存储里取一段小程序,程序往串口寄存器写几个字符,串口模块把字符送到仿真控制台。麻雀虽小,五脏与真 SoC 一一对应:指令与数据走同一根总线、存储有物理地址译码、外设靠寄存器语义对话——4.2 节的编码纪律、2.3 节的事务模型,全部要在代码里兑现。
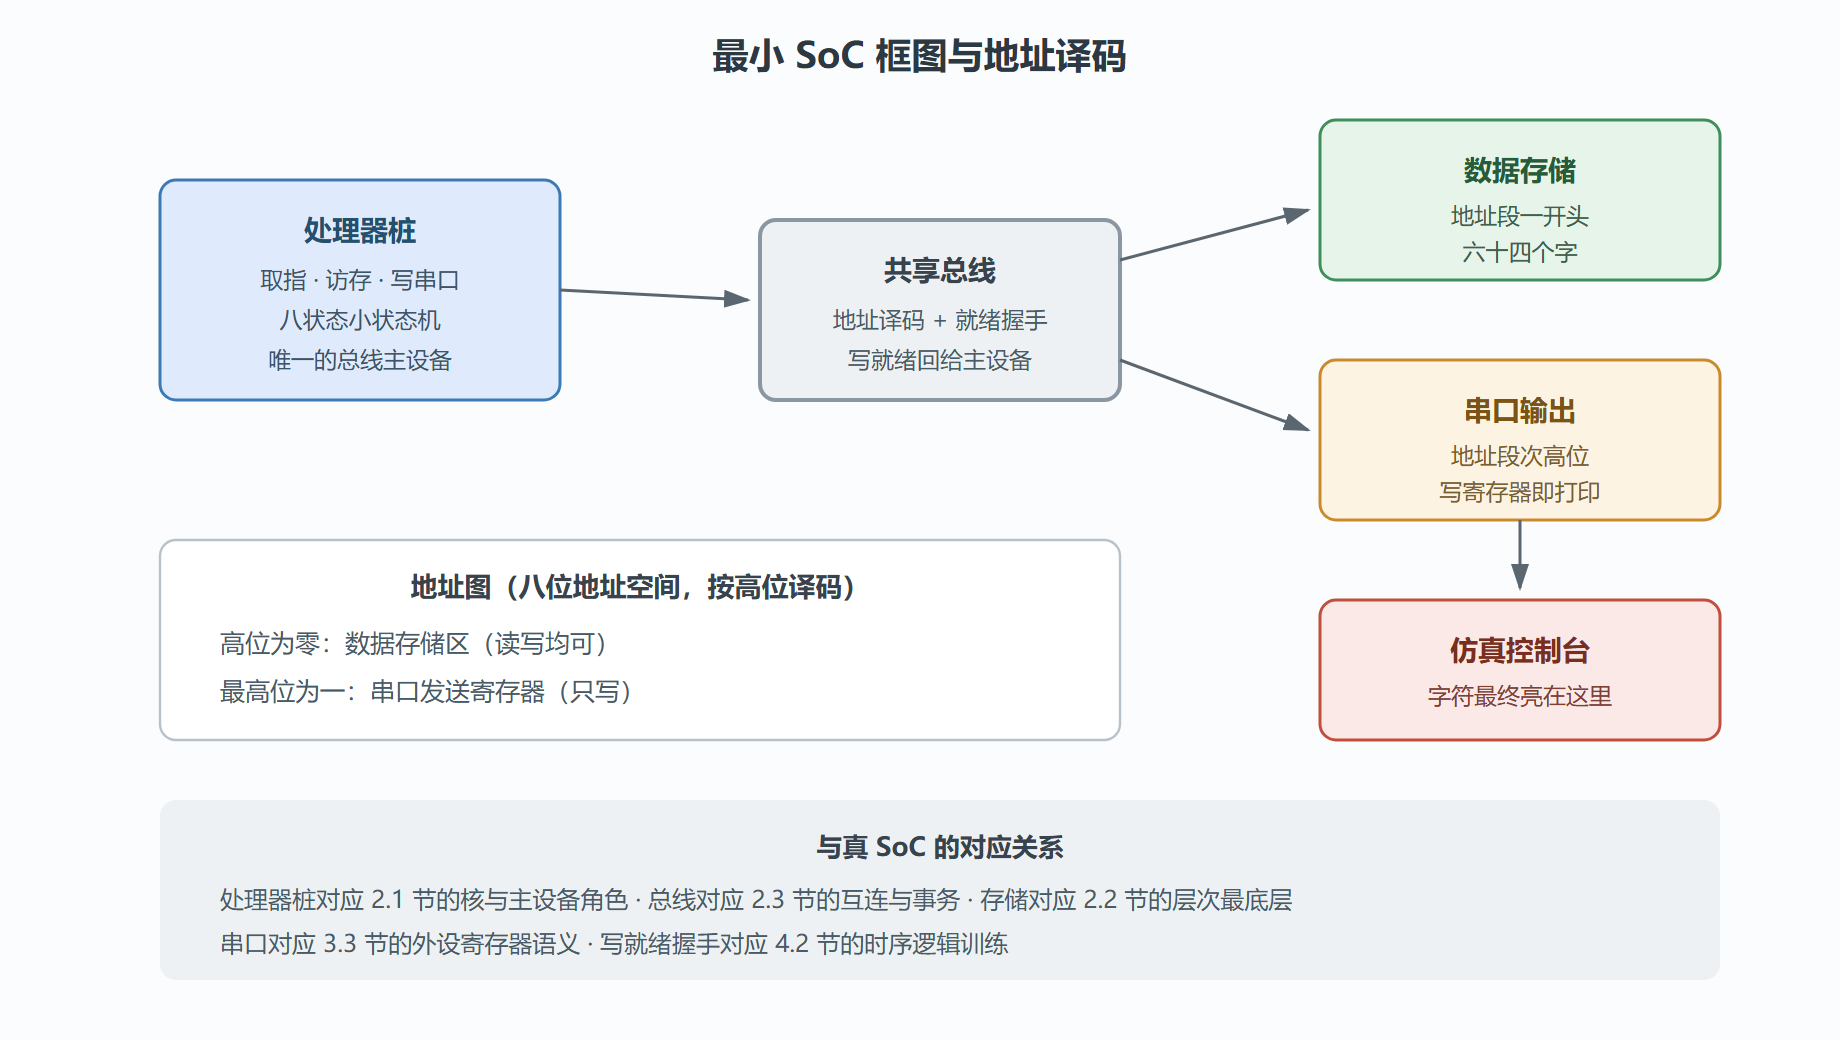
先看图纸。最小 SoC 四个部件:处理器桩不是真核,是个会取指、会访存的小状态机,替真核扮演"总线主设备"这个角色;总线是带固定优先级仲裁与地址译码的共享通路;数据存储挂在中段地址;串口挂高位地址,写寄存器即输出。地址图与 2.2 节的层次思想同源——只是把金字塔压扁成了两层。
图:最小 SoC 的部件与地址图
动手:五个模块的实现
代码分五个小块,全部遵循 4.2 节纪律:时序组合分块、复位完整、位宽显式。先写总线与译码——这是整个系统的骨架。
// 总线:简单共享总线,固定优先级(本实验只有一个主设备,接口留了仲裁扩展位) module minibus ( input logic clk, input logic rst_n, // 主设备侧:请求与握手 input logic req, // 请求有效 input logic we, // 写使能 input logic [7:0] addr, input logic [7:0] wdata, output logic ready, // 从设备应答 output logic [7:0] rdata, // 存储从设备 output logic ram_cs, output logic ram_we, output logic [5:0] ram_addr, output logic [7:0] ram_wdata, input logic [7:0] ram_rdata, // 串口从设备 output logic uart_cs, output logic [7:0] uart_wdata ); // 地址译码:最高位选串口,其余选存储(组合逻辑,穿过即算) always_comb begin uart_cs = req & addr[7]; ram_cs = req & ~addr[7]; end assign ram_we = ram_cs & we; assign ram_addr = addr[5:0]; // 显式截断,注释说明:存储只有六十四字 assign ram_wdata = wdata; assign uart_wdata = wdata; // 读数据与应答:打一拍再回,模拟真实从设备的响应延迟(时序逻辑) always_ff @(posedge clk or negedge rst_n) begin if (!rst_n) begin ready <= 1'b0; rdata <= 8'd0; end else begin ready <= req; // 一拍延迟应答 rdata <= ram_rdata; end end endmodule
接着是处理器桩。它不改写存储,只做四件事:从固化的指令表取指令、执行"写存储""写串口""停机"三种操作、通过握手等应答。指令表用初始块装入——记住 4.2 节的警告,这种写法只属于仿真环境,真实芯片的指令在 3.3 节的启动存储里。
// 处理器桩:八状态取指执行机 module cpu_stub ( input logic clk, input logic rst_n, output logic req, output logic we, output logic [7:0] addr, output logic [7:0] wdata, input logic ready ); // 小程序:往存储写两个数,再往串口写 'O' 'K',最后停机 logic [15:0] prog [0:5]; initial begin prog[0] = {1'b1, 1'b1, 8'h10, 6'd00, 8'hA7}; // 写存储 10 号:数值 A7 prog[1] = {1'b1, 1'b1, 8'h11, 6'd00, 8'h3C}; // 写存储 11 号:数值 3C prog[2] = {1'b1, 1'b1, 8'h80, 6'd00, 8'h4F}; // 写串口:字符 O prog[3] = {1'b1, 1'b1, 8'h80, 6'd00, 8'h4B}; // 写串口:字符 K prog[4] = {1'b0, 1'b0, 8'h00, 6'd00, 8'h00}; // 停机 prog[5] = {1'b0, 1'b0, 8'h00, 6'd00, 8'h00}; end typedef enum logic [2:0] {FEATCH, ISSUE, WAITR, ADVANC, HALTED} state_t; state_t state, nstate; logic [2:0] pc; // 状态寄存与计数(时序) always_ff @(posedge clk or negedge rst_n) begin if (!rst_n) begin state <= FEATCH; pc <= 3'd0; end else begin state <= nstate; if (state == ADVANC) pc <= pc + 3'd1; end end // 输出与状态转移(组合) always_comb begin req = 1'b0; we = prog[pc][15]; addr = prog[pc][14:7]; wdata = prog[pc][7:0]; nstate = state; unique case (state) FEATCH: nstate = (prog[pc][15] == 1'b1) ? ISSUE : HALTED; // 空指令视为停机 ISSUE : begin req = 1'b1; nstate = WAITR; end WAITR : begin req = 1'b1; nstate = ready ? ADVANC : WAITR; end // 等从设备应答 ADVANC: nstate = FEATCH; HALTED: nstate = HALTED; endcase end endmodule
存储与串口都极短。存储是六十四字的触发器阵列加写使能;串口更简单——被选中且总线写到达时,把字符打到仿真控制台,再把"已发送"回给总线。
// 数据存储:六十四字 module ram64 ( input logic clk, input logic cs, input logic we, input logic [5:0] addr, input logic [7:0] wdata, output logic [7:0] rdata ); logic [7:0] mem [0:63]; always_ff @(posedge clk) begin if (cs & we) mem[addr] <= wdata; // 写在时钟沿发生 if (cs) rdata <= mem[addr]; end endmodule // 串口输出:写寄存器即打印(仿真环境用系统任务输出) module uart_out ( input logic clk, input logic cs, input logic [7:0] wdata ); always_ff @(posedge clk) begin if (cs) $write("%c", wdata); // 仅仿真可用,真实芯片这里换成移位寄存器与发送线 end endmodule
顶层把四件套接起来,再加测试平台产生时钟与复位:
// 顶层与测试平台 module soc_mini ( input logic clk, input logic rst_n ); logic req, we, ready; logic [7:0] addr, wdata, rdata; logic ram_cs, ram_we, uart_cs; logic [5:0] ram_addr; logic [7:0] ram_wdata, ram_rdata, uart_wdata; cpu_stub u_cpu (.clk(clk), .rst_n(rst_n), .req(req), .we(we), .addr(addr), .wdata(wdata), .ready(ready)); minibus u_bus (.clk(clk), .rst_n(rst_n), .req(req), .we(we), .addr(addr), .wdata(wdata), .ready(ready), .rdata(rdata), .ram_cs(ram_cs), .ram_we(ram_we), .ram_addr(ram_addr), .ram_wdata(ram_wdata), .ram_rdata(ram_rdata), .uart_cs(uart_cs), .uart_wdata(uart_wdata)); ram64 u_ram (.clk(clk), .cs(ram_cs), .we(ram_we), .addr(ram_addr), .wdata(ram_wdata), .rdata(ram_rdata)); uart_out u_uart(.clk(clk), .cs(uart_cs), .wdata(uart_wdata)); endmodule module tb; logic clk = 0, rst_n = 0; always #5 clk = ~clk; // 周期十个时间单位 soc_mini u_soc (.clk(clk), .rst_n(rst_n)); initial begin #23 rst_n = 1; // 异步释放复位,避开时钟沿 #500 $display("\n仿真结束"); $finish; end endmodule
一次读事务在总线上的完整时序,值得用图单独看一遍——它是 2.3 节"事务"概念的最小实现:
结果与解读
代码就绪后在仿真器里编译运行,控制台应打出两个字符并结束:
OK 仿真结束
跑通之后别急着关窗口,做三件复盘。对照 2.3 节:WAITR 状态里的握手就是"事务"的最小形态——请求、应答、前进,真实总线的一切协议都长在这个骨架上。对照 4.2 节:三个 always 块分别负责状态、转移与输出,归类清晰;ram_addr 的截断写了注释说明;unique case 让遗漏分支在仿真里立刻报错。找茬练习:把 ready 的一拍应答改成零拍(组合直通),仿真多半照跑,但综合报告会多出一条穿全场的组合路径——4.3 节的时序表立刻给出颜色。这三次复盘做完,前三节的原理就算真正过手了。
再留一个观察点:cpu_stub 里指令表的执行顺序完全由状态机推进,没有程序计数器溢出保护——若程序表末尾不是停机指令,pc 会回卷重新执行。真实处理器的取指边界检查、异常入口,本质上都是给这个骨架补的"防御性状态"。最小实验的价值就在这里:所有复杂系统都是这个骨架的加厚版,骨架在手,加厚只是工作量问题。
变式练习
三个递进变式,难度递增。变式一:给总线加第二个主设备(一个自动搬存储数据到串口的直接访存引擎),实现固定优先级仲裁——你会立刻遇到 2.3 节的问题:两个主设备同时请求,谁先走?被压制的那个怎么办?变式二:把串口模块的发送改成两拍延迟,观察处理器桩的行为是否依然正确——答案取决于握手是否严格按应答推进,这正是 4.2 节"别依赖他人延迟"纪律的实验版。变式三:把串口时钟改成两分频,给跨域路径加同步器——做完它,5.3 节的排错实录你已经有预习了。
本节要点回顾
- 最小 SoC 四件套——处理器桩、共享总线、存储、串口——是真实 SoC 的骨架映射,部件逐一对应第二、三章的概念。
- 总线的灵魂是握手事务:请求、应答、前进三拍,一切复杂协议都是这个骨架的加厚。
- 编码纪律在实验里逐条兑现:分块清晰、复位完整、位宽显式、分支穷举。
- 三个变式分别预演仲裁、延迟容忍与跨时钟域,是第五章前的必修预习。
CK770 的骨架能在仿真器里跑通了,下一章开始拷问它:验证与排错——那个真实的、庞大的、决定项目生死的话题。