5.3 与 Terraform 的分工边界
5.3 与 Terraform 的分工边界
本节摘要:基础设施自动化里最常见的一对工具,分工其实很清晰:Terraform 管"机器从哪来"(供给层),Ansible 管"机器该是什么样"(配置层)。本节讲清两个阶段的能力圈、三种衔接模式、以及哪些任务放在交界处最容易出事。读完你应当能在选型会上为"要不要同时用两个"给出有依据的方案。
先把两个阶段分开
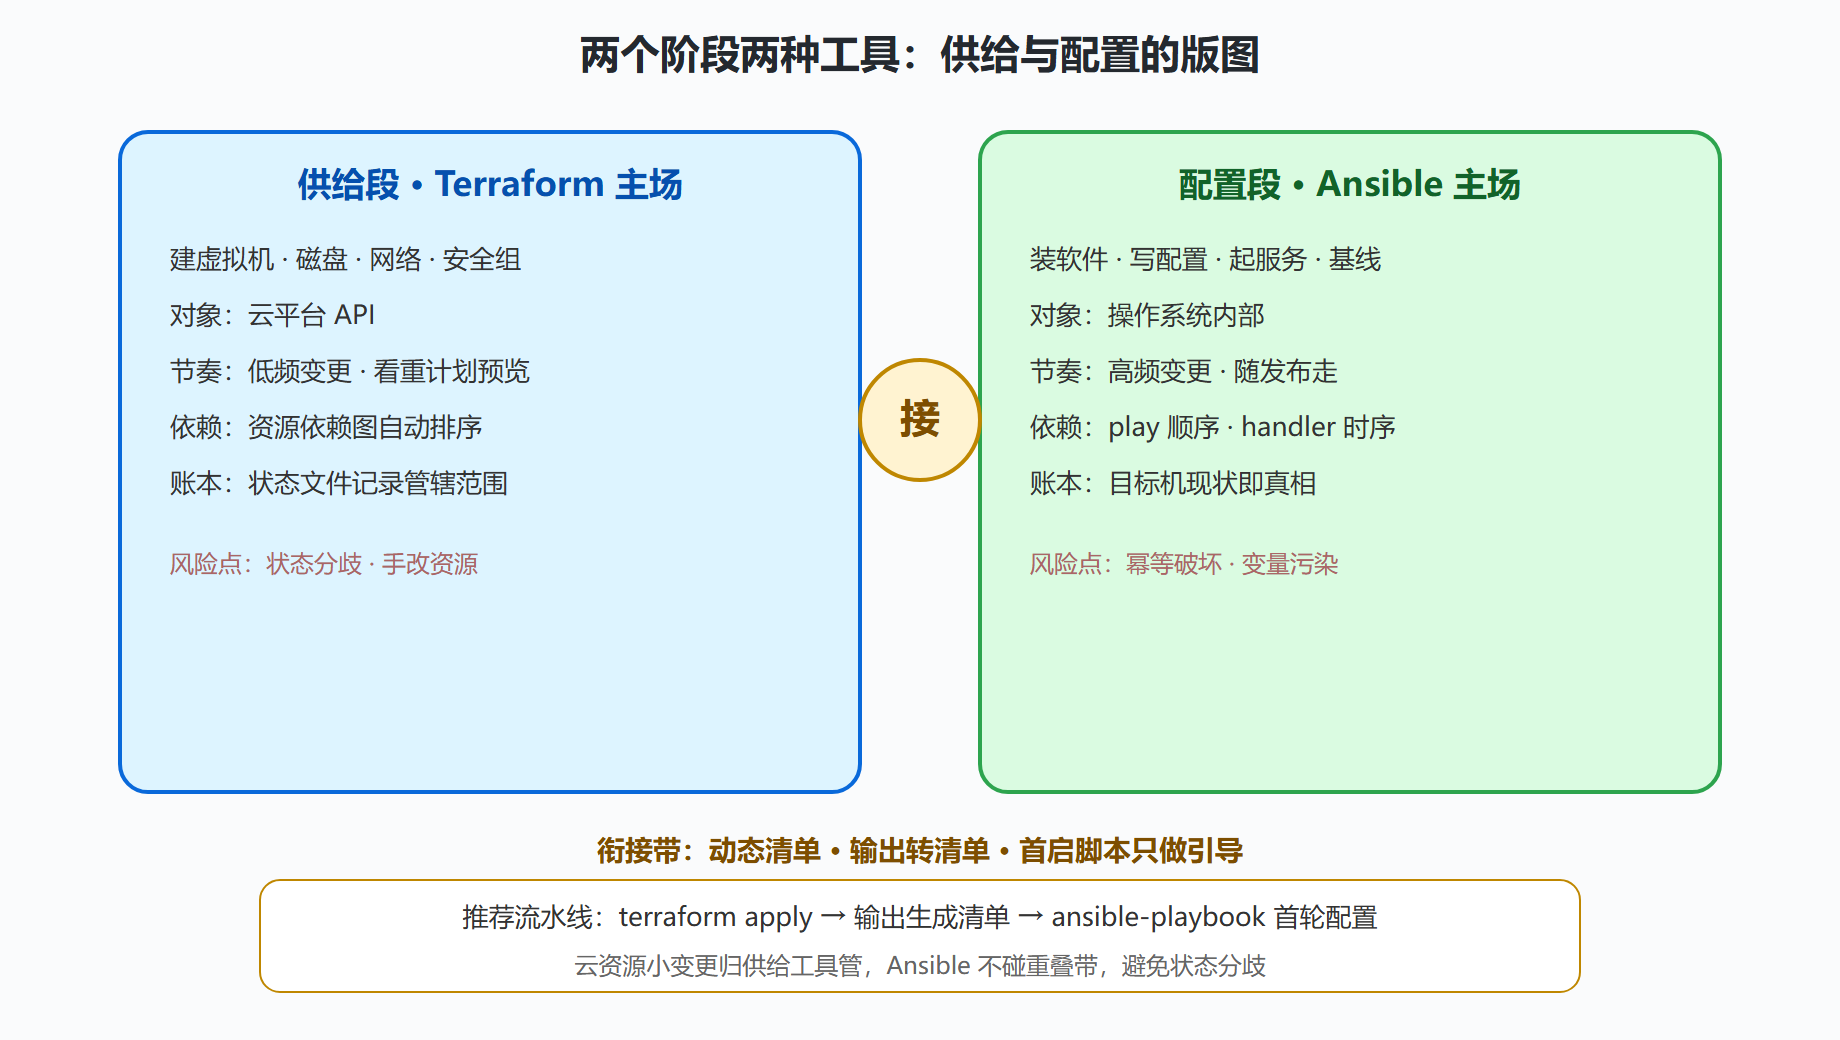
一台虚拟机的生命周期可以粗分为两段。供给段:从"无"到"有"——创建虚拟机、挂盘、配网络、划子网、开防火墙。配置段:从"有"到"合意"——装软件、写配置、起服务、打基线。两段的技术特征截然不同。供给段的对象是云平台 API,变更低频(一台机器创建后很少改规格),需要处理依赖图(子网先于机器、安全组先于机器),需要一个状态文件记住"哪些资源是我管的"。配置段的对象是操作系统内部,变更高频(每次发布都要动),依赖关系主要是顺序(先装包再改配置再重启),不需要外部状态账本。
Terraform 的设计完全贴着供给段特征走:声明式资源模型、依赖图自动排序、状态文件作为资源账本、计划(plan)与应用(apply)两段式执行让变更可预览。Ansible 的设计贴着配置段特征走:SSH 直达操作系统内部、模块级幂等、无状态账本(目标机现状即真相)、playbook 表达顺序流程。两者在自己半场的优势都不是对方能轻易复制的——反过来也一样,跨界使用都要付代价。
能力圈的重叠带与风险
重叠带有两个,恰好是事故高发区。重叠带一,云资源的小变更。Ansible 的云模块也能改安全组规则、改机器标签,而这类动作 Terraform 也管——两边都能改的后果是状态分歧:Terraform 的状态文件认为安全组是三条规定,实际已经被 Ansible 改成五条,下次 apply 会"纠正"回三条,把 Ansible 的变更静默冲掉。这类事故的恼人之处在于它不报错,只是"过几天配置自己变了"。
重叠带二,机器初始化。云平台大多提供初始化脚本机制(用户数据脚本),它会在供给段注入一段首启脚本。团队常见做法是把 Ansible 的接管动作藏在这段脚本里——可行,但要守住边界:脚本只负责"装 Python、拉取剧本、触发首轮配置",绝不把业务配置写进脚本。否则同一份配置逻辑存在两处(脚本一份、剧本一份),漂移从这里开始。
三种衔接模式
模式一,纯手工接力(小团队起步态):Terraform apply 建完机器,人肉把新机器地址补进 Ansible 清单,再跑配置剧本。缺点是清单会过期,好在 4.3 节的动态清单直接解决——按标签筛选,新机器带对标签自动进入清单,接力自动化了。
模式二,供给触发配置(推荐默认态):流水线串联两个阶段——Terraform apply 成功后,自动触发 Ansible 剧本对新机器做首轮配置。衔接点用数据传递:Terraform 的输出(机器 IP、实例 ID)写进一个临时清单或变量文件,Ansible 读它。整个"从无到可用"是一条流水线命令:
流水线阶段串联(示意) 阶段一 terraform plan / apply # 供给:建机器,输出 IP 列表 阶段二 生成动态清单或变量文件 # 衔接:输出转清单 阶段三 ansible-playbook bootstrap.yml # 配置:首轮初始化与基线
模式三,配置触发供给(谨慎使用):Ansible 剧本里调用 Terraform(或云模块)完成少量建资源动作。适用面极窄——比如运维剧本发现容量不足时临时扩一台缓存节点。风险在于把供给变更藏进了配置工具的执行里,绕过了 Terraform 的计划预览,审计与回滚都变难。用则要有纪律:这类动作单独成剧本、单独审批。
图 5-3:供给层与配置层的分工版图
选型会的应答框架
回到那个高频问题:"有了 Terraform 还要 Ansible 吗"——反过来问也一样。应答框架是回到两段论:先看你们变更的主体在哪一段。机器数量按天增长、基础设施拓扑频繁调整的团队(典型如平台工程团队、多环境云原生团队),供给段是主战场,Terraform 必选,Ansible 按需补配置段。机器结构稳定、但发布与配置变更频繁的团队(典型如传统业务系统的运维团队),配置段是主战场,Ansible 独挑也完全成立,Terraform 可以不上。两段都重的团队才真的两个都要。
补充两个选型会上的常见误区。误区一,"用一个工具统一一切":Ansible 的云模块能把供给也做了,代价是放弃依赖图与计划预览;Terraform 的配置管理方案(provisioner)也能碰操作系统内部,官方文档自己都标注它是有缺陷的最后手段。各自在最擅长的半场工作,才是省力路线。误区二,"引入两个工具等于两倍复杂度":复杂度的总量由基础设施本身决定,工具只是把复杂度放在合适的容器里——放错容器的复杂度(比如用脚本管理三百台机器的配置)才是失控的来源。
交界处的三个高频错误
两段论清楚之后,交界处的错误形态也固定了,三个高频错误各配一个识别信号。错误一,用 Ansible 建了 Terraform 不知道的资源:信号是 Terraform plan 里突然冒出"将删除"的陌生资源——状态账本之外的资源在它眼里都是待清理的野资源。纠正方向是资源唯一归属:每个云资源有唯一的管理者,归属表进仓库。错误二,把配置逻辑写进首启脚本:信号是排障时发现配置存在于两处且不一致。纠正方向是脚本只做引导三件事(装 Python、拉剧本、触发首轮执行),其余全部进剧本。错误三,双向依赖:Terraform 的输出需要 Ansible 先跑完才能确定(比如配置产生的 ID 回填),Ansible 又依赖 Terraform 的输出——信号是流水线反复来回跑。纠正方向是重构依赖方向,让数据单向流动:供给产生输出,配置消费输出,需要反向数据的场景(如配置生成的动态端点)改由运行时发现机制(服务发现、查找插件)解决,而不是靠执行顺序耦合。三个错误的共同解药是边界纪律,而纪律需要用归属表与单向数据流这种可检查的形式固化,口头约定在三个月后必然松动。
动态清单:两个工具的天然接口
三种衔接模式里真正承担日常衔接的是动态清单,值得单独说透它为什么是正确接口。关键在标签(tag)的语义约定:供给工具创建资源时打上规范化标签(环境、角色、层级),配置工具按标签筛选纳管——标签成为两个工具之间的契约层。这个设计的妙处是解耦:供给端扩容新机器只要打对标签,配置端零改动;供给端换云厂商,只要新平台的标签语义对齐,配置端依旧零改动。工程要求随之明确:标签键值需要一份正式规范(命名、必打项、大小写约定)并纳入评审,标签漂移的巡检进定时任务。很多团队的 Terraform 与 Ansible 集成做得别扭,根因都是跳过了标签契约直接做点对点衔接——接口松散的集成,日子久了必然长出手工清单这种寄生品。