4.4 四种实现的横向对比
4.4 四种实现的横向对比
本节摘要:前三节分片看了三种生态,本节把四条典型路线——运行期反射、编译期模板、语法树派生宏、同像性宏——拉到同一道题前:按字段生成序列化逻辑。逐路给出核心实现片段,做一张多维对比矩阵,最后沉淀为选型决策顺序。读完你将拥有一个可复用的决策框架,而不是四种孤立的印象。
把四条路线放进同一道题
题目刻意选"序列化"这种所有生态都真实存在、又同时踩到"类型重复"与"结构重复"两种重复的需求:字段清单决定生成什么(结构重复),字段类型决定怎么转(类型重复)。谁能优雅地吃下它,谁的能力边界就暴露无遗。
一、四份答卷并排看
答卷一:运行期反射(Python 风)。 定义时不生成任何东西,首次调用时查字段、建缓存:
def serialize(obj): fields = type(obj).__annotations__ # 运行期读字段清单 return {name: getattr(obj, name) for name in fields}
实现最短,零编译介入;代价在运行期:每次查清单有开销(要用缓存对冲)、类型错误要到执行才暴露、字段在运行期被动态增删时行为变得不可预测。
答卷二:编译期模板(C++ 风)。 用模板加内省技巧在实例化时展开出逐字段赋值。核心骨架示意:
template <class T> struct Serializer { // 对每个可访问成员生成写出到缓冲区的代码(示意) template <class U> auto write(const U& field, Buffer& b) const { b.append(field); } // 对结构体本体:反射设施枚举成员后逐一 write(C++26 前需绕行宏或代码生成) };
坦白说,这份答卷在当前标准下最费纸面:绕行手段(检测惯用法、tuple 化结构体)门槛高,所以 C++ 社区实践中常用传统代码生成补位。它的优势在产物:运行期零反射开销、类型错误编译期暴露、内联后与手写无差。
答卷三:派生宏(Rust 风)。 宏遍历语法树里的字段,生成完整实现:
#[derive(Encode)] struct Point { x: i32, y: i32 } // 宏产出(示意):fn encode(&self, out: &mut Buffer) { // out.write_i32(self.x); out.write_i32(self.y); // }
实现工作量集中在宏内部(一次写好,处处受益),使用处一行标记;产物是普通代码,全量检查照走,报错锚定到结构体定义处。
答卷四:同像性宏(Lisp 风)。 结构体定义本身就是列表,宏读它、生成访问函数:
(defstruct point x y) ;; defstruct 展开后自动生成 make-point、point-x、point-y 等函数
在 Lisp 世界这甚至不算"元编程",只是普通库代码——语言把结构定义设计成了可展开的宏。表达自由度最高,纪律也最依赖团队自觉。
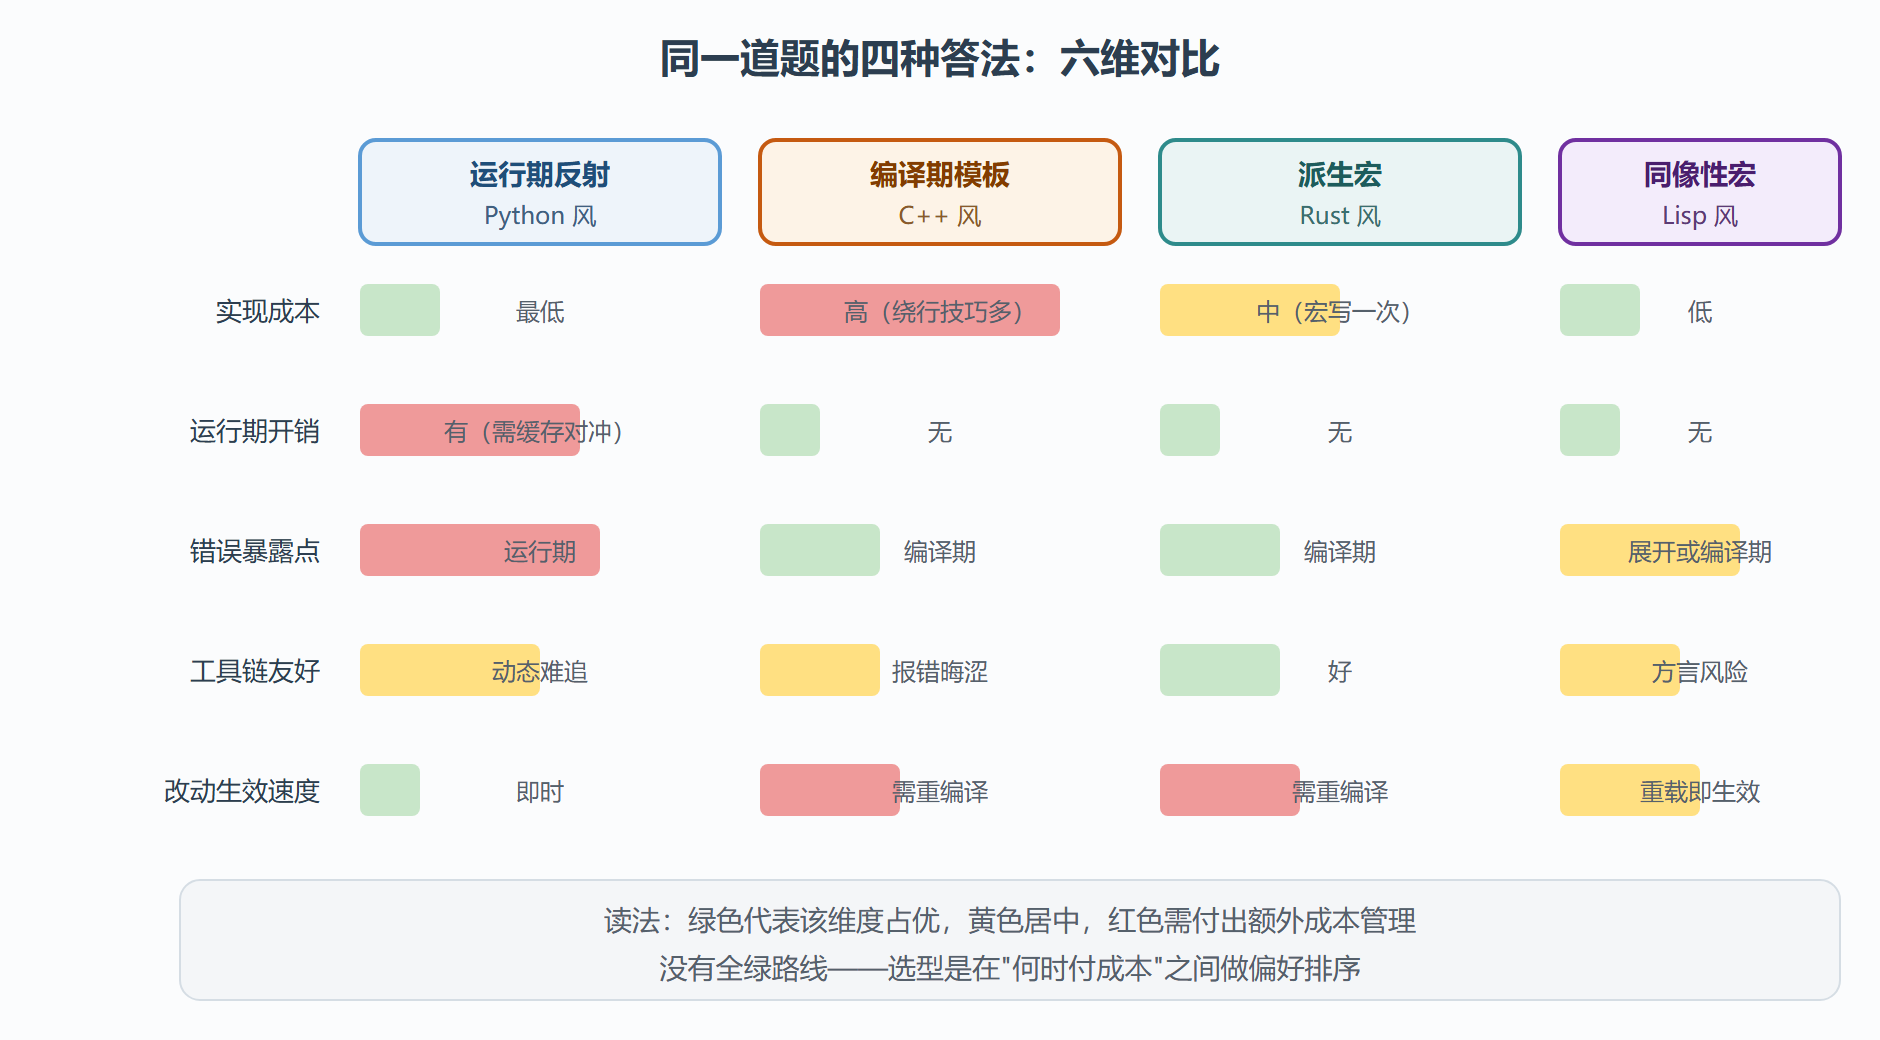
图:四条路线的多维对比矩阵
二、从矩阵到决策顺序
对比矩阵的用法不是"找全绿",是按项目约束排优先级。三条经验决策顺序:
约束一:运行时预算紧张吗? 是——先划掉反射答卷,在模板与派生宏之间按语言栈选;热点路径甚至要考虑 4.5 的预生成方案。约束二:结构变化频繁吗? 字段每周都在加的快速迭代期,反射的"即时生效"价值最大,运行期开销用缓存摊薄;结构稳定的核心域,编译期路线的一次性成本更划算。约束三:团队要长期维护吗? 长生命周期代码对工具链友好度权重高——派生宏路线的可读、可跳转、可测试在这个维度明显占优;同像性宏的自由度则要求团队有配套的评审纪律,否则方言化账单会越滚越大。
一个真实项目的决策缩影:网关序列化模块(热点路径、结构稳定)选了派生宏;运营后台的动态报表(结构天天变、流量低)选了反射。同一代码库里两种答案并存且互不冲突——选型的单位是模块,不是项目。
选型复查清单
决策做完先别关文档,过一遍这份复查清单,每个问题答"是"都需要补充说明:
- 有没有用 5.4 式的实测支撑结论,还是只凭印象下了判断?
- 选中的路线,其最痛的代价项(反射的运行期开销、宏的构建开销、生成的同步负担)有对应的缓解措施吗?
- 混用多条路线时,边界是否清晰到可以一句话描述("网关走生成、后台走反射"),还是散点混布?
- 半年后结构再次变化时,第一条受影响的管线是谁,改起来的操作步骤写得出吗?
- 新同事入职能在一天内看懂当前路线的选型理由吗——理由有没有落在文档里而非某人的脑子里?
清单的价值不在"全过",而在把隐含的取舍逼到台面上。五问里答不上两项,通常说明选型还停留在直觉层,值得回到矩阵再推敲一轮。
一条容易漏掉的第四问:错误处理算谁的
对比矩阵有六个维度,还有一个维度常被漏掉:错误处理语义归谁管。同一个"字段超长"错误,反射路线通常返回统一的错误对象(处理逻辑集中);生成路线产出的直调代码往往就地返回错误码或异常(处理逻辑分散在各调用点)。两条路线没有对错,但混用时极易出现"一半错误是对象、一半是异常"的缝合状态——调用方被迫同时适配两套错误协议。所以选型复查时补一条:跨路线的模块,错误处理协议必须统一,要么生成器产出时适配项目的统一错误类型,要么反射层包一层转换。这个看似边角的细节,在实际项目里的返工率不比性能问题低。
本节要点回顾
- 对照题目的价值:序列化同时包含类型重复与结构重复,是四条路线能力的试金石。
- 四份答卷:反射最短但运行期付费,模板产物最优但绕行门槛高,派生宏一次投入处处受益,同像性宏自由度最高。
- 矩阵读法:没有全绿路线,选型是"何时付成本"的偏好排序。
- 三问决策:运行时预算、结构变化频率、维护周期,三问之后答案自然浮现。
- 模块级选型:同一项目内不同模块可以选不同路线,选型不搞一刀切。
选型定了,生成代码怎么进工程?下一节补上最后一环:版本库、评审、构建接入的完整管线。