3.5 手推一次编译期计算
3.5 手推一次编译期计算
本节摘要:本节做一场纸上推演:以"编译期求阶乘"为题,逐步手推 C++ 模板递归的实例化展开、递归终止与常量折叠,再对照 constexpr 写法的等价推演,最后复盘两种写法在报错与编译成本上的差异。推完这一场,编译期计算对你将不再是黑盒咒语,而是可以逐步验证的机械过程。
一道可以手算的编译期算术题
编译期计算听起来玄,本质却极朴素:把一段求值过程从运行期挪到编译期,让编译器代替 CPU 把结果算出来。验证理解是否到位的标准,是能否在纸上演算出编译器每一步在干什么。本节就用最小的例子做这场演算——题目是人人熟悉的阶乘。
先摆出模板递归的原始写法:
template <int N> struct Factorial { static const int value = N * Factorial<N - 1>::value; }; template <> // 全特化:递归的"终止条件" struct Factorial<0> { static const int value = 1; }; constexpr int x = Factorial<5>::value; // 编译期算出 120
一、逐帧慢放:编译器眼里的六步展开
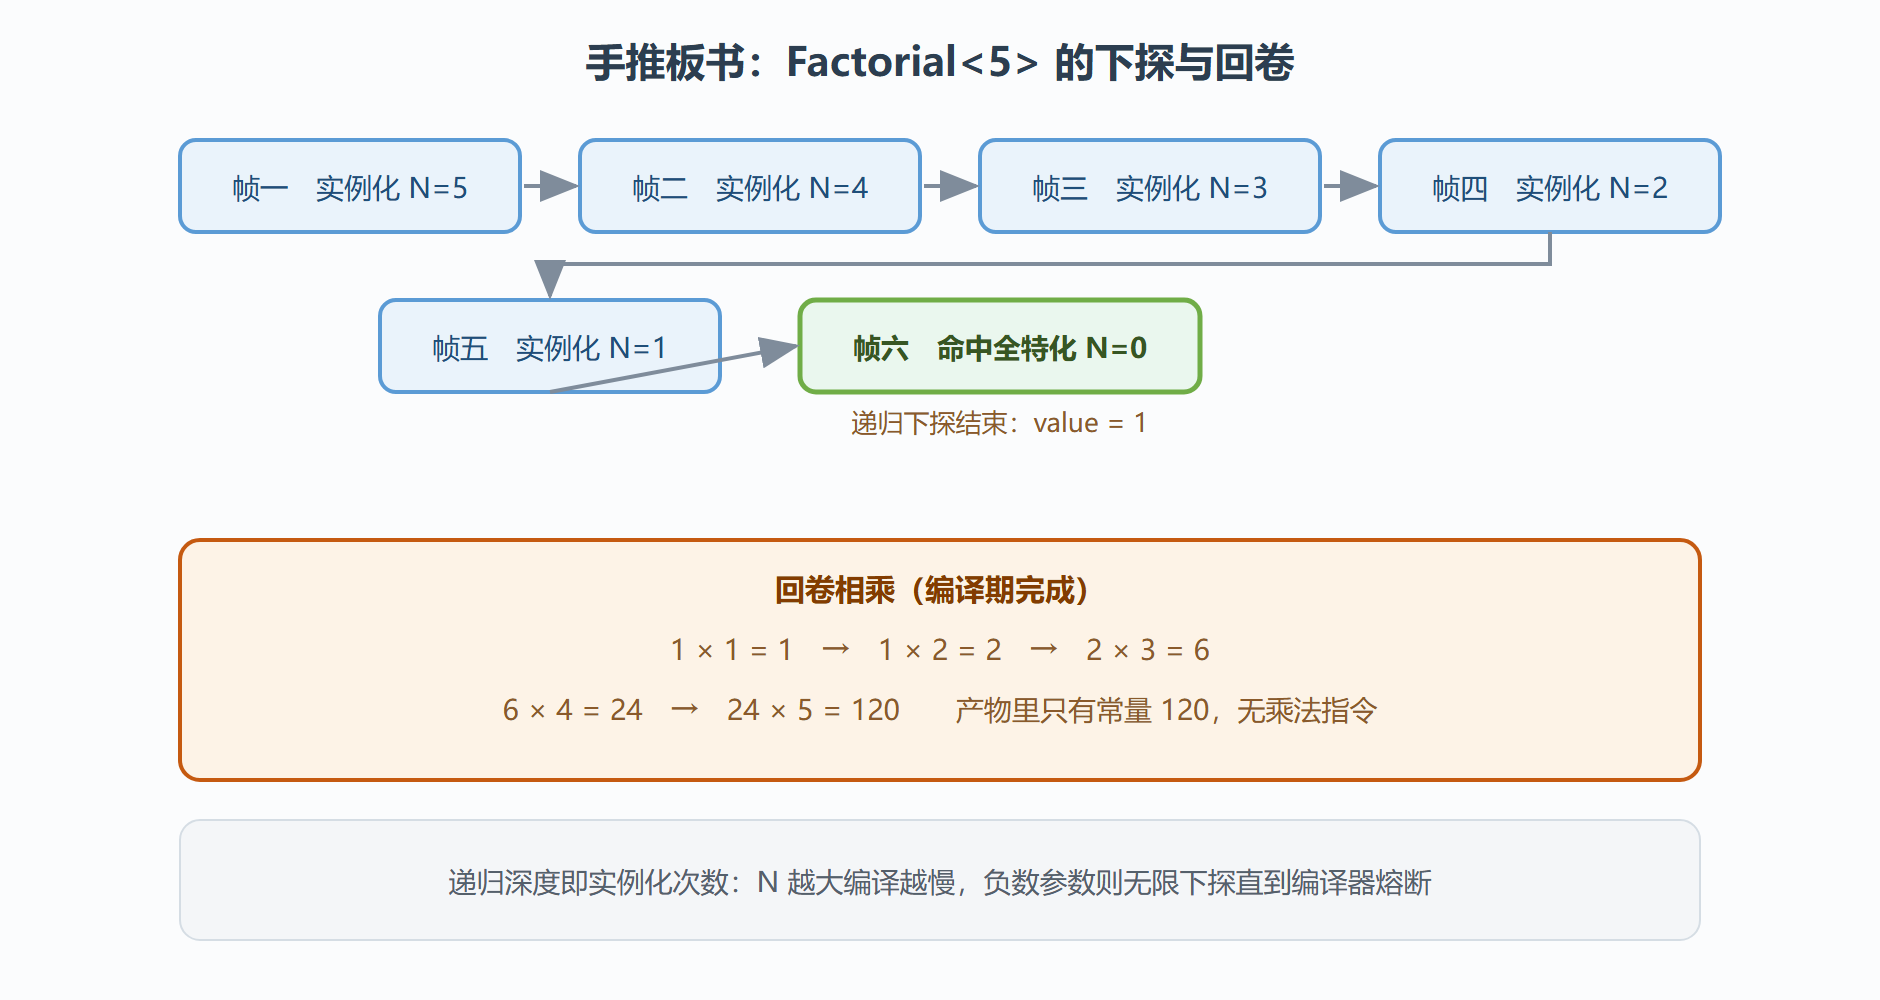
把编译器处理 Factorial<5>::value 的过程逐帧慢放。帧一:编译器看到 Factorial<5>,发现没有现成实例,按主模板实例化——把 N 替换为 5,得到 value = 5 * Factorial<4>::value。帧二:表达式里的 Factorial<4> 又是未知实例,继续实例化,得到 4 * Factorial<3>::value。帧三到帧五:同样的机械下探,3、2、1 依次入栈。帧六:Factorial<0> 命中全特化——不再递归,直接取 value = 1。随后回卷:1 乘 1 得 1,乘 2 得 2,乘 3 得 6,乘 4 得 24,乘 5 得 120。整个"递归下探、回卷相乘"的过程发生在类型检查阶段,产物里只有常量 120,没有任何乘法指令被生成。
图:模板递归展开的手推板书
二、等价推演:constexpr 把公式还给普通语法
同一道题用 constexpr 重写,推演方式完全不同——不再有"实例化",只有编译期函数求值:
constexpr unsigned fact(unsigned n) { return n <= 1 ? 1u : n * fact(n - 1); // 普通函数语法 } constexpr unsigned y = fact(5); // 编译期求值:120 unsigned z = fact(runtime_n); // 运行期求值:同一函数也能跑时算
操作→结果:编译器在初始化常量 y 时发现右值是 constexpr 调用,于是启动解释器逐语句执行——参数 n 从 5 一路自减到 1,函数调用栈与运行期完全同构,返回值沿栈回乘。关键差异在最后一句:同一个函数,传编译期常量就编译期算,传运行期变量就生成普通函数体给 CPU 执行。"编译期还是运行期"不再是两套语法的选择,而是同一个定义按参数性质自动分配。这正是 1.2 末尾说的"现代语言收敛方向"——Zig 把这条路走到了极致。
顺带留一个观察作业:把 constexpr 版本里的 fact(5) 改成 fact(runtime_n)(运行期变量),编译产物里就会出现完整的递归函数体;再改回常量参数,函数体又消失、只剩常量。动手对比一次两版汇编,"求值时机由参数性质决定"就从结论变成了亲眼所见。
三、复盘:三条工程结论
推演做完,收获不止"看懂了"。结论一:递归终止是模板写法的命门。手推时你能直接看到,缺了 Factorial<0> 特化,下探会在 0、负 1、负 2 上无限继续,直到编译器达到实例化深度上限熔断——真实的报错是一串嵌套几十层的"实例化深度超过限制",读报错时从最深一帧往回读,先找的永远是"终止条件为什么没命中"。这条排查心法在 6.4 排错实录里还会反复用到。
结论二:报错质量取决于展开发生在哪一步。模板版本若把 int N 写成会溢出的量级,或者参数类型不匹配,报错出现在"实例化"帧,附带完整实例化链;constexpr 版本的同类错误(比如溢出)通常报成"常量表达式未求值成功",信息更短但更抽象。工具友好度上两者互有胜负,共同规律是:离普通语法越近,报错越像普通报错。
结论三:编译成本要记账。手推板书里每一"帧"都是真实的编译器工作量:N=10 就是十次实例化加十次回卷。把这类计算写进模板库的头文件,意味着每个包含它的编译单元都重算一遍。解法是一个两难的选择题:要么换 constexpr(函数只编译一次),要么把计算结果缓存成预生成表——预生成又绕回 3.4 讲过的"生成源码再编译"路径。你看,三大机制在一场手推里会师了。
变体加练:斐波那契暴露的新问题
把题目从阶乘换成斐波那契 F(n) = F(n-1) + F(n-2),再推一遍会有新发现:展开树不再是链而是二叉树——F(5) 要实例化 F(4) 与 F(3),两者又各自分叉,实例化次数按指数增长,N=30 就足以让编译卡死。而手写运行期版本哪怕不优化也只是线性循环。这道变体揭示的本质是:模板递归默认不带记忆化,每次实例化都是独立计算,相同的子问题不会共享结果。对策同样清晰:要么换 constexpr 函数(可配缓存数组),要么改写成基于数组传参的模板(把已算好的值显式传递),要么直接放弃编译期计算、构建期预生成查表。一次变体推演,把"编译期计算不是免费午餐"这句话变成了可感的具体数字。
本节要点回顾
- 手推方法:编译期计算可逐帧推演——模板递归看"实例化与回卷",constexpr 看"解释执行"。
- 终止命门:递归模板的报错排查从最深一帧回读,第一怀疑对象是终止条件。
- 语法收敛:constexpr 让同一个函数按参数性质自动分配编译期或运行期求值。
- 成本记账:每帧实例化都是真实编译开销,缓存与预生成是标准减负手段。
- 机制会师:一场手推串起模板展开、编译期求值与预生成三条线索。
四块承重墙与一场推演都已就位。下一章把这些零件装进五种语言的真实施工现场,看同一批需求在不同生态里的成套答案。