4.4 回测与实盘偏差排错实录:消失的收益去哪了
4.4 回测与实盘偏差排错实录:消失的收益去哪了
本节摘要:策略上线三个月,实盘净值持续跑输回测模拟——本节把这起"案件"从头到尾排一遍:按数据层、成交假设层、成本层、时序层四条线索逐层排查,还原一次完整的偏差定位,并沉淀一份可复用的排查清单。它是第二章双均线复盘的续集:那次证伪的是回测内部,这次要审的是回测与世界的关系。
案情:三成的差距,找不到单一元凶
背景交代得尽量朴素:一个日内统计套利策略,回测夏普看起来尚可,上线后的第一周表现符合预期,随后与模拟净值的裂口逐日拉宽,到第三个月末,实盘累计跑输模拟净值约三成。团队的第一反应是最常见的那种——"市场变了,策略退化"。但这个解释有个漏洞:同期用当日数据滚动重跑的回测(策略内核不动、只更新数据)依然显示不错的表现。也就是说,同样的策略逻辑、同样的近期数据,模拟与实盘走出了两条曲线。问题不在市场,在链路。排错开始。
第一层:数据对账
第一刀切在输入上。把实盘期间的行情留档与回测用的历史数据源逐字段比对,检查三件事:行情是否有缺口的静默丢失、两套数据源的复权与字段口径是否一致、时区与时间戳是否同一坐标系。结论:行情层有零星缺口但量级不足以解释三成;倒是抓到一个次生问题——实盘留档用的是未复权价格,与历史库的复权口径不同,这会让复盘对不上,但不影响实盘本身的盈亏。教训一:数据对账要区分"影响实盘"与"影响复盘"两类问题,混在一起查会互相干扰。
第二层:成交假设
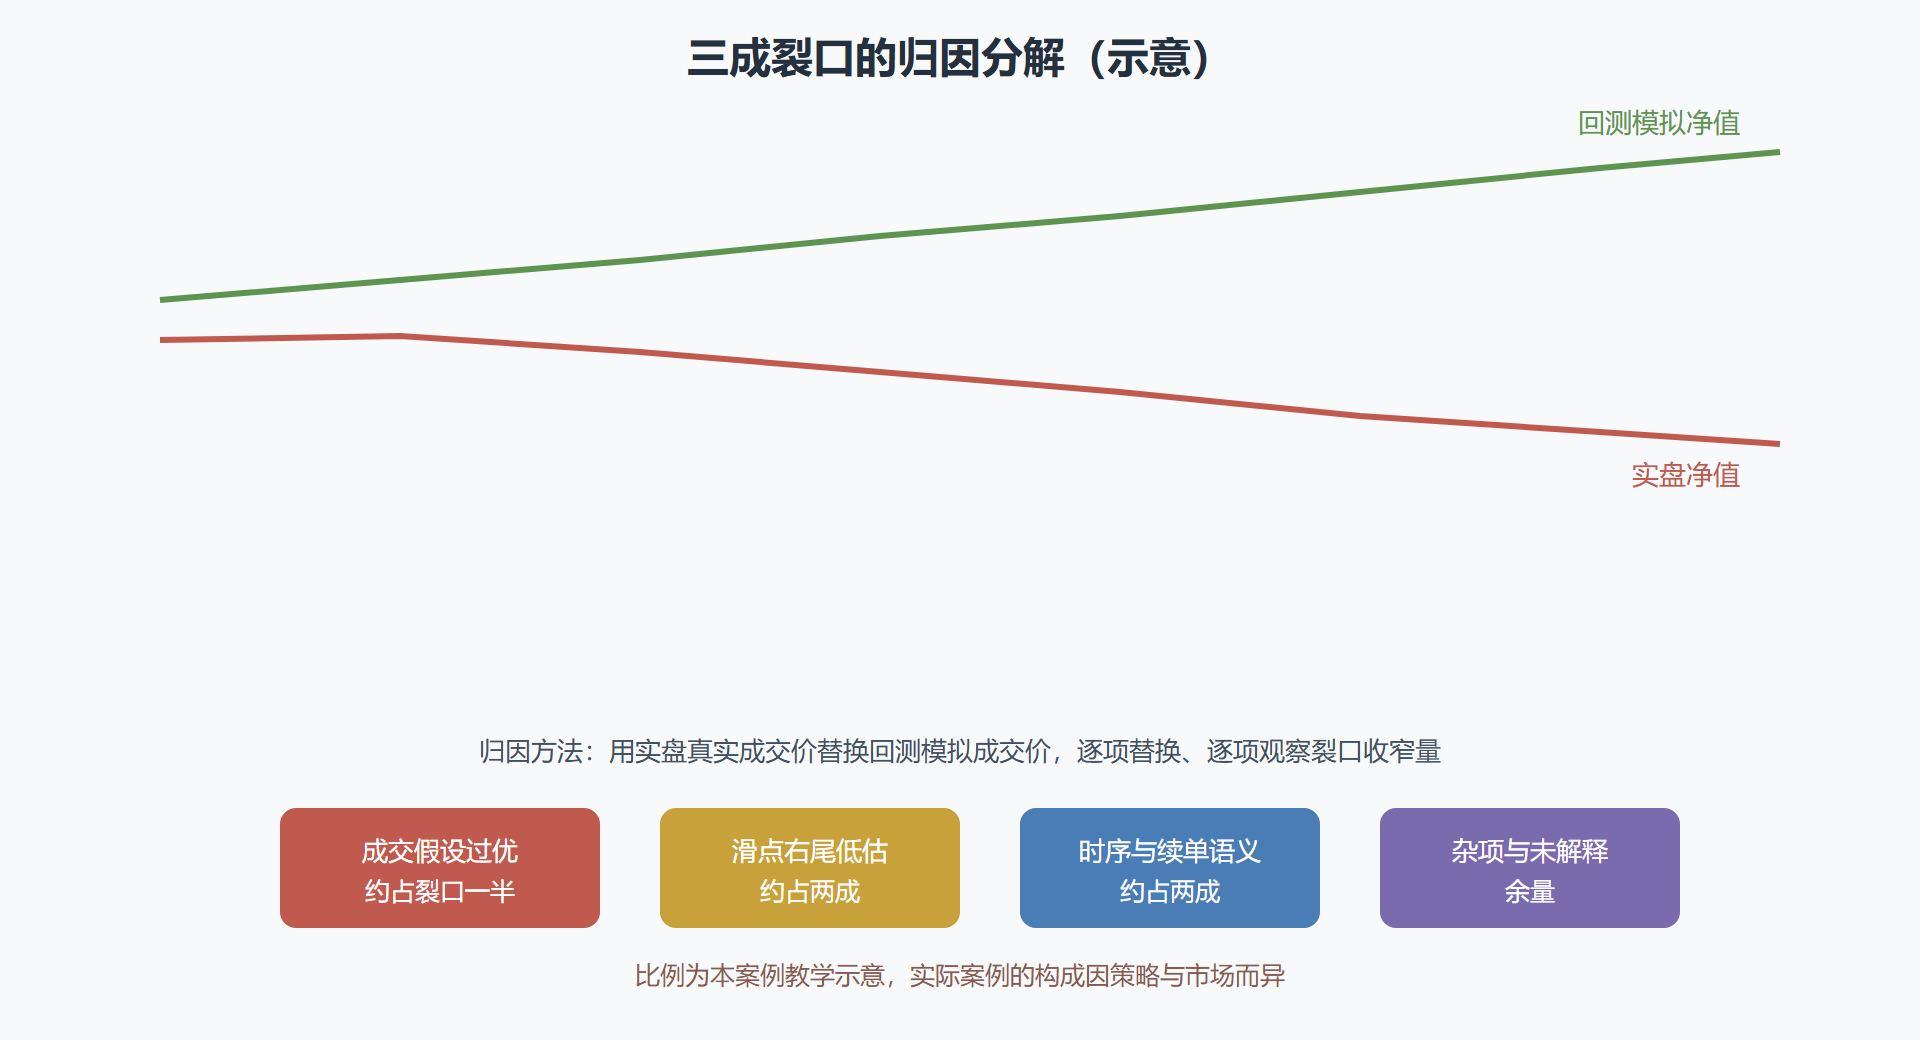
第二刀切在"订单如何变成成交"上。把回测引擎的撮合假设逐条拉出来与实盘对照:回测按信号当根 K 线收盘价成交且全额成交,实盘是次日开盘分批限价;回测假设无限流动性,实盘的单子要在盘口排队。为了量化差距,团队做了一次归因实验:用实盘留档的真实成交价,替换回测引擎里的模拟成交价,其余逻辑不动,重跑同样的时段——裂口立刻收窄了大半。剩余的裂口集中在少数几笔大单上。结论:主要元凶是成交假设过优,其中大单的冲击成本是最大的单项。教训二:把真实成交价喂回回测引擎,是定位执行偏差最直接的方法,比任何猜测都快。
第三层:成本模型
第三刀查成本。回测按固定比例计入双边费用,实盘账单里除了佣金还有经手费、征管费与偶尔的融资利息。逐项对账后发现固定比例大体够用,真正的偏差藏在滑点的分布里:回测用单一滑点常数,实盘滑点高度右偏——多数交易滑点很小,少数时段(开盘波动、消息冲击)滑点是常态的数倍。用常数建模等于把右尾抹平了。教训三:滑点要按分布建模并单独记录右尾,常数滑点天然低估极端时段的损耗。
第四层:时序与状态
最后一刀切在时序上。对照实盘订单日志与回测的信号时间轴,发现两处错位:其一,行情重连后的数据补齐用了快照而非重放,造成几段行情"瞬间跳变",策略在这些跳变上产生了回测里不存在的信号;其二,部分成交的续单逻辑与回测的"全额立即成交"假设不同,剩余量的二次报单有时落在更差的价位。教训四:重连后的数据语义、部分成交的续单语义,都必须写进回测引擎,否则回测模拟的是一个不存在的运行环境。
图 4-3:模拟与实盘两条净值的裂口归因(示意)
排查清单:下次直接抄
把本次案件的完整流程压成一页清单,按顺序执行,多数偏差能在一天内定位:
回测实盘偏差排查清单(按命中概率排序): 1. 成交价替换实验: 用实盘真实成交价回灌回测, 量化执行层贡献 2. 成本逐项对账: 账单全项 vs 回测常数, 单独核对税费与利息 3. 滑点分布: 按时段与波动率分层统计, 检查右尾是否被常数抹平 4. 数据口径: 复权方式 / 字段定义 / 时区, 两套数据源逐字段比对 5. 时序语义: 重连补数据的方式 / 部分成交续单 / 信号到发单的时延 6. 状态一致性: 订单状态机是否有超时与卡死, 持仓对账是否连续 7. 策略版本: 实盘运行的代码版本与回测版本是否逐行同源 8. 采样偏差: 实盘时段是否覆盖了回测未见的极端状态
案件的最终判决
三个月后,团队修复了成交假设与滑点建模,把执行日志接入了回测引擎的自动回灌流程,裂口收窄到可解释的余量内。但案件真正的遗产是观念层面的:回测与实盘的偏差不是玄学,是一张可以逐项归因、逐项修复的工程账单。"市场变了"这个解释永远存在,但只有在工程账单归零之后,才有资格被写进结案报告。
深入一步:排错之外的预防工事
结案之后要修堤。本次案件沉淀出三条常态化预防机制,比排查清单更上游。成交价自动回灌:实盘成交记录每周回灌回测引擎,重跑近期时段,模拟与实盘的裂口自动计算、超阈值自动告警——把"发现偏差"从季度复盘变成周度体检,本次案件拖了三个月才被重视的根因就是没有这道自动对账。撮合假设的版本管理:回测引擎的成交假设(滑点模型、部分成交规则、重连语义)与实盘引擎共享同一套配置文件并做版本对齐,杜绝"两套语义各自漂移"。上线前的语义对照表:新策略上线前,逐项填写"回测如何假设、实盘如何实现"的对照表——成交时点、成本参数、部分成交处理、异常恢复,四处对不上的地方就是未来的偏差。三条机制的成本都不高,但它们把 4.4 这类案件的发生概率压低了一个量级:排错是补救,对账才是免疫。
本节要点回顾
- 先排除工程误差再怀疑市场:模拟与实盘的裂口,主要成分通常是可归因的链路损耗;
- 成交价回灌是最快的定位法:用真实成交价替换模拟撮合,执行层贡献立刻现形;
- 滑点要按分布建模:常数滑点抹平右尾,极端时段的损耗被系统性低估;
- 运行语义要进回测引擎:重连补数据、部分成交续单,这些实盘语义不建模,回测模拟的就是幻想环境;
- 清单化排错:按命中概率排序的固定流程,比灵光一现的猜测可靠得多。
⚠️ 常见坑:排错时同时改多个环节。归因实验的原则是一次只改一个变量,否则裂口收窄了也说不清是哪一项的功劳。
定位完偏差,下一节做一个更主动的实验:不等实盘教我们,直接在回测里扫描成本参数,看策略判定在哪个区间翻转。