8.1 过拟合与欠拟合的现场诊断
8.1 过拟合与欠拟合的现场诊断
本节摘要:调参前后最要紧的一步,是先确定你到底在过拟合还是欠拟合。本节给出一张"从训练/验证曲线到病根再到扳哪个旋钮"的诊断决策图,并把四种常见走向的诊断与处方一次讲清。
学习目标
阅读完本节,你应当能够:
- 只看训练/验证两条曲线形状,快速判定欠拟合或过拟合。
- 为每种形态给出第一反应(加容量/加正则/加减学习率等)。
- 识别"曲线像过拟合却其实是泄漏或数据问题"的混淆情况。
一、诊断先行:拧旋钮前先看懂曲线
前几章我们把训练监控的仪表盘搭起来了,但仪表盘要给结论服务。真到实战,最常见的死法不是"不会调",而是"还没确诊就乱拧"——把过拟合作当成欠拟合处理,越拧越糟。所以这一节把诊断做成一件事:从两条曲线的形状,读出该扳哪个旋钮。
二、四张脸与对应处方
过拟合与欠拟合的四象限诊断
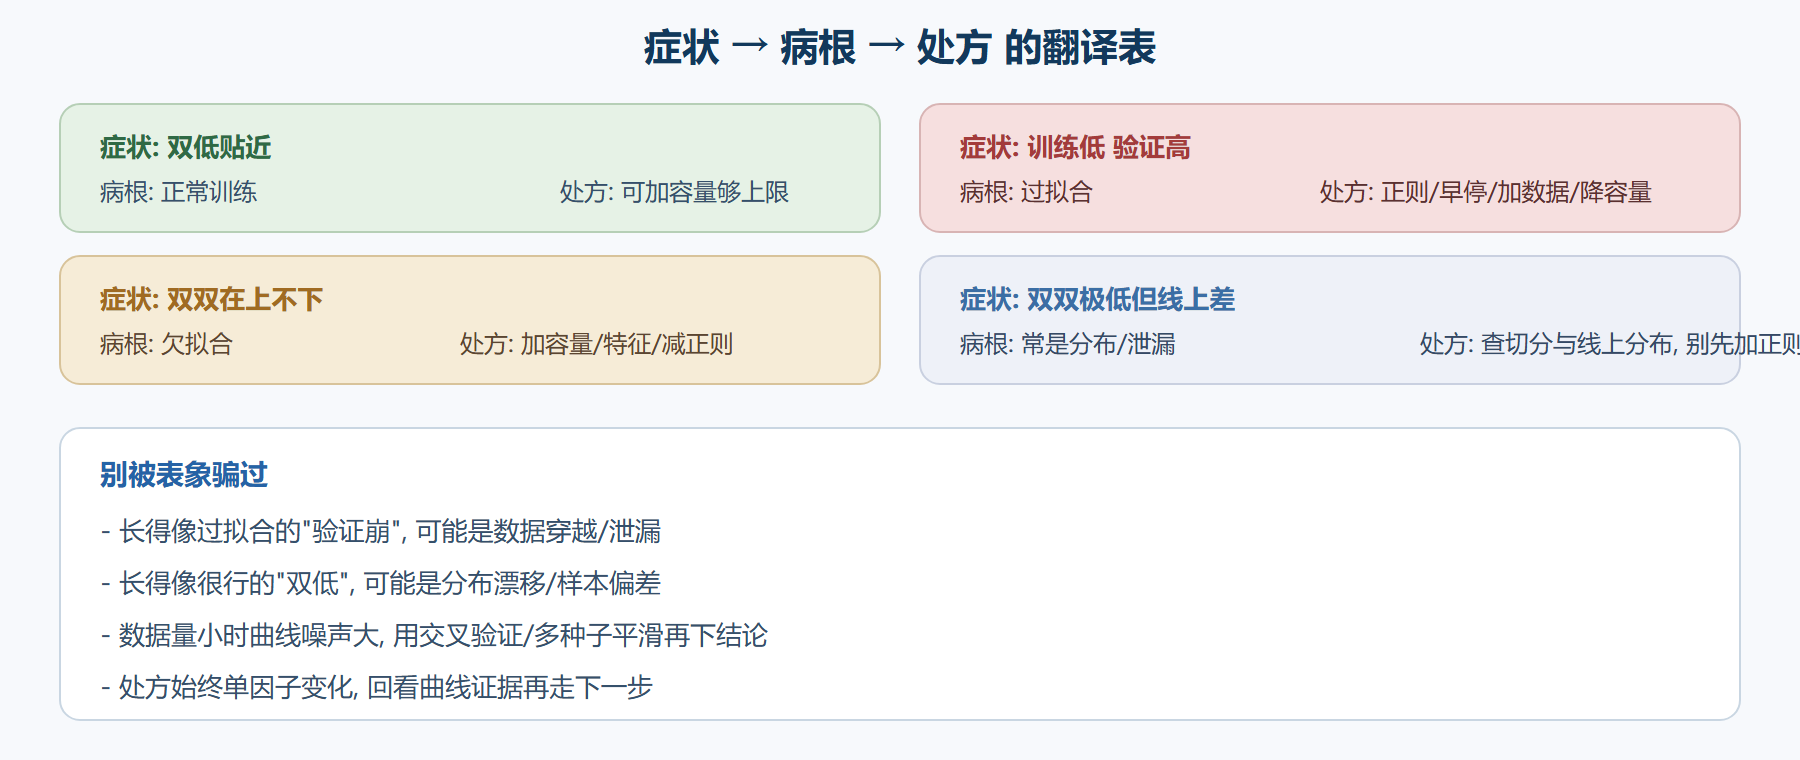
- 双低且贴近(正常):训练与验证都低、间隙小——健康。还可以试着加容量或换更强模型去够更高上限。
- 训练低、验证明显高(过拟合/剪刀口):模型背了训练集。处方:加正则、上提前停止、增量数据、降容量。
- 双高、几乎不降(欠拟合):模型学不出数据规律。处方:加容量、加特征、减正则、必要时加大训练轮或调学习率。
- 双高但缓慢下降(可能还在收敛):别急着下结论,给它再多跑几轮或看看是否卡在鞍点,再决定。
光看最终分判不了这四张脸,一定要两条曲线对照着看。
三、别踩混淆:长得像故障的其实不是
有些"症状"会误导,要能一眼识破:
| 症状 | 往往其实是 | 正确反应 |
|---|---|---|
| 训练损失极低、验证崩 | 泄漏/数据穿越 | 查切分与特征可得性,别先加正则 |
| 训练与验证都极低但线上差 | 分布漂移/样本偏差 | 查线上分布,别先调参 |
| 曲线震荡不停 | 学习率过大 | 降学习率,别当噪声忍了 |
这正是它应和第一、二章衔接的地方:有些"过拟合"其实是信号污染或数据分布问题,加再多正则都白搭。
四、由诊断到处方的最小动作序列
确诊后再行动,下面是一个快速起手序列(顺着影响力排序):
- 若欠拟合:加大模型容量/加特征一把,看训练损失是否下探。
- 若正常:适度加容量/算力,够更高上限。
- 若过拟合:依次上收益最大且风险最小的——提前停止、正则、必要时降容量。
- 每一步后回看曲线,证据决定下一步,一律单因子变化。
# 概念示意:诊断先行、单因子变化的调参循环 for knob_to_change in ["capacity", "reg", "lr"]: old = evaluate() # 记录改动前 change_only(knob_to_change) new = evaluate() # 只对比这一个改动 log_verdict(knob_to_change, old, new)
⚠️ 常见坑:数据量小时,单次曲线噪声大,把"小小的剪刀口"当成过拟合果断上正则——结果把健康模型压坏。数据量小务必用交叉验证或多次运行来平滑结论,而不是凭一条曲线。
💡 直觉:欠拟合与过拟合常在同一次调参里先后出现(容量从小往大加,先欠拟合,越过某个点变过拟合)。真正练手的,是找到"恰好在中间的容量窗口",这往往比一次调对更有价值。
五、"加容量"要加对方向,别只加数量
诊断出"欠拟合"后,最手痒的动作是"把模型做大",但"做大"也有讲究。对神经网络,可能要做的是加宽度还是加深?加宽偏于"在同一个尺度上拓宽表达",加深偏于"逐层堆出更抽象的特征"——它们带来的收益和算力代价不同,该用验证信号而不是手感来判断。对树/集成,欠拟合往往意味着"树太少或太浅"或"学习率太低没把每棵树学到该有的度"。所以"加容量"的正确姿势,不是无脑把某个数调大,而是先想清楚**"当前卡在的是哪一档的表达力"再对症换**。这又是一个"先确诊、再对症"的例子,也再一次呼应本册反复强调的"单因子、看验证"。
六、把"诊断"沉淀成一套可复用的检查单
临场诊断最容易慌,紧张时人容易漏步骤。更好的办法,是把前面的判断固化成一页口头起手的检查单,遇到新任务先照它过一遍:(1) 先看训练/验证两条曲线整体形态,是双高、双低还是剪刀口;(2) 再看曲线是否在缓慢下降、有没有可能在继续收敛;(3) 核对切分与特征,排除"泄漏/时序穿越"这类伪装成过拟合的假象;(4) 用一个小实验(改一个旋钮)验证你的判断,再把结论记进日志。这张单子最大的价值是把"凭直觉"换成"按流程"——哪怕你当时没想明白为什么,只要照单走完,也至少不会错得更离谱。等到本章最后一节,你会看到这张单子如何在一整条端到端案例里被反复调用。
诊断能力还有一个被低估的来源:积累"形态样本"。不同任务对同样的四种形态,往往有高度一致的反应模式——见过的欠拟合长什么样、过拟合的剪刀口有多大、某个典型任务里"看起来像过拟合其实是泄漏"长什么样。这些经验没法靠读几本书获得,只能靠你一次次"记录形态 → 记录处置 → 记录结果"攒出来(呼应第四章"攒曲线经验库"的话)。所以别嫌记录麻烦,你每记一次,就等于给未来的自己留了一条少走的弯路。真正的高手,不过是在下判断的那几秒里,脑子里比别人多闪过几张"见过且被证实"的图而已。
到这里也想强调一句和全册主线一致的总结:诊断和调参用的是同一套"证据驱动、单因子、看验证"的心智。你判断"是过拟合还是欠拟合"时在读证据、在验证;你决定"加容量还是加正则"时也在读证据、在验证。真正的高手不会把这两件事当成两套技能,而是把它们看作同一套实验思维的两种施展。掌握这节,你就把全书前面所有"用验证信号说话、别让指标骗你"的原则,落到了最贴近实战的第一步上。
本节要点回顾
- 要点一:诊断先行,从两条曲线读出是欠拟合还是过拟合再动旋钮。
- 要点二:四张脸分别配"加容量/加正则/观察/再跑几轮"。
- 要点三:长得像过拟合的"泄漏/分布偏差"要单独排除,别乱加正则。
- 要点四:处方按影响力排序,单因子变化,证据驱动下一步。
- 要点五:小数据用交叉验证平滑曲线,别被单次噪声误导。
诊断开了"病根",下一节处理更具体的"训练失败现场"。