7.5 概念漂移与持续监控
7.5 概念漂移与持续监控
本节摘要:模型上线那天不是终点,而是监控与治理的起点。本节讲概念漂移(数据分布随时间变化)为何会让模型性能静默下滑,以及一套"观测漂移-评估表现-触发重训-必要时回滚"的持续监控治理循环。
学习目标
阅读完本节,你应当能够:
- 定义概念漂移并区分几种常见类型(凸显型/渐变型/反复型)。
- 设计一个能早期发现性能下滑的监控指标组合。
- 规划"何时重训、如何回滚"的治理循环,避免上线后翻车。
一、上线不是终局,是新的开始
一路把模型训到漂亮、压缩到能跑、铺上集群,很多人以为这就大功告成。可真实世界的现实是:部署后模型会悄悄变"笨"。用户行为变了、季节更替了、新品类出现了——你训练时赖以成立的数据分布,正在一点一点偏离。这一幕就是本节要讲的"概念漂移",它让"精密调出来的成绩"在几个月内高台跳水。
二、漂移的三种长相
- 凸显型(突变):一夜之间分布骤变,比如搜索语料来了个爆点词汇、政策规则改变,模型性能急坠。
- 渐变型(慢移):半年里分布缓慢游走,你几乎察觉不到,直到明显告警才发现晚了。
- 反复型(循环):季节性规律反复(如电商大促、节假日),漂移会周期性回来。
三种概念漂移的形态
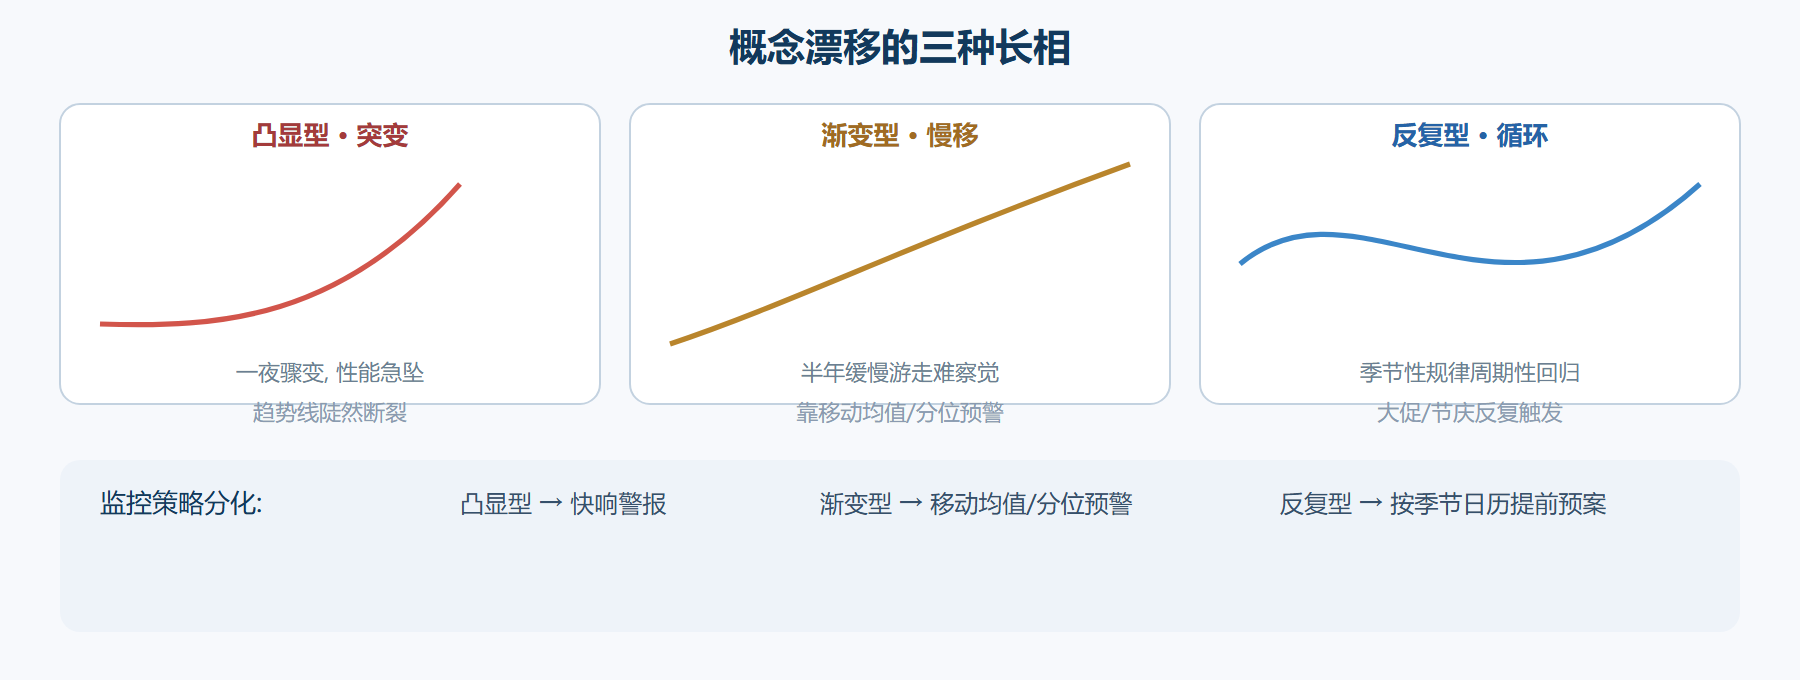
它们分别需要不同的观察节奏与重训策略——不是"看到性能掉就重训"这么一刀切。
三、用两组信号做监控
光等"线上评测掉下来"再反应已太迟,要预先埋哨。两路信号配合:
- 性能信号:真实业务指标(点击、购买、准确率在同一流量上的抽样板)的移动均值/分位数。
- 数据信号:输入特征的分布统计(均值、分位、类别占比)相对基线是否偏移;标签延迟(标签要滞后才知道的,要结合延迟口径看)。
当数据信号先动、性能信号还没反应时,往往还能抢在恶化前介入。把这两类信号落进一块带阈值与告警的仪表盘,是本章监控的核心落地动作。
四、治理循环:观测-触发-重训-回滚
监控不是为了看数字,是为了驱动决策。一套实用的治理循环:
要点:重训不是自动全量重来,而是用诊断确认真是漂移+数据齐了再触发;上流程图先做新旧模型对比(资源含 A/B)再灰度;若新模型表现不对,能回滚到旧版,这是治理的保险栓。
⚠️ 常见坑:重训时拿"新数据"训完就宣布升级,却没做新旧在 sam流上的对照。升级前必须在真实流量上用 A/B 或 shadow 验证新模型不劣化,否则你可能用一个偶然高分的新调参顶掉了稳健的旧版。
💡 直觉:好模型的另一半是"运维"。把每次"监控发现-重训-上线"的触发条件、数据窗口、结果都记进实验流水(呼应第六章实验管理),你就把一次次的"防飘"也变成可审计、可复盘的积累。
五、"漂移确认"不能只靠直觉
监控告警响了,不等于就该立刻重训——得先确认"这究竟是漂移,还是噪声、还是数据管道问题"。常见的误判有两类:一是把周期性噪声当漂移来频繁重训,结果模型被折腾得忽上忽下;二是把数据管道的故障(某列突然取不到值、某接口返空)误当成分布漂移,忙着重训却修错了地方。所以规范的流程是"告警 → 先手动/自动核查 → 再决定动作":看一眼特征分布移动的显著性、看看表现下滑是否一致、排查一下数据采集是否还在正常断点。这一套"先诊断再动手"的纪律,跟你在第八章学到的"先看清是过拟合还是欠拟合再拧旋钮"是同一个心智,只是对象从上线的模型换成了上线的数据流。
六、重训也要带着实验纪律
哪怕确认了漂移、决定重训,也别把它当成一次不用记录的临时操作。重训本身就是一次新的实验,同样该有:明确的时间窗口(用哪一段新数据)、固定的验证协议(与旧模型同一把尺子)、以及新旧在真实流量上的对照(A/B 或 shadow)。特别是"新数据"要按时间切得干净,避免把没发生的"未来"编进训练——这和第一章的时序切分纪律毫无差别。把每次重训当成"一个小号的项目"来对待,好处一清二楚:当线上表现忽好忽坏时,你回看记录能得出"是数据窗口问题,还是模型退化,还是监控阈值设得不合理"的确定结论,而不是在几套模型之间来回猜。治理越有纪律,防漂移就越不是玄学。
最后把"监控阈值怎么定"也想清楚,否则告警会变成"狼来了"。阈值设得太紧,噪声不断触发误告警,你会麻木;设得太松,等真出大事又太晚。一个折中的做法是"分几档动作"而非"一个开关":轻微偏移只记录观察、中等偏移触发复查、明显偏移才自动重训或告警给人工。这样一个分层策略,既避免被噪声淹没,也不至于错过真正的恶化。给每一档都配一个"该做什么"的明确动作,监控系统就不再是"响了又喊不动"的空摆设,而是一套真正能履职的治理工具。
把监控、重训、回滚这一整套串起来看,它本质上是把"模型上线"从一次性的动作,改成了"持续照看 + 带审计的动作流"。所有触发条件、数据窗口、验证结果都进流水,线上模型的健康就不是某几个人拍胸脯的状态,而是一份谁都能查的账。这和你学到的实验记录纪律一脉相承——只不过对象从"练的时候"延展到了"跑起来之后"。能把这半本账管住的团队,才谈得上真正把它当成长期资产,而不是上线完就撒手不管。守住这套"观察-判断-行动-回滚"的循环,你的模型才不会在悄然变化的世界里悄悄失明。
本节要点回顾
- 要点一:概念漂移是上线后性能静默下滑的根源,因分布随时间变化。
- 要点二:三种形态(凸显/渐变/反复)需要不同的观察节奏与重训策略。
- 要点三:用"性能信号 + 数据信号"两路监测,数据信号常先预警。
- 要点四:治理循环=观测-触发重训-灰度对比-必要时回滚。
- 要点五:每次防飘操作都记录进实验流水,让治理也可复现可复盘。
工业级的长效维护就位。最后一章,把这些年踩过的坑、用的心法和一整条端到端案例收拢到实战里。