3.3 Column Family 实战与隔离调参
3.3 Column Family 实战与隔离调参:一库多治的艺术
本节摘要:列族是 RocksDB 里最容易被低估的机制——它不是「给数据贴标签」,而是把一个物理实例划成多个拥有独立内存表、独立层级、独立压缩策略的逻辑引擎。本节用一个多租户内容平台的完整实验,走一遍列族的划分设计、创建、差异化配置与效果验证,最后盘点三个高频踩坑点:共享写缓冲、句柄生命周期、以及「列族不是越多越好」。
从一次互相拖累说起
某内容平台把三类数据塞在同一个默认列族里:用户资料(高频小更新)、内容正文(批量写入、体量大)、关系索引(点查密集、有大量删除)。运行一段时间后出现一个诡异现象:正文回填的夜晚,用户资料的更新延迟翻倍;索引清理的白天,正文读取变慢。 三类数据的压缩任务互相挤占、缓存互相驱逐、写缓冲互相争抢——一个实例变成了三个负载的角斗场。
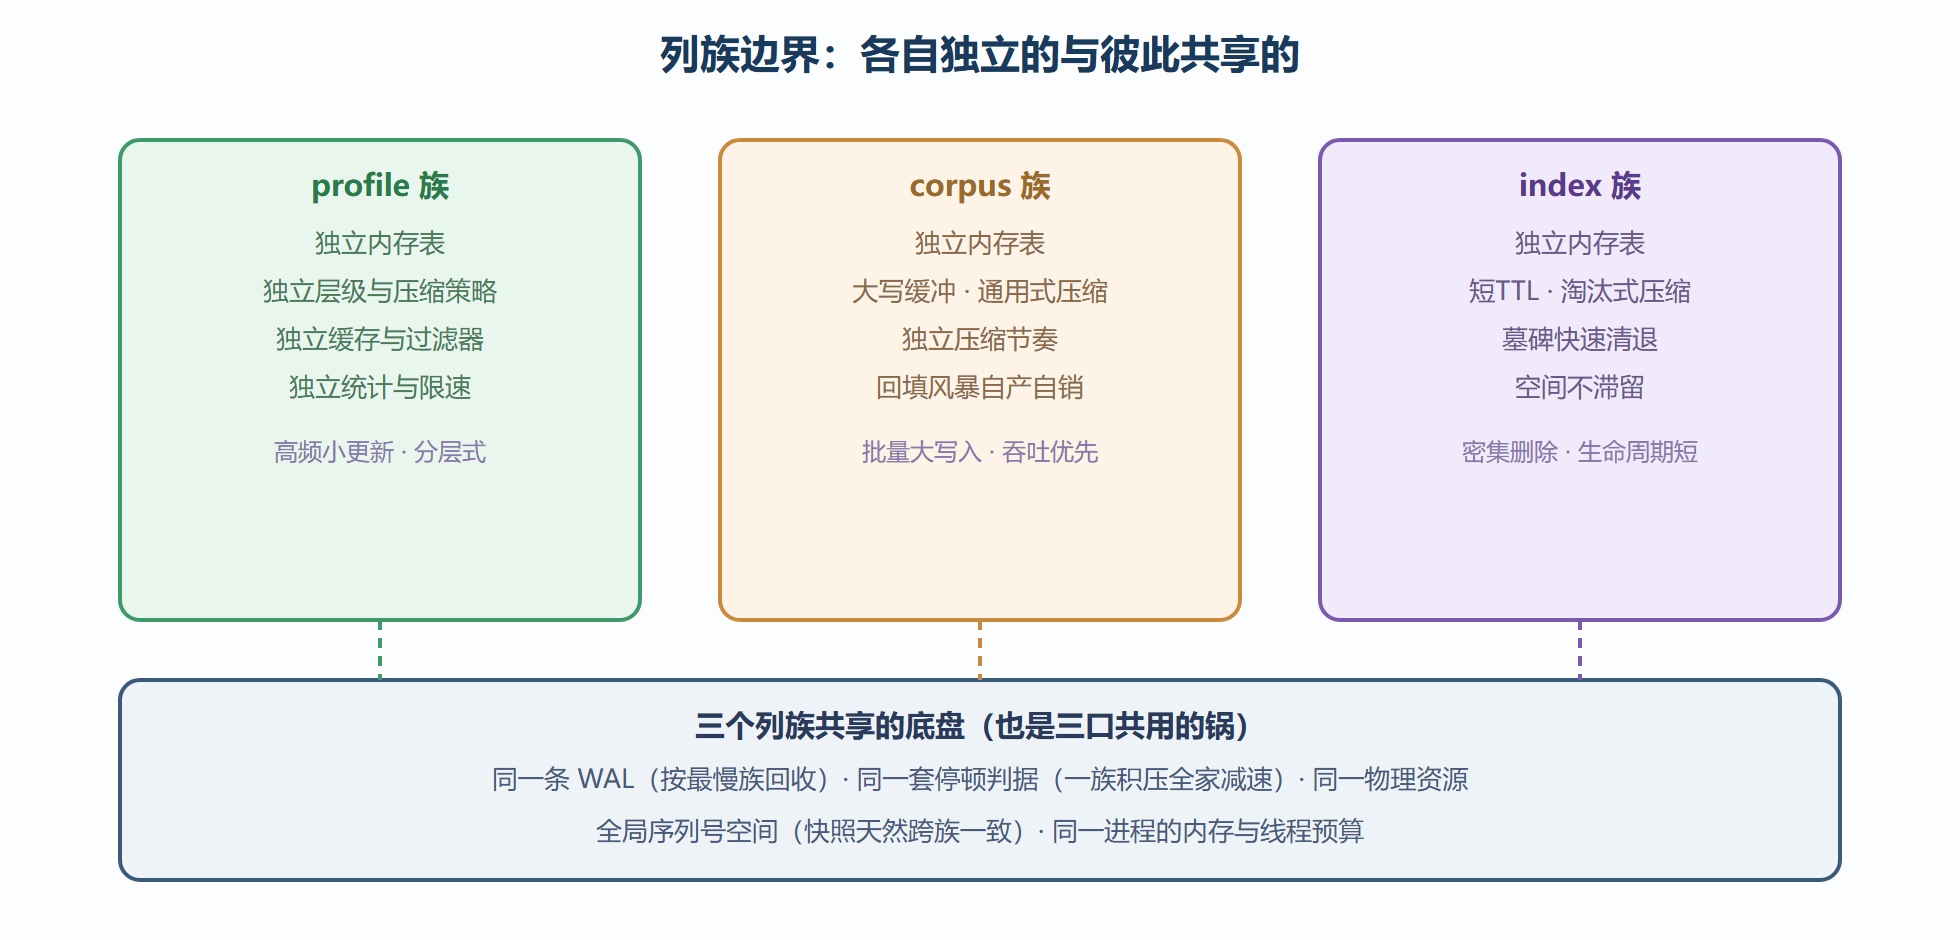
这是列族要解决的标准问题。列族的隔离是引擎级的:每个列族有自己的内存表与冻结队列、自己的层级与压缩策略、自己的缓存与过滤器配置。三类数据划进三个列族后,正文的回填风暴不再冲垮资料的更新路径——因为它们从内存表开始就是两条流水线。但列族共享 WAL 与全局序列号空间,又共享一个物理实例的资源底盘,所以它是「分治」而不是「分家」。
动手实验:三列族的完整搭建
实验目标:为上述三类负载建立三个列族,各自配置压缩策略与写缓冲,并验证隔离效果。整个实验在测试机上十分钟可复现。
第一步:设计与建库。 划分的依据是「访问模式同类才同族」:族内数据应当共享生命周期与性能诉求。三个列族的配置草案如下表。
| 列族 | 负载特征 | 压缩策略 | 写缓冲 | 关键理由 |
|---|---|---|---|---|
| profile | 高频小更新、点查 | 分层式 | 中等 | 层内有序保证点查稳定 |
| corpus | 批量大写入、体量大 | 通用式 | 大 | 摊薄压缩频率,吞吐优先 |
| index | 密集删除、短生命周期 | 淘汰式或短 TTL | 小 | 墓碑快速清退,空间不滞留 |
第二步:代码落地。 创建与打开的完整会话如下:
// 打开时声明三个列族的描述符 ColumnFamilyDescriptor cf_profile("profile", 基础配置()); ColumnFamilyDescriptor cf_corpus("corpus", 大缓冲配置()); ColumnFamilyDescriptor cf_index("index", 短TTL配置()); std::vector<ColumnFamilyDescriptor> cfs = {默认列族描述(), cf_profile, cf_corpus, cf_index}; std::vector<ColumnFamilyHandle*> handles; DB* db; DB::Open(选项, "/tmp/multi_cf", cfs, &handles, &db); // handles[1] 对应 profile,[2] 对应 corpus,[3] 对应 index // 默认列族永远存在且占第 0 号句柄——忘记它是最常见的新手错误 // 写入时指定列族 db->Put(写选项, handles[1], "user:1001", 资料值); db->Put(写选项, handles[2], "doc:90001", 正文值); // 运行时动态调整某个列族的参数,无需重启 db->SetOptions(handles[2], {{"write_buffer_size", "134217728"}});
第三步:验证隔离效果。 灌入混合负载(正文批量回填 + 资料持续更新),对比单列族与三列族两种部署下资料列族的写入延迟曲线:单族部署下回填开始后延迟台阶式上涨,三族部署下资料列族的延迟曲线基本纹丝不动。再看压缩的统计指标——三个列族的压缩读写字节各自记账,正文风暴的账不会再算到资料头上。
隐藏成本一:写缓冲与停顿的连带
列族隔离了大部分东西,但有两样是共用的,第一个就是写停顿的触发条件。全实例的内存表总量、待刷盘数据量、待压缩数据量共同构成停顿判据,任何一个列族的积压都可能触发全实例的写入减速——包括那些无辜的列族。三族部署后仍观察到全局停顿的话,别急着怀疑隔离失效,先看积压指标出自哪个族。
对策有三层。轻则给积压大户单独调参,让它自己消化;中则把「写缓冲总量」按列族预算分配,防止单族吃光内存额度;重则把最重的负载拆成独立实例——列族的边界不是免费的,隔离的极限是进程。
第二个共用物是 WAL。 所有列族的写入流进同一条日志,日志按「所有列族中最小的已刷盘进度」回收。这意味着一个几乎不写的冷列族若长期不刷盘,会拖住整条日志的回收。日志过多时,先排查是不是某个冷族的刷盘条件永远不满足。
隐藏成本二:句柄生命周期
列族句柄是必须显式管理的资源。三个纪律:句柄要保存,每次访问都现查映射表是纯浪费;删除列族要先 Drop 句柄再关闭库,顺序反了句柄泄漏;动态创建的列族要记进自己的服务注册表,否则重启后你不知道它存在——虽然数据还在,但没人再往里写。
一个真实的故障样式:服务在运行期按用户分片动态创建列族,两年后创建了几万个,每个都占着独立的内存表与统计结构,实例的固定内存开销膨胀到配置值的数十倍。列族个数没有硬上限,但每个列族都有固定底价(内存表初始占用、统计结构、后台任务的调度开销),「列族不是越多越好」的边界就在这里:个位数到几十是常态,成百上千就该改用键前缀方案了。
隐藏成本三:跨列族没有事务直觉
单列族内的原子写由写批处理保证,但跨列族的批量写同样是原子的——同一批次里的操作要么全生效要么全不生效,这是很多人不知道的免费午餐。真正的边界在隔离性:没有事务包装时,一个列族的读看不到另一个列族「正在写入但未提交」的中间态吗?能看到——因为快照是全局序列号,跨族一致性读要用同一个快照串起两个族的读取。用对了这个模式,跨族的「读时一致」依然免费;用错了(两次独立读取各拿各的视角),就会读到撕裂的视图。
图3-3 列族的隔离与共享边界
本节要点
- 列族是引擎级隔离:内存表、层级、压缩、缓存各自独立,但 WAL、停顿判据、资源底盘共用;
- 划分依据是「访问模式同类才同族」,每个列族都有固定底价,个数应控制在几十以内;
- 停顿是全局的:一族积压全家减速,排查时先定位积压出自哪个族;
- 日志回收以最慢的族为刻度,冷族长期不刷盘会拖住整条 WAL;
- 句柄纪律三件套:保存、先 Drop 后关、动态创建要登记;
- 跨族批量写依然原子;跨族一致性读要靠同一个快照串起两个族的视角。
至此字节层的契约全部看清。下一章让数据流动起来:写入的完整时序、读取的多层裁决、并发下的秩序。